Entraîner un modèle : gradients, optimiseurs et taux d’apprentissage
L’entraînement transforme des exemples et un objectif en mises à jour des paramètres. Le calcul direct produit les prédictions, la perte mesure leur écart aux cibles, la rétropropagation calcule les dérivées, puis l’optimiseur utilise ces dérivées. Ces rôles sont distincts : remplacer Adam par SGD ne change pas le sens des étiquettes et ne corrige pas des étiquettes erronées.
Le chapitre sur l’optimisation de Deep Learning distingue la minimisation de l’objectif d’entraînement de l’apprentissage d’un prédicteur qui généralise. La perte d’entraînement dirige les mises à jour ; la validation indique si elles restent utiles sur des exemples inconnus.
Calculer une mise à jour
Prenons le modèle sans constante et les observations fictives . Utilisons la moitié de l’erreur quadratique moyenne :
À , la perte vaut et le gradient . Avec , la mise à jour donne et une perte de . Le gradient négatif indique qu’augmenter le poids réduit localement l’erreur ; une augmentation arbitrairement grande peut toutefois l’aggraver.
Ici, . L’écart à l’optimum satisfait :
Il diminue uniquement pour . À , il oscille avec une amplitude constante ; au-delà, il diverge. Ce seuil appartient à cet exemple quadratique, pas aux réseaux neuronaux en général.
x, y = [1.0, 2.0], [2.0, 4.0]
w, learning_rate = 0.0, 0.1
for step in range(50):
    gradient = sum((w * a - b) * a for a, b in zip(x, y)) / len(x)
    w -= learning_rate * gradient
loss = sum((w * a - b) ** 2 for a, b in zip(x, y)) / (2 * len(x))
assert abs(w - 2.0) < 2e-6
print(round(w, 6), round(loss, 10))
Cet exemple utilise seulement la bibliothèque standard. Il illustre le calcul, sans jeu de test ni mesure de généralisation. Pour un modèle avec constante et une expérience visuelle, voir la régression linéaire.
Pourquoi travailler par lots
Un gradient complet parcourt toutes les observations avant chaque mise à jour. Un mini-lot l’estime à partir d’un sous-ensemble. Avec un échantillonnage aléatoire approprié et une perte moyenne par exemple, cette estimation vise le gradient complet ; les paramètres changent néanmoins entre les mises à jour et les directions restent bruitées. Dive into Deep Learning explique ce point de vue stochastique.
Un step est une mise à jour de l’optimiseur ; une époque correspond à un parcours du jeu d’entraînement. Avec 1 000 exemples et des lots de 100, une époque comporte généralement 10 mises à jour. Accumuler quatre mini-lots avant d’actualiser les paramètres modifie ce nombre et la taille effective du lot. Il faut conserver une normalisation cohérente : additionner quatre pertes déjà moyennées sans diviser par quatre multiplie le gradient par quatre. Des couches dépendant du lot ou des opérations aléatoires peuvent aussi empêcher l’équivalence avec un seul grand lot.
Des lots plus grands peuvent mieux utiliser le matériel, mais demandent davantage de mémoire d’activation et produisent moins de mises à jour par parcours. Comparer seulement le nombre d’époques masque ces différences. Suivre également les exemples ou tokens traités, les mises à jour, le temps et la qualité.
Ce que conserve l’optimiseur
SGD utilise le gradient courant. Le momentum conserve aussi une direction moyenne des étapes précédentes, ce qui peut réduire les oscillations. Adam estime les premier et deuxième moments des gradients pour adapter les mises à jour. Ces états occupent de la mémoire : un modèle qui tient en mémoire pour l’inférence peut ne plus y tenir avec gradients, états d’optimisation et activations nécessaires au calcul arrière.
 Voir l’image en grand
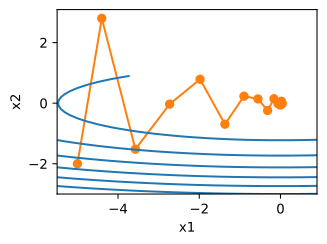
Les courbes bleues relient les points de même perte ; les points orange sont les paramètres après chaque mise à jour. Cet exemple distinct à deux dimensions utilise f(x₁,x₂) = 0,1x₁² + 2x₂², un taux de 0,6 et un coefficient de momentum de 0,5. Les oscillations verticales diminuent à l’approche de (0, 0). Avec le même taux et le même objectif, la descente de gradient ordinaire diverge. Les gradients sont déterministes : les oscillations ne viennent pas de mini-lots et ne représentent pas le cas scalaire w précédent.
Chaque optimiseur part du cercle en pointillé et fait 100 pas avec le même taux d’apprentissage η. Les lignes grises relient les points de même perte ; ✕ marque le minimum.
f(x, y) = 0.1x² + 2y²Cliquez ou touchez le graphique pour partir d’un autre point.
| Optimiseur | (x, y) | perte | longueur du dernier pas |
|---|---|---|---|
| SGD | (−0.001, −1.3 × 10⁻²²) | 1.4 × 10⁻⁷ | 1.0 × 10⁻⁴ |
| Momentum | (−8.0 × 10⁻¹¹, −2.6 × 10⁻¹⁶) | 6.5 × 10⁻²² | 2.3 × 10⁻¹¹ |
| Adam | (0.021, 0.009) | 2.1 × 10⁻⁴ | 0.002 |
pas 100: SGD perte 1.4 × 10⁻⁷; Momentum perte 6.5 × 10⁻²²; Adam perte 2.1 × 10⁻⁴
Selon y, la courbure vaut λ = 4 : chaque pas de SGD multiplie l’erreur en y par 1 − ηλ, de taille 0.6 ici. Tant que η reste sous 2/λ = 0.5, cette taille est inférieure à 1 et SGD se stabilise, en zigzag quand le facteur est négatif. Avec β = 0.5, le momentum reste stable tant que ηλ < 2(1 + β), soit ici η < 0.75. Le momentum ajoute 0.5 du pas précédent à chaque nouveau pas ; il prend donc de la vitesse au fond de la vallée. Adam divise chaque coordonnée par une taille moyenne glissante de son gradient : ses pas restent proches de η quelle que soit la pente. Il ne s’emballe pas, mais avec un petit η il est lent.
Illustration : gradients exacts d’une fonction de deux variables, avec les règles de mise à jour de PyTorch (momentum 0.5, Adam β₁ = 0.9, β₂ = 0.999). Un vrai entraînement ajoute le bruit des mini-lots et compte bien plus de dimensions.
La définition d’AdamW dans PyTorch sépare la décroissance des poids de la mise à jour adaptative. Dans le PyTorch actuel, AdamW n’est autre qu’Adam avec decoupled_weight_decay=True ; les deux écritures sont équivalentes. Ajouter une pénalité L2 à la perte et régler le weight decay d’AdamW ne sont donc généralement pas interchangeables. Préciser la convention avant de réutiliser un coefficient de régularisation.
Aucun optimiseur ne fournit un taux d’apprentissage universel. L’échelle des entrées, l’initialisation, les lots et la normalisation de la perte changent la plage utile. Un warmup augmente progressivement le taux au début ; un calendrier de décroissance le réduit ensuite. Ces mécanismes règlent l’amplitude des mises à jour, sans prouver que la tâche est apprise.
Combien de mémoire demande le fine-tuning d’un modèle de 7 milliards de paramètres
L’entraînement garde quatre choses en mémoire GPU : les poids, leurs gradients, l’état de l’optimiseur et les activations dont la rétropropagation a besoin. Faisons le calcul pour un modèle de 7 milliards de paramètres. Les poids en bf16 prennent 2 octets par paramètre, soit 14 Go ; les gradients, encore 14 Go ; Adam conserve un premier et un second moment pour chaque paramètre, 8 octets en fp32, soit 56 Go. Le fine-tuning complet demande donc 84 Go avant toute activation, et beaucoup de configurations en précision mixte gardent en plus une copie maîtresse des poids en fp32, soit 28 Go de plus.
LoRA gèle les poids d’origine et n’entraîne qu’un petit ensemble de paramètres d’adaptateur. Supposons des adaptateurs de 40 millions de paramètres, environ 0,6 %. Avec les adaptateurs et leurs gradients en bf16 et les deux moments d’Adam en fp32, gradients et état de l’optimiseur tiennent en moins de 0,5 Go. Les poids gelés doivent toujours résider en mémoire : le terme de 14 Go reste. QLoRA stocke ensuite ces poids gelés sur 4 bits, environ un demi-octet par paramètre, ce qui ramène 14 Go à environ 3,5 Go plus quelques constantes de quantification ; les gradients traversent ce modèle gelé en 4 bits et ne mettent à jour que les adaptateurs. L’article s’en sert pour affiner un modèle de 65 milliards de paramètres sur un seul GPU de 48 Go.
Ni LoRA ni QLoRA ne suppriment le terme des activations. Le gradient doit remonter de la perte jusqu’aux adaptateurs des premières couches, et chaque couche traversée a besoin des résultats intermédiaires calculés lors de la passe avant. Ces résultats croissent avec la taille du lot et la longueur des séquences : à taille de lot égale, passer de 512 à 4 096 tokens par séquence multiplie la mémoire des activations par au moins 8. Quand la mémoire manque, raccourcissez d’abord les séquences ou réduisez le lot, puis compensez par l’accumulation de gradients pour retrouver la taille de lot effective. Si cela ne suffit pas, activez le checkpointing des activations : il jette les résultats intermédiaires pendant la passe avant et les recalcule pendant la passe arrière, en échangeant du calcul contre de la mémoire.
Interpréter les échecs
Si les pertes d’entraînement et de validation restent élevées, essayer d’abord d’ajuster un petit sous-ensemble propre. Un échec suggère une cible incorrecte, un gradient interrompu, un objectif inadapté ou un mauvais pas. Si ce sous-ensemble est appris mais pas les données complètes, la capacité et le budget d’optimisation deviennent des explications plausibles.
Si l’entraînement progresse tandis que la validation se dégrade, les nouvelles mises à jour ajustent des distinctions qui se transfèrent mal. Vérifier les doublons et les groupes répartis entre jeux avant de modifier la régularisation. Choisir arrêt et hyperparamètres sur la validation ; consulter le test après chaque essai en fait un autre jeu de validation. Voir séparation des données et fuites.
Des pertes non finies demandent de vérifier entrées, divisions, exponentielles, normes des gradients et précision numérique. L’écrêtage peut limiter la norme du gradient, mais ne répare ni les mauvaises étiquettes ni les valeurs manquantes. Une perte immobile peut aussi venir de gradients effacés trop tard ou accumulés involontairement entre étapes.
Reprendre le même entraînement
Sauvegarder les poids suffit pour réutiliser le prédicteur. Reprendre la même trajectoire nécessite aussi les états de l’optimiseur et du calendrier, le compteur de mises à jour et les états pertinents du hasard et du chargement des données. Avec les mêmes poids mais un momentum réinitialisé, l’étape suivante peut changer. Conserver également prétraitement et définition des étiquettes pour que le modèle restauré reçoive la même représentation des entrées.
Le préentraînement et le post-entraînement expliquent ensuite d’où viennent les objectifs ; LoRA et la distillation expliquent quels paramètres, ou quel modèle, doivent apprendre.