Activations et réseaux feed-forward à portes
Empilez plusieurs transformations linéaires : le résultat reste une seule transformation linéaire. Sans fonction d’activation, un réseau profond ne vaut donc pas plus qu’une couche (voir le perceptron multicouche). L’activation, placée entre deux couches, décide comment chaque unité courbe son entrée ; c’est ce qui permet au réseau d’ajuster des courbes et des frontières.
Les Transformers modernes ajoutent un changement plus profond : ils scindent le réseau feed-forward (FFN) en deux branches qu’ils multiplient. Une branche calcule le contenu, l’autre décide quelle part de ce contenu passe, et cette part change avec chaque token.
Cette page étudie la non-linéarité et le mélange des canaux à une position ; l’attention échange l’information entre positions. Une porte FFN multiplie des valeurs de canaux, tandis que le routage MoE choisit des réseaux experts pour les tokens ; les deux peuvent coexister. Le processus d’entraînement explique l’actualisation des paramètres par la perte ; le choix d’une sigmoïde ou d’un Softmax en sortie dépend de la tâche, comme le montre la section sur la tête de sortie du perceptron multicouche.
L’activation élément par élément décide comment chaque unité courbe son entrée
Dans le tableau, . est la fonction de répartition de la loi normale standard, c’est-à-dire la probabilité qu’une variable normale standard ne dépasse pas ; GELU multiplie donc par un facteur compris entre 0 et 1 qui croît avec . GELU exacte utilise ; l’expression usuelle en tanh en est une approximation, et différents kernels peuvent produire de petits écarts en précision mixte.
Deux conventions de nom et de notation doivent aussi être précisées. L’article sur Swish étudie un qui peut être appris, alors que le SiLU des frameworks fixe couramment ; les articles emploient ces noms de manière quasi interchangeable, précisez donc l’implémentation. La forme du tableau suppose ; sans cette restriction, PReLU est définie par morceaux : pour une entrée non négative, sinon.
Pour SiLU, . En zéro, ReLU, GELU et SiLU donnent zéro, mais GELU et SiLU ont une dérivée de ; ReLU n’y possède pas de dérivée unique (l’implémentation choisit une convention). En , SiLU vaut environ et sa dérivée environ . Employée comme porte, SiLU ne reste donc pas dans : elle peut passer légèrement sous zéro ou dépasser un.
 Voir l’image en grand
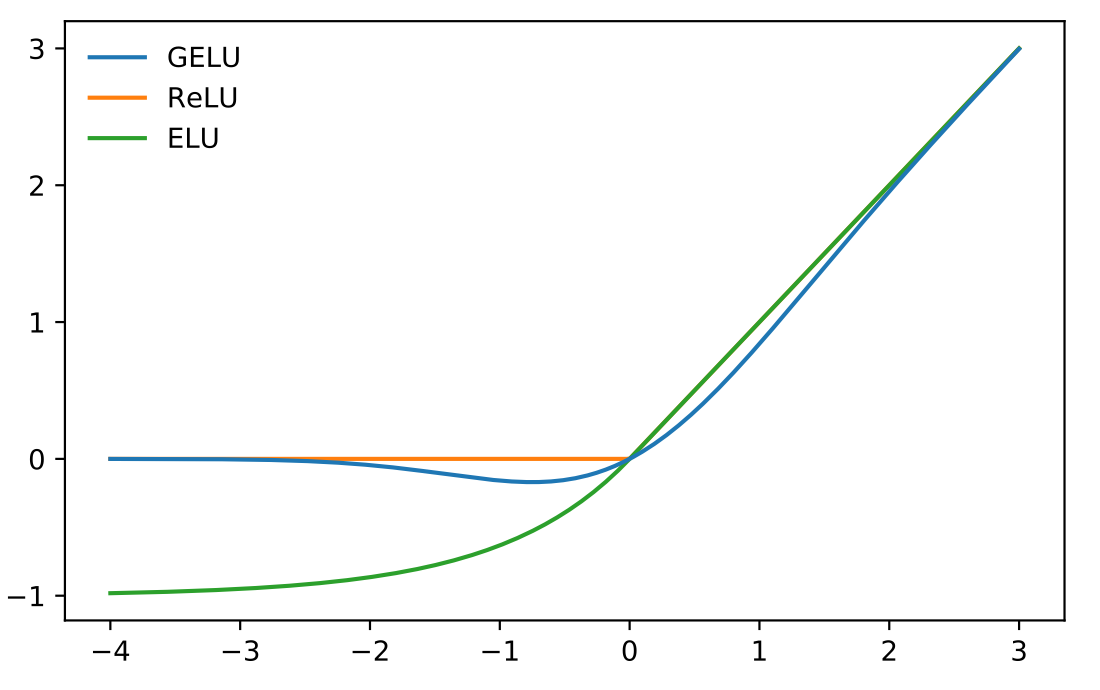
Regardez les entrées négatives : ReLU vaut zéro, GELU passe sous zéro puis s’en rapproche pour des entrées très négatives, tandis qu’ELU avec α = 1 tend vers −1. Le bleu représente GELU standard.
Dans un FFN à portes, une branche décide de ce que l’autre laisse passer
Un FFN classique de Transformer projette le vecteur d’un token vers une couche intermédiaire plus large avec , applique une activation , puis revient à la largeur initiale avec :
Une unité linéaire à porte (GLU) multiplie deux projections : fournit le contenu, une proportion de passage comprise entre 0 et 1, et désigne le produit élément par élément. Sous une forme simplifiée :
Les variantes courantes dans les Transformers incluent
Ici produit la branche de porte et la branche de valeur ; leur produit élément par élément est ramené à la largeur du modèle par . ReGLU remplace la fonction par ReLU dans la branche de porte.
Suivons SwiGLU sur un token. Prenons une couche intermédiaire de deux canaux seulement, une branche de porte et une branche de valeur . Après SiLU, la porte vaut environ , car et . Le produit élément par élément donne : le premier canal est amplifié, le second presque fermé.
Prenons un autre token dont la branche de porte vaut , avec la même branche de valeur . La porte devient environ et le produit environ : cette fois, le premier canal est fermé et le second ouvert.
La porte étant calculée à partir de l’entrée, un même canal peut s’ouvrir pour un token et se fermer pour un autre. Dans un FFN simple, la part qu’un canal laisse passer et ce qu’il produit sont un seul et même nombre : après ReLU, il renvoie tel quel sa composante de , ou zéro. Un FFN à portes confie ces deux rôles à deux projections, l’une décidant combien passe, l’autre ce qui passe ; la sortie est le produit de deux grandeurs qui varient toutes deux avec l’entrée.
Une couche à portes comporte trois projections principales (, , ), contre une projection d’entrée et une de sortie pour le FFN simple ; à largeur intermédiaire identique, les paramètres et le calcul augmentent. Les comparaisons à nombre de paramètres égal réduisent donc la largeur intermédiaire de la couche à portes.
Un FFN simple sans biais allant de la largeur à via une largeur contient poids ; un FFN à portes de largeur intermédiaire en contient ; l’égalité donne . C’est la comparaison locale du nombre de paramètres de GLU Variants Improve Transformer.
Pour , choisissez . Les projections de porte et de valeur vont chacune de 6 à 8 caractéristiques ; leur produit élément par élément reste de longueur 8, puis la projection de sortie revient à 6. Le FFN simple a poids et le FFN à portes : 144 dans les deux cas.
Quand vous téléchargez un modèle, cette largeur intermédiaire est le champ intermediate_size de son config.json Hugging Face. La configuration de Qwen3-8B indique hidden_size: 4096, intermediate_size: 12288 et hidden_act: "silu", et son index des poids montre trois matrices FFN par couche, gate_proj, up_proj et down_proj, soit ici , et . Le FFN de chaque couche compte donc millions de poids. En remontant par , c’est autant qu’un FFN simple de largeur intermédiaire 18432.
Exemples dans les architectures modernes
- L’architecture originale de BERT utilise GELU.
- PaLM indique utiliser SwiGLU.
- Le rapport d’architecture de Llama 3 utilise aussi SwiGLU, avec RMSNorm, RoPE et GQA dans un bloc complet.
- ConvNeXt montre que les ConvNets modernes peuvent aussi utiliser GELU ; les activations lisses servent au-delà des Transformers.
Comparer les activations à budget égal
Aucune activation n’arrive en tête sur toutes les tâches. Une meilleure moyenne dans un article, comme le choix de GELU ou de SwiGLU par les modèles ci-dessus, vaut pour leur échelle, leur modalité et leur matériel. Le bénéfice reste aussi mêlé à l’initialisation, à la normalisation, à la largeur, aux données et aux kernels fusionnés ; lorsque plusieurs composants d’une architecture changent ensemble, il ne peut pas être attribué entièrement à l’activation.
Pour changer d’activation, fixez donc d’abord le découpage des données, l’optimiseur, le nombre de pas et les graines aléatoires. Indiquez ensuite la largeur intermédiaire, le total des paramètres et le pic mémoire. n’est qu’un comptage de poids sans biais, et deux FFN de même nombre de paramètres peuvent avoir des latences mesurées très différentes. Mesurez donc aussi le débit de bout en bout avec le dtype et le matériel cibles : une nouvelle fonction sans kernel fusionné est plus lente, et la quantification la dégrade quand sa plage numérique change.
Si beaucoup d’unités restent à zéro ou si les gradients deviennent quasi nuls pendant l’entraînement, cherchez d’abord des ReLU mortes et une saturation de Sigmoid/Tanh. Gardez une référence stable avec ReLU : elle montre si le bénéfice d’une porte vient seulement de paramètres supplémentaires.