Regroupement et réduction de dimension
Le regroupement cherche quelles observations rapprocher selon une similarité choisie. La réduction de dimension cherche une représentation avec moins de coordonnées. Ces opérations peuvent se combiner, mais si nets que soient les groupes obtenus, rien ne garantit qu’ils correspondent aux catégories qui vous intéressent.
Regrouper des vecteurs documentaires aide par exemple à explorer des thèmes ; les réduire à deux coordonnées permet de les afficher. Les amas visibles sur la figure peuvent être séparés par langue, par longueur ou par site source, et seulement par chance par le thème qui vous intéresse. Pour savoir lequel, il faut revenir aux documents.
La distance fait partie du modèle
Avec une durée en secondes et une note de un à cinq, un écart de 100 secondes peut dominer deux points de note dans la distance euclidienne brute. Standardiser change cette géométrie sans révéler une distance universellement correcte. Choisir l’échelle selon la comparaison visée et estimer ses statistiques sur les données d’ajustement.
Pour deux vecteurs de norme un :
Autrement dit, plus deux vecteurs unitaires se ressemblent (plus est grand), plus leur distance euclidienne est faible : classer les voisins par distance euclidienne donne alors le même ordre que la similarité cosinus. Des vecteurs non normalisés ne vérifient pas cette identité. Même si toutes les observations sont normalisées, K-means avec la distance euclidienne peut encore regrouper autrement qu’avec le cosinus : un centre de K-means est la moyenne de plusieurs vecteurs unitaires, sa norme est en général inférieure à 1, il n’est pas sur la sphère unité et l’identité ne s’applique pas à lui. Voir embeddings, rerankers et classifieurs.
K-means alterne affectation et moyenne
K-means minimise la somme des distances quadratiques de chaque observation au centre de son groupe. Une itération affecte chaque point au centre le plus proche, puis remplace chaque centre par la moyenne du groupe. La convergence peut être locale, donc l’initialisation importe.
Pour les données fictives et les centres initiaux 0 et 10, les groupes sont et . Les centres deviennent et , avec une somme quadratique de . Un seul groupe aurait pour centre 5 et pour somme . Ajouter des groupes réduit l’objectif sans nécessairement enrichir l’interprétation.
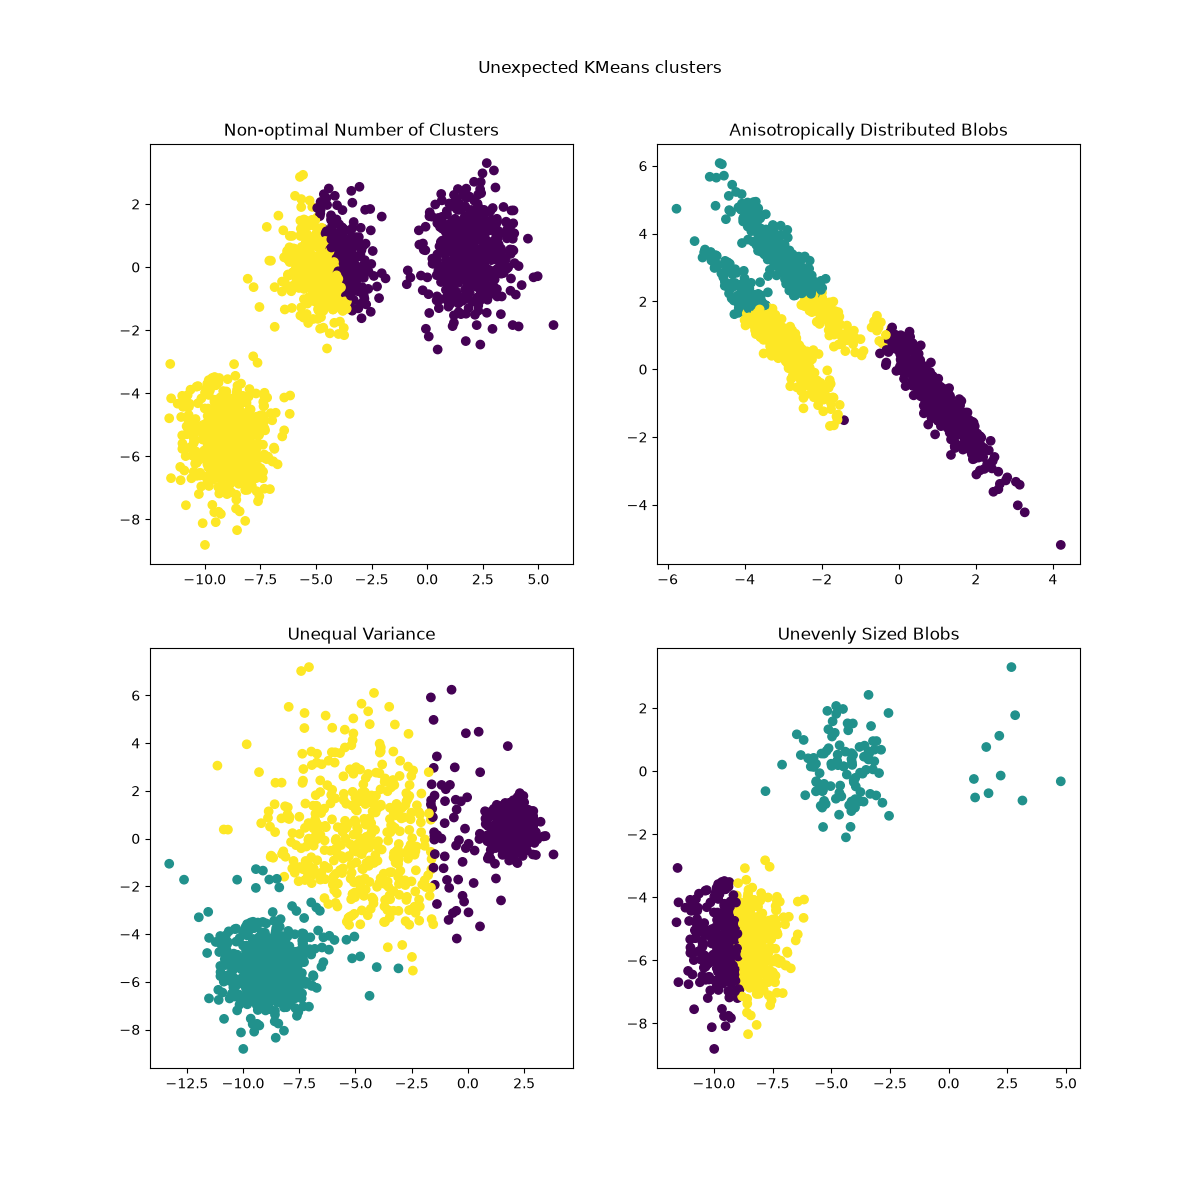
K-means préfère des groupes compacts autour de moyennes et demande à l’avance. Densités inégales, formes allongées, valeurs aberrantes et mauvaise distance peuvent tromper. DBSCAN relie plutôt des voisinages denses et peut laisser des points comme bruit, mais son échelle de voisinage reste un choix important. Le regroupement hiérarchique produit des fusions imbriquées dont la règle de liaison définit la proximité entre groupes.
 Voir l’image en grand
Les couleurs indiquent les groupes trouvés par K-means. L’allongement, la dispersion et les tailles inégales peuvent conduire le critère de distance à couper les groupes attendus. Les panneaux montrent des cas distincts, pas quatre vues du même jeu de données.
L’ACP conserve la variation, pas les étiquettes
L’analyse en composantes principales (ACP, ou PCA) trouve des directions orthogonales de variation dans les données centrées. Conserver les premières fournit une représentation linéaire réduite et une reconstruction des coordonnées initiales, sans consulter les classes.
Pour , la moyenne est et les points centrés sont . La direction principale est :
Les projections sont . Multiplier chaque scalaire par puis ajouter la moyenne reconstruit exactement les points. La direction perpendiculaire ne varie pas. Une coordonnée suffit ici parce que les données construites sont alignées.
Pour un cas à deux valeurs singulières non nulles, Valeurs propres et SVD calcule les scores des composantes, la variance expliquée et l’erreur de reconstruction.
Un autre jeu de données montre l’ACP jeter ce qui compte. Supposons que chaque document ait deux caractéristiques : la longueur, qui va de 200 à 20 000 caractères, et le « recouvrement avec les documents déjà enregistrés », qui ne va que de 0,9 à 1. Sans standardisation, les deux étendues diffèrent d’un facteur 19 800 ÷ 0,1 = 198 000, et les variances bien davantage. L’ACP ne regarde que la variance : la première composante est presque entièrement la longueur, et la direction du recouvrement, classée dernière, est supprimée, alors que c’est justement elle qui dit si un document est un doublon. Une forte variance expliquée ne signifie donc pas que l’information utile à la tâche a été conservée ; on compare le modèle final avec et sans réduction sur les mêmes exemples réservés.
Une figure en deux dimensions reste une vue
Des méthodes non linéaires comme t-SNE privilégient certaines relations de voisinage plutôt que toutes les distances globales. Un grand vide ou un petit groupe apparent peut être produit par les réglages et l’initialisation. De même, l’aire qu’occupe une classe sur la figure ne dit rien de sa fréquence réelle.
Pour explorer, conserver les vecteurs et identifiants originaux, produire la vue, puis inspecter des points au centre et aux frontières des groupes. Vérifier la stabilité face à des changements raisonnables de prétraitement ou d’échantillonnage. Si les couleurs viennent d’étiquettes connues, préciser qu’elles proviennent d’étiquettes humaines, et non de catégories sémantiques découvertes par l’algorithme.
Évaluer sans étiquettes
Un score interne comme la silhouette compare distances internes et externes avec la métrique choisie. Il peut favoriser une géométrie sans intérêt pour l’usage. Pour une collection documentaire, vérifier aussi si les lecteurs trouvent mieux les contenus et si des exemples représentatifs expliquent les groupes.
Avec des étiquettes de référence, une mesure d’accord externe peut comparer deux partitions, par exemple l’indice de Rand ajusté (ARI) : il regarde seulement si les deux partitions placent les mêmes observations ensemble, quel que soit le numéro, 1 ou 2, donné à chaque groupe. Un désaccord peut toutefois correspondre à une autre partition utile : langue au lieu de thème. Définir la distinction recherchée avant de juger le résultat.
Pour une prédiction ultérieure, ajuster normalisation et ACP uniquement sur l’entraînement, puis transformer validation et test. Une ACP ajustée avant la séparation apprend déjà la distribution d’évaluation. Pour décrire toute une collection, l’utiliser entière peut être intentionnel ; la figure ne constitue alors pas un test prédictif indépendant.
Une fois des étiquettes fiables obtenues, un classifieur supervisé ou un arbre peut apprendre directement la distinction. Attribuer un numéro à un groupe ne suffit pas à valider une étiquette décisionnelle.
Le clustering a aussi un usage direct avant d’étiqueter un jeu d’évaluation : transformer ses propres prompts ou journaux en vecteurs, puis les regrouper. On garde un seul exemple par groupe de quasi-doublons, puis on tire quelques exemples de chaque cluster à étiqueter. Quelques dizaines d’étiquettes couvrent alors plus de types de requêtes, et les quasi-doublons ne se retrouvent pas à la fois dans l’ensemble de réglage et dans l’ensemble de test ; voir la ligne « doublons » du tableau dans Découpage des données et fuite.
Dans How to Use t-SNE Effectively, faire varier la perplexité et le nombre d’itérations sur les mêmes données. Comparer la taille et l’écart des groupes avant d’interpréter une projection : un îlot visuellement distinct ne correspond pas nécessairement à un groupe stable et séparé dans l’espace initial.