Lire « Attention Is All You Need » : l’article original du Transformer
En 2017, Vaswani et sept coauteurs, pour la plupart alors chez Google Brain ou Google Research, publient Attention Is All You Need et présentent le Transformer. L’article porte sur la traduction automatique, et son modèle est un encodeur–décodeur ; la plupart des grands modèles de langage actuels n’en conservent que la moitié décodeur. Ce contexte facilite la lecture : les auteurs se demandaient si un modèle de traduction pouvait se passer entièrement de récurrence et de convolution, pas comment construire un modèle conversationnel.
La suite reprend l’ordre de l’article. Les numéros de section, de tableau et d’équation renvoient à la version 7 sur arXiv. Les exemples chiffrés de l’attention elle-même se trouvent dans Mécanisme d'attention ; les composants modernes comme RMSNorm, RoPE, GQA et SwiGLU sont traités dans Transformers : architecture originale et blocs modernes et ne sont pas repris ici.
Le problème de 2017 : la récurrence fait attendre l’entraînement
La section 1 part de l’état de l’art de l’époque : les réseaux récurrents, LSTM et GRU en tête, dominaient la modélisation du langage et la traduction automatique. Un modèle récurrent calcule position après position : l’état caché dépend de et de l’entrée à la position . Les auteurs soulignent que ce calcul intrinsèquement séquentiel empêche toute parallélisation au sein d’un exemple d’entraînement. Le problème s’aggrave avec la longueur des séquences, puisque la mémoire limite aussi le nombre d’exemples par lot. Les astuces de factorisation et le calcul conditionnel avaient amélioré l’efficacité, mais la contrainte fondamentale du calcul séquentiel demeurait.
L’attention faisait déjà partie des modèles de traduction. Elle relie directement deux positions quelle que soit leur distance, mais on l’employait presque toujours avec un réseau récurrent. L’article propose de supprimer complètement la récurrence et de s’appuyer uniquement sur l’attention pour établir des dépendances globales entre l’entrée et la sortie.
La section 2 situe le Transformer par rapport à une autre famille de modèles qui réduisait déjà le calcul séquentiel. L’Extended Neural GPU, ByteNet et ConvS2S utilisent des convolutions pour calculer en parallèle les représentations de toutes les positions. Dans ces modèles, cependant, le nombre d’opérations nécessaires pour relier deux positions quelconques croît avec leur distance, linéairement pour ConvS2S et logarithmiquement pour ByteNet, ce qui rend les dépendances lointaines plus difficiles à apprendre. Le Transformer ramène ce nombre à une constante. Les auteurs en indiquent aussi le prix : moyenner les positions pondérées par l’attention réduit la « résolution effective », et c’est ce que l’attention multi-têtes doit compenser.
L’article vise donc deux choses à la fois : la part de l’entraînement qui peut s’exécuter en parallèle, et la longueur du chemin qu’un signal doit parcourir entre deux positions éloignées. Le tableau 1 de la section 4 exprime ces deux points en termes de complexité.
L’architecture telle que l’article la définit
La section 3 reprend le cadre général des modèles de transduction de séquences. L’encodeur transforme une séquence de symboles d’entrée en représentations continues . À partir de , le décodeur produit une séquence de sortie symbole par symbole. Chaque étape est autorégressive : les symboles déjà produits servent d’entrée supplémentaire pour générer le suivant.
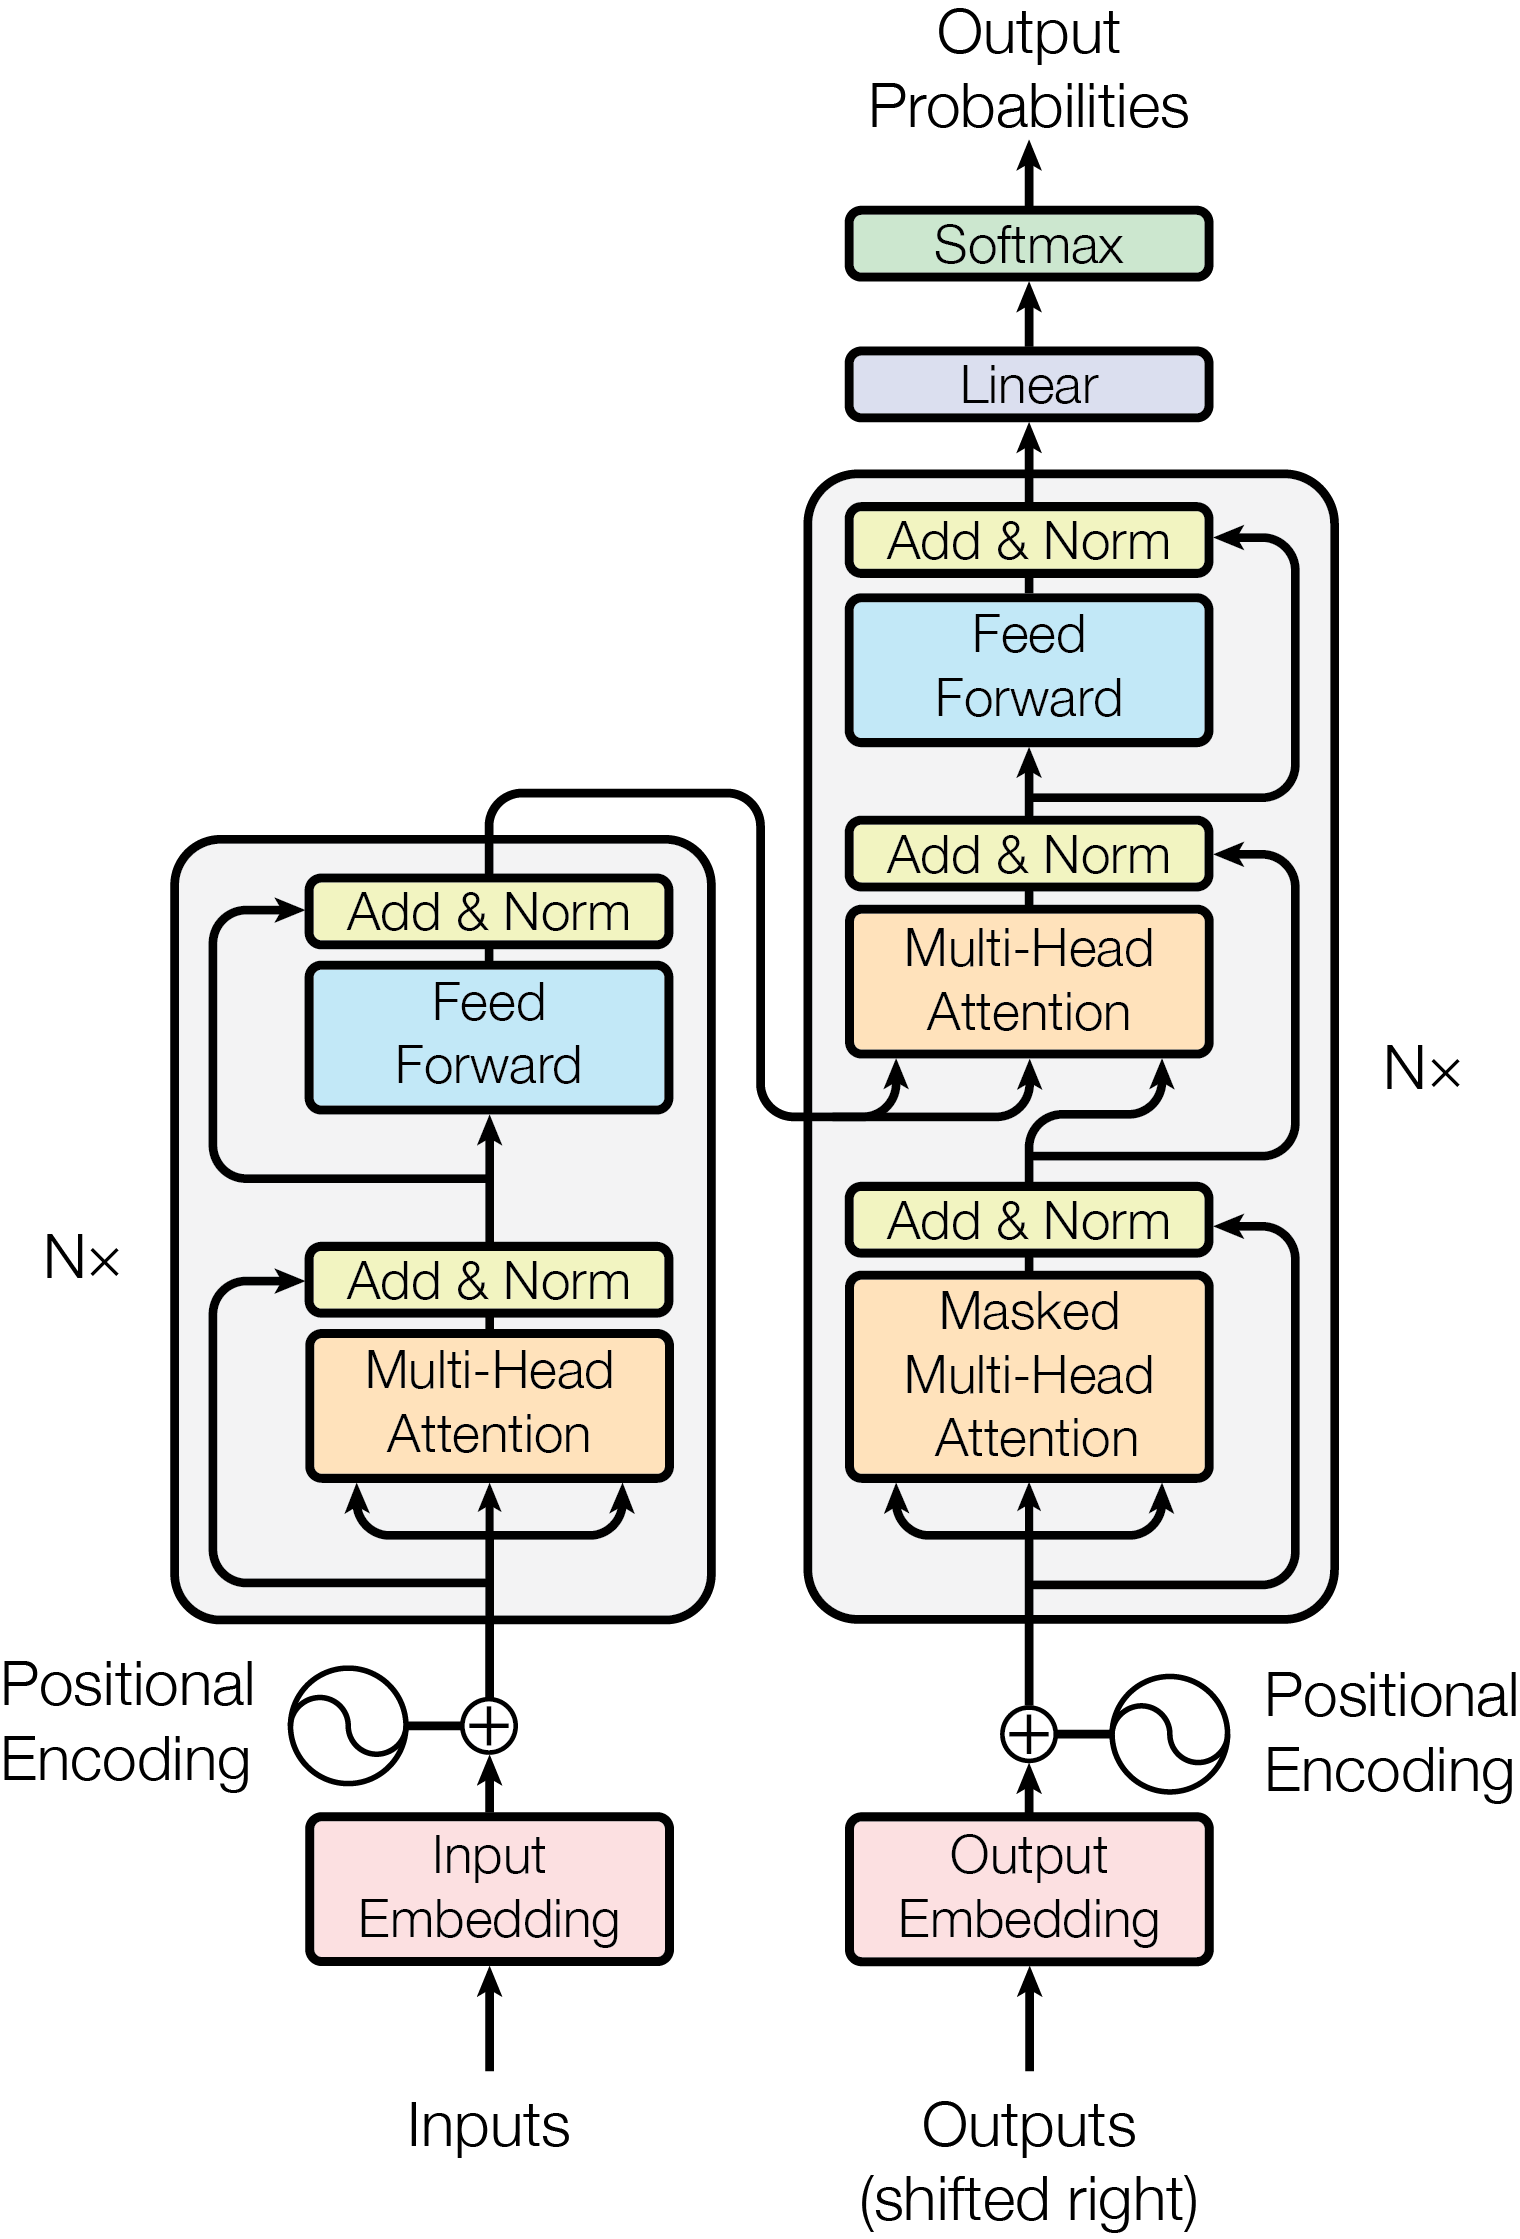 Voir l’image en grand
L’encodeur est à gauche, le décodeur à droite ; le N× à côté de chaque pile signifie que la même couche est répétée fois. Les flèches qui contournent chaque sous-couche sont des connexions résiduelles, et « Add & Norm » signifie qu’on additionne d’abord, puis qu’on applique la normalisation de couche. Des trois entrées de la sous-couche d’attention centrale du décodeur, deux viennent de la sortie de l’encodeur et une du décodeur lui-même.
La section 3.1 décrit les deux piles. L’encodeur compte couches identiques, chacune formée de deux sous-couches : une auto-attention multi-têtes et un réseau feed-forward entièrement connecté appliqué position par position. Le décodeur compte lui aussi couches et ajoute une troisième sous-couche, qui applique une attention multi-têtes à la sortie de la pile d’encodeurs.
Chaque sous-couche est entourée d’une connexion résiduelle suivie d’une normalisation de couche ; la sortie d’une sous-couche vaut donc
La normalisation vient après l’addition résiduelle, un ordre qu’on appellera plus tard Post-Norm. Pour que ces additions soient possibles, toutes les sous-couches et les deux couches d’embedding produisent des sorties de dimension .
L’auto-attention du décodeur est masquée pour qu’une position ne puisse pas regarder les positions suivantes. Combiné au décalage d’une position des embeddings de sortie, ce masque garantit que la prédiction pour la position ne dépend que des sorties connues aux positions inférieures à . Pour apprendre au modèle à produire [A, B, EOS], par exemple, on donne au décodeur [BOS, A, B] : la position qui prédit B ne voit que BOS et A.
Trois usages de l’attention dans le modèle
La section 3.2.3 recense trois endroits où le modèle utilise l’attention multi-têtes. Le calcul est le même dans les trois cas ; seules changent la provenance des requêtes, des clés et des valeurs, et les positions visibles :
La troisième est ce qu’on appelle habituellement l’attention croisée ; elle reprend l’attention encodeur–décodeur typique des modèles séquence-à-séquence antérieurs. Le masque du décodeur est appliqué à l’intérieur de l’attention par produit scalaire mis à l’échelle : avant le softmax, toute valeur correspondant à une connexion interdite est fixée à , si bien que son poids vaut exactement zéro.
Attention par produit scalaire mis à l’échelle : pourquoi réduire les scores
La section 3.2 définit l’attention sobrement : elle associe à une requête et à un ensemble de paires clé–valeur une sortie, somme pondérée des valeurs, où chaque poids est calculé par une fonction de compatibilité entre la requête et la clé correspondante. La section 3.2.1 prend le produit scalaire comme fonction de compatibilité. En regroupant plusieurs requêtes dans une matrice , et les clés et valeurs dans et , on obtient l’équation (1) :
est la dimension des requêtes et des clés, celle des valeurs. Les deux fonctions d’attention les plus courantes à l’époque étaient l’attention additive et l’attention par produit scalaire ; la seconde ne diffère de l’équation ci-dessus que par le facteur . Leur complexité théorique est comparable, mais le produit scalaire s’appuie sur des multiplications matricielles très optimisées et s’avère bien plus rapide et plus économe en mémoire.
Pourquoi ce facteur ? Des expériences citées par l’article montrent que les deux mécanismes se valent pour de petites valeurs de , mais que l’attention additive l’emporte sur le produit scalaire non mis à l’échelle quand grandit. Les auteurs soupçonnent que, pour grand, les produits scalaires prennent de grandes valeurs et poussent le softmax vers des régions où ses gradients sont extrêmement faibles. Une note de bas de page donne la raison : si les composantes de et sont des variables aléatoires indépendantes de moyenne 0 et de variance 1, alors a une moyenne de 0 et une variance de . Diviser par ramène la variance à 1.
Avec le de l’article, l’écart type d’un produit scalaire vaut environ 8. Supposons deux clés avec des scores non mis à l’échelle de 8 et 0. Le softmax attribue à la première un poids d’environ 0,9997, presque une distribution one-hot, et sa dérivée tombe à environ 0,0003. Divisés par 8, les scores deviennent 1 et 0, les poids environ 0,73 et 0,27, et la dérivée environ 0,20. Ce n’est qu’un calcul à la main. L’article présente l’explication par les gradients comme une hypothèse et ne lui consacre aucune expérience.
La figure ci-dessous applique le même calcul à une phrase de sept mots. Pour que l’arithmétique reste lisible, ses vecteurs n’ont que deux dimensions : les scores y sont divisés par , alors que l’article divise par . Activez le masque causal pour voir comment l’auto-attention du décodeur cache les mots suivants, ou passez à « Les deux têtes » pour un avant-goût de la concaténation multi-têtes de la section suivante.
Choisissez le mot qui interroge (la requête). Chaque étape ajoute une partie du calcul.
Chaque ligne est une requête, chaque colonne une clé. Chaque ligne est un softmax distinct qui totalise 100 %. Sélectionnez une ligne pour faire de ce mot la requête.
q(il) = [2.2, 0]
| Clé | k | q·k/√2 | Poids |
|---|---|---|---|
| Le | [0.2, 0] | 0.31 | 4.0% |
| chat | [2, 0.4] | 3.11 | 66% |
| dormait | [0.3, 1.6] | 0.47 | 4.7% |
| car | [0, 0.2] | 0.00 | 2.9% |
| il | [1, 0.3] | 1.56 | 14% |
| était | [0.1, 0.5] | 0.16 | 3.4% |
| fatigué | [0.4, 1.4] | 0.62 | 5.5% |
Tête 1 : le sens · Somme pondérée
Sortie o1 = Σ w·v = [2.67, 1.16]
Tête 1 : le sens · Toutes les requêtes
Les vecteurs sont choisis à la main pour rendre deux motifs lisibles. Dans un modèle entraîné, les têtes sont rarement aussi nettes.
Attention multi-têtes : huit têtes de 64 dimensions
Plutôt que d’appliquer une seule fonction d’attention à des requêtes, clés et valeurs de dimension , la section 3.2.2 les projette fois, avec des projections apprises différentes, vers , et dimensions. Elle calcule l’attention en parallèle sur chaque projection, concatène les sorties de dimension , puis applique une dernière projection :
Les matrices de projection ont pour formes , et . L’article utilise têtes, chacune avec .
Suivons les formes pour une phrase de 10 tokens. L’entrée mesure . Chaque tête la projette en requêtes, clés et valeurs de , calcule une matrice de poids et produit une sortie . Concaténer les huit têtes redonne , que l’on multiplie par la matrice . Comme chaque tête est plus petite, le coût total reste proche de celui d’une attention à une seule tête en pleine dimension. Avec ces formes, une sous-couche d’attention multi-têtes contient quatre matrices de , soit 1 048 576 poids.
L’argument des auteurs est que l’attention multi-têtes permet au modèle de prêter attention conjointement à des informations issues de sous-espaces de représentation différents, à des positions différentes ; avec une seule tête, la moyenne efface ces distinctions. Les lignes (A) du tableau 3 mettent cette affirmation à l’épreuve, comme on le verra plus bas.
Les trois autres composants
Réseaux feed-forward position par position
Selon la section 3.3, chaque couche de l’encodeur et du décodeur contient aussi un réseau feed-forward entièrement connecté, appliqué à chaque position séparément et de manière identique. Il se compose de deux transformations linéaires séparées par une ReLU, équation (2) :
Les positions d’une même couche partagent leurs paramètres, tandis que chaque couche a les siens ; l’article note qu’on peut aussi y voir deux convolutions de noyau 1. L’entrée et la sortie ont dimensions, la couche interne . À cette taille, et totalisent poids, environ le double des poids de projection d’une sous-couche d’attention. Le titre affirme que l’attention suffit, pourtant, dans chaque couche de l’encodeur, le FFN compte deux fois plus de poids que l’attention ; il faut la seconde sous-couche d’attention du décodeur pour que les deux s’équilibrent à peu près. L’attention fait circuler l’information entre les positions ; le FFN traite ensuite chaque position isolément.
Embeddings et partage des poids
La section 3.4 utilise des embeddings appris pour convertir les tokens d’entrée et de sortie en vecteurs de dimension , et la transformation linéaire apprise habituelle suivie d’un softmax pour convertir la sortie du décodeur en probabilités du token suivant. L’article partage une même matrice de poids entre les deux couches d’embedding et la transformation linéaire qui précède le softmax ; dans les couches d’embedding, il multiplie ces poids par (environ 22,6). L’article ne justifie pas ce facteur.
Partager une même table d’embeddings entre langue source et langue cible suppose que les deux utilisent le même vocabulaire. C’est le cas pour l’anglais–allemand : la section 5.1 indique que les phrases sont encodées par byte-pair encoding (BPE), avec un vocabulaire source–cible partagé d’environ 37 000 tokens. Les pratiques générales de tokenisation et de vocabulaire sont décrites dans Tokenisation et représentations du texte dans un modèle.
Encodage positionnel sinusoïdal
Sans récurrence ni convolution, le modèle a besoin d’une autre source d’information sur la position relative ou absolue des tokens pour exploiter leur ordre. La section 3.5 ajoute des « encodages positionnels » aux embeddings d’entrée, à la base des piles de l’encodeur et du décodeur. Ces encodages ont la même dimension que les embeddings, ce qui permet de les additionner. L’article utilise des sinus et cosinus de fréquences différentes :
désigne la position et la dimension. Chaque dimension de l’encodage correspond à une sinusoïde, sinus pour les dimensions paires et cosinus pour les impaires, chaque paire partageant une fréquence ; les longueurs d’onde forment une progression géométrique de à . À la position 1, la première paire de dimensions vaut et . Pour la dernière paire (), le dénominateur vaut environ 9647 et le sinus n’atteint qu’environ 0,0001. Les premières dimensions varient vite avec la position, les dernières lentement ; ensemble, elles distinguent un grand nombre de positions.
Les auteurs ont choisi cette fonction parce qu’ils supposaient qu’elle permettrait au modèle d’apprendre facilement à porter attention selon la position relative : pour tout décalage fixe , s’écrit comme une fonction linéaire de . Pour une seule fréquence , c’est la formule d’addition des angles. Passer de à revient à appliquer une matrice de rotation qui ne dépend que de .
L’article a aussi essayé des embeddings positionnels appris et obtenu des résultats presque identiques (tableau 3, ligne (E)). Il a gardé la version sinusoïdale parce qu’elle « pourrait » permettre au modèle d’extrapoler à des séquences plus longues que celles vues à l’entraînement. C’est une attente des auteurs ; l’article ne présente aucune expérience d’extrapolation.
Pourquoi l’auto-attention : lire le tableau 1
La section 4 compare les couches d’auto-attention aux couches récurrentes et convolutives sur une même tâche : transformer une séquence de longueur variable en une autre de même longueur , avec . Elle retient trois critères : la complexité de calcul totale par couche ; la part du calcul parallélisable, mesurée par le nombre minimal d’opérations séquentielles ; et la longueur du chemin entre dépendances lointaines dans le réseau. Plus les chemins que doivent parcourir les signaux, en propagation avant comme arrière, sont courts, plus les dépendances lointaines sont faciles à apprendre.
Dans le tableau 1, est la longueur de la séquence, la dimension de représentation, la taille du noyau de convolution et la taille du voisinage de l’auto-attention restreinte :
Commençons par les deux dernières colonnes. Une couche d’auto-attention relie toutes les positions avec un nombre constant d’opérations séquentielles ; une couche récurrente en demande . La position 50 doit attendre les 49 états qui la précèdent, et un signal parti du mot 1 traverse 49 mises à jour d’état avant d’atteindre le mot 50. En auto-attention, ces deux positions sont reliées directement au sein d’une seule couche.
Passons à la complexité. Les couches d’auto-attention sont plus rapides que les couches récurrentes quand la longueur de la séquence est inférieure à la dimension . Les auteurs notent que c’est le plus souvent le cas pour les représentations de phrases des meilleurs modèles de traduction, à base de word-pieces ou de byte-pairs. Prenons : pour , contre , soit un ordre de grandeur de moins pour l’auto-attention ; pour , le premier terme passe à , environ quatre fois le second. Le du tableau signifie que le travail d’une couche peut s’exécuter en parallèle, pas que l’auto-attention est bon marché. Pour les séquences très longues, les auteurs proposent de restreindre l’attention à un voisinage de taille centré sur la position de sortie, au prix d’une longueur maximale de chemin portée à , et renvoient cette piste à des travaux ultérieurs.
La ligne des convolutions mérite une explication. Une seule couche convolutive de largeur de noyau ne relie pas toutes les paires de positions. Il faut pour cela empiler couches avec des noyaux contigus, ou avec des convolutions dilatées, ce qui allonge les chemins les plus longs. Les couches convolutives coûtent en général fois plus que les couches récurrentes. Les convolutions séparables réduisent la complexité à , mais même avec , cela équivaut à une couche d’auto-attention suivie d’une couche feed-forward position par position, soit exactement la combinaison retenue par le Transformer.
Les auteurs signalent un avantage secondaire : l’auto-attention pourrait rendre les modèles plus interprétables. Dans les visualisations de l’annexe, différentes têtes semblent apprendre des tâches différentes, et certaines paraissent suivre la structure syntaxique et sémantique des phrases ; plusieurs têtes de la couche 5, par exemple, relient « making » au lointain « more difficult ». Ce que prouvent réellement les poids d’attention est une autre question, traitée dans la partie consacrée à leur interprétation dans Mécanisme d'attention.
Configuration d’entraînement
La section 5 détaille l’entraînement. Les durées et les coûts d’entraînement du tableau 2 découlent directement du matériel et du nombre d’étapes décrits ici.
Données, matériel et durée
Section 5.1 : l’anglais–allemand utilise le jeu de données standard WMT 2014, environ 4,5 millions de paires de phrases, avec un vocabulaire BPE partagé d’environ 37 000 tokens. L’anglais–français utilise le jeu WMT 2014 anglais–français, bien plus grand, de 36 millions de phrases, avec un vocabulaire de 32 000 word-pieces. Les paires de phrases sont regroupées par longueur approximative, chaque lot contenant environ 25 000 tokens source et 25 000 tokens cible.
Section 5.2 : tous les modèles ont été entraînés sur une seule machine équipée de 8 GPU NVIDIA P100. Les modèles de base prenaient environ 0,4 seconde par étape et ont été entraînés pendant 100 000 étapes, soit environ 12 heures. Les grands modèles prenaient 1,0 seconde par étape et ont été entraînés pendant 300 000 étapes, soit environ 3,5 jours.
Optimiseur et préchauffage du taux d’apprentissage
La section 5.3 utilise Adam avec , et . Le taux d’apprentissage varie avec l’étape d’entraînement selon l’équation (3), où est le nombre d’étapes de préchauffage :
Le taux augmente linéairement pendant les premières étapes, puis décroît proportionnellement à l’inverse de la racine carrée du numéro d’étape. L’article fixe . Avec , le taux culmine à l’étape 4000 à et n’est plus que d’environ à l’étape 100 000.
Régularisation
La section 5.4 décrit le dropout résiduel et le lissage des étiquettes. Le dropout résiduel s’applique à la sortie de chaque sous-couche avant qu’elle soit ajoutée à l’entrée de la sous-couche et normalisée, ainsi qu’aux sommes des embeddings et des encodages positionnels dans les deux piles. Le modèle de base utilise . Le lissage des étiquettes utilise et déplace pendant l’entraînement une partie de la probabilité cible du bon token vers les autres. Selon l’article, il dégrade la perplexité, car le modèle apprend à être moins sûr de lui, mais améliore la précision et le score BLEU. Les lignes (D) du tableau 3 montrent cet effet.
Résultats
Traduction automatique : tableau 2
La section 6.1 rapporte les scores BLEU sur newstest2014. Voici les chiffres du tableau 2 ; le coût d’entraînement est exprimé en opérations en virgule flottante (FLOPs), et les cellules vides le sont aussi dans l’original :
En anglais–allemand, le grand modèle dépasse de plus de 2,0 points BLEU les meilleurs résultats publiés jusque-là, ensembles compris, et atteint 28,4 ; même le modèle de base surpasse tous les modèles et ensembles publiés auparavant. En anglais–français, le grand modèle dépasse tous les modèles uniques publiés, pour moins d’un quart du coût d’entraînement du meilleur modèle précédent. Le grand modèle anglais–français utilisait un dropout de 0,1 au lieu des 0,3 habituels du grand modèle. Le score anglais–français comporte une incohérence : le résumé et le tableau 2 indiquent 41,8, alors que le texte de la section 6.1 indique 41,0.
La colonne des coûts est une estimation, pas une mesure. L’article multiplie la durée d’entraînement, le nombre de GPU et une estimation de la puissance soutenue en simple précision de chaque GPU, en retenant 9,5 TFLOPS pour un P100. Douze heures sur 8 GPU donnent environ pour le modèle de base, et 3,5 jours environ pour le grand modèle, ce qui correspond au tableau. Dans l’original, chaque Transformer n’a qu’un seul chiffre de coût, qui s’étend sur les colonnes anglais–allemand et anglais–français.
La même section précise le décodage. Les modèles de base font la moyenne des 5 derniers points de contrôle, enregistrés toutes les 10 minutes ; les grands modèles, des 20 derniers. La recherche en faisceau utilise une largeur de 4 et une pénalité de longueur . La longueur maximale de sortie vaut la longueur d’entrée plus 50, avec arrêt anticipé quand c’est possible.
Variantes du modèle : tableau 3
La section 6.2 modifie le modèle de base un aspect à la fois et l’évalue sur le jeu de développement anglais–allemand newstest2013, avec recherche en faisceau mais sans moyenne de points de contrôle. Les perplexités (PPL) sont calculées par word-piece et ne se comparent pas à des perplexités par mot. C’est pourquoi le BLEU du modèle de base vaut ici 25,8, à ne pas comparer directement aux 27,3 obtenus sur le jeu de test au tableau 2. Les valeurs non indiquées dans le tableau 3 sont celles du modèle de base :
Chaque groupe établit un point :
- (A) Nombre de têtes : le calcul reste constant pendant que varient le nombre de têtes et leurs dimensions. Une seule tête fait perdre 0,9 point BLEU par rapport au meilleur réglage, et la qualité baisse aussi avec trop de têtes.
- (B) Taille des clés : réduire dégrade la qualité. Les auteurs y voient l’indice qu’évaluer la compatibilité n’est pas simple et qu’une fonction plus élaborée que le produit scalaire pourrait aider.
- (C) Taille : les modèles plus grands font mieux, comme prévu.
- (D) Régularisation : le dropout aide beaucoup à éviter le surapprentissage ; sans lui, le BLEU tombe à 24,6. Supprimer le lissage des étiquettes donne une perplexité plus basse (4,67) mais fait baisser le BLEU de 25,8 à 25,3, comme l’annonce la section 5.4.
- (E) Encodage positionnel : embeddings positionnels appris et sinusoïdes donnent des résultats presque identiques.
Analyse syntaxique en constituants de l’anglais : tableau 4
Pour vérifier que le Transformer se généralise au-delà de la traduction, la section 6.3 l’applique à l’analyse syntaxique en constituants de l’anglais. La sortie de cette tâche est soumise à de fortes contraintes structurelles et nettement plus longue que l’entrée ; de plus, les modèles séquence-à-séquence récurrents n’avaient pas atteint l’état de l’art avec peu de données.
Les auteurs ont entraîné un Transformer à 4 couches avec . Un premier réglage n’utilise que la partie Wall Street Journal (WSJ) du Penn Treebank, environ 40 000 phrases d’entraînement, avec un vocabulaire de 16K. Un réglage semi-supervisé ajoute les corpus à haute confiance et BerkeleyParser, environ 17 millions de phrases, avec un vocabulaire de 32K. Seul un petit nombre d’expériences sur le jeu de développement de la section 22 a servi à choisir le dropout (d’attention et résiduel), les taux d’apprentissage et la largeur du faisceau ; tous les autres paramètres sont ceux du modèle de base de traduction anglais–allemand. À l’inférence, la longueur maximale de sortie passe à la longueur d’entrée plus 300, avec une largeur de faisceau de 21 et dans les deux réglages.
Le tableau 4 donne le F1 sur la section 23 du WSJ :
L’article conclut que, sans réglage propre à la tâche, le modèle fait mieux que tous les modèles publiés auparavant à l’exception de la Recurrent Neural Network Grammar (RNNG, Dyer et al. 2016). Ligne par ligne : avec le WSJ seul, 91,3 reste sous les 91,7 de la RNNG ; dans le groupe semi-supervisé, 92,7 est le meilleur score ; les résultats multitâche (93,0) et de la RNNG générative (93,3) sont plus élevés, mais reposent sur d’autres modes d’entraînement. Contrairement aux modèles séquence-à-séquence récurrents, le Transformer dépasse le BerkeleyParser (Petrov et al. 2006, 90,4) même entraîné sur les seules 40 000 phrases du WSJ.
Ce qui a tenu et ce qui a changé
Les calculs centraux de l’article ont pour l’essentiel survécu tels quels : la formule de l’attention par produit scalaire mis à l’échelle, la concaténation et la projection de sortie de l’attention multi-têtes, les connexions résiduelles, les couches feed-forward position par position et l’entraînement de toutes les positions en parallèle. Ce qui a changé tient surtout à la façon d’assembler ces pièces :
- Topologie : de nombreux grands modèles de langage ne conservent que la pile du décodeur, sans encodeur ni attention croisée. La visibilité du contexte et les têtes de sortie des trois familles sont décrites dans Encoder, Decoder et Encoder–Decoder ; les règles de génération token par token, dans Génération autorégressive et décodage.
- Place de la normalisation : Xiong et al. (2020) ont analysé l’agencement Post-LN de l’article. À l’initialisation, les gradients des paramètres proches de la couche de sortie sont grands, si bien qu’un taux d’apprentissage élevé rend l’entraînement instable ; ils expliquent ainsi la nécessité du préchauffage. Avec la normalisation déplacée à l’intérieur de la branche résiduelle (Pre-LN), un entraînement sans préchauffage atteint des résultats comparables. Les modèles modernes emploient couramment Pre-Norm et RMSNorm, comme le décrit la partie sur les blocs de Transformers.
- Information de position : après les sinusoïdes sont venus les positions absolues apprises, les biais de position relative et RoPE. RoPE encode la position absolue par une matrice de rotation tout en intégrant explicitement la dépendance à la position relative dans le calcul de l’auto-attention. Le tableau sur la position de Transformers compare où agit chaque méthode.
- Têtes et cache : lors d’une génération token par token, les clés et valeurs des positions antérieures sont mises en cache. L’attention multi-requêtes (MQA) et l’attention à requêtes groupées (GQA) font partager à plusieurs têtes de requête un nombre réduit de têtes clé/valeur pour réduire ce cache ; voir Variantes de l’attention et compression du cache KV.
- FFN : la ReLU cède souvent la place à GELU ou à des variantes à portes comme SwiGLU ; voir Activations et réseaux feed-forward à portes.
- Longueur des séquences : l’hypothèse du tableau 1, inférieur à , ne tient plus pour les longs contextes, où le terme en devient le coût principal. Des noyaux comme FlashAttention abaissent le pic de mémoire, mais l’attention exacte reste quadratique en calcul. Les estimations détaillées de formes et de mémoire se trouvent dans Transformers.
Dans leur conclusion, les auteurs fixent trois pistes : appliquer le Transformer à d’autres modalités d’entrée et de sortie que le texte ; étudier une attention locale et restreinte pour traiter efficacement de grandes entrées et sorties comme les images, l’audio et la vidéo ; rendre la génération moins séquentielle. Le code d’entraînement et d’évaluation a été publié dans tensor2tensor.