Découpage des données et fuite
La KDD Cup 2008 demandait de détecter le cancer du sein à partir de données de mammographie. En revenant sur cette compétition, Kaufman et al. (2011) relèvent que l’identifiant du patient, variable ignorée par la plupart des concurrents, avait un pouvoir prédictif énorme et inattendu. Les données réunissaient plusieurs sources (études cliniques, établissements ou équipements) ; chaque source avait reçu un bloc d’identifiants consécutifs, et la fusion n’avait pas masqué la source. L’identifiant révélait donc la provenance du patient, et certaines sources avaient un taux de cancer élevé.
Ce signal venait de la manière dont les données avaient été assemblées, non des images du sein ; le dépistage de vrais nouveaux patients ne comporte aucun bloc d’identifiants trié par source, si bien que les scores de la compétition ne valaient pas hors d’elle. C’est cela, une fuite de données (data leakage) : l’entraînement, la construction des variables, la sélection du modèle ou l’évaluation utilisent des informations qui ne seraient pas légitimement disponibles dans la situation de prédiction visée. Les résultats d’évaluation deviennent alors trop optimistes.
Retirer l’identifiant ne suffit pas forcément à assainir les données. Kaufman et al. soulignent que si les plages d’identifiants correspondent à des établissements situés en des lieux différents, avec des équipements différents, d’autres traces peuvent subsister : si, par exemple, les niveaux de gris sont plus élevés là où le taux de cancer est élevé, un modèle privé de l’identifiant reconnaît encore la source à partir du reste des données, et son score reste optimiste.
L’erreur est fréquente en recherche aussi. L’enquête de Kapoor et Narayanan (2022) sur les disciplines ayant adopté l’apprentissage automatique recense 17 domaines où des erreurs de fuite ont été relevées, touchant au total 329 articles, dont certains aux conclusions largement surestimées.
Pour s’en prémunir, on établit d’abord quelles informations existent au moment de la prédiction, puis on fait respecter cette frontière par le découpage et par chaque étape de prétraitement. L’exemple de la fin, un prompt retouché encore et encore, applique les règles qui suivent à l’évaluation d’un grand modèle de langage.
Définir la frontière d'information
Avant de découper les données, définissez les métadonnées suivantes :
unit             objet de la prédiction : patient, commande ou appareil, par exemple
prediction_time  moment où la sortie doit être produite
horizon          horizon de la cible, par exemple les 30 prochains jours
available_info   informations réellement disponibles et autorisées à cet instant
label_time       moment où l’étiquette apparaît, arrive à maturité et peut être révisée
split_key        entités, groupes et périodes qui ne doivent pas chevaucher les ensembles
La légitimité s'évalue par rapport à l'ensemble d'information au déploiement . Le fait qu’un champ existe dans une base ne signifie pas qu’il avait été créé au moment de la prédiction , ni que les règles métier autorisent le modèle à l’utiliser.
Types de fuites
Attention : Une variable de substitution (proxy) fortement corrélée n’est pas nécessairement illégitime ; il faut vérifier que l’information existe réellement au moment de la prédiction et que son utilisation est autorisée. Un proxy légitimement disponible au déploiement peut être un raccourci, une source de biais ou une corrélation fragile. C’est un problème de robustesse plutôt qu’une fuite au sens strict. Évaluez-le par des analyses de sous-groupes, des tests d’intervention et des contrôles de dérive de distribution, plutôt que de traiter toute variable fortement corrélée comme une fuite.
Découper pour simuler l'usage réel
Chaque question de déploiement exige une logique de découpage adaptée :
À retenir : La stratification préserve la proportion des classes ; elle n’empêche pas une même entité, des observations proches dans le temps ou des doublons de traverser la frontière entraînement/test.
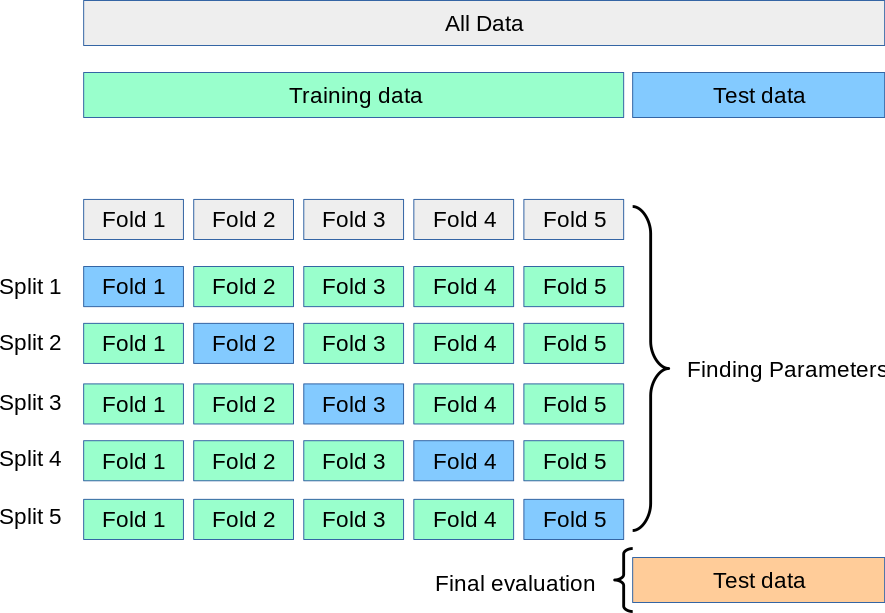 Voir l’image en grand
Le test est réservé dès le départ, à droite. À gauche, chaque ligne utilise un pli bleu pour valider et les plis verts pour ajuster. Réajustez aussi le prétraitement dans chaque ensemble d’entraînement. Le test intervient après la sélection, pour l’évaluation finale. Les cinq plis servent ici à montrer la méthode ; le nombre de plis et le regroupement découlent de la question de déploiement de la section précédente.
Invariant de pipeline
Pour des indices d'entraînement et des indices de validation , toute transformation apprise doit satisfaire
Cela couvre la mise à l’échelle, l’imputation, la construction du vocabulaire, l’ACP, la sélection de variables, le codage de cible (target encoding), le suréchantillonnage et l’augmentation de données apprise.
- Validation croisée (CV) : Réajustez toutes les transformations dans chaque pli d’entraînement.
- Validation croisée imbriquée (nested CV) : La boucle externe évalue la généralisation ; la boucle interne sélectionne les hyperparamètres ou les variables.
- Erreur courante : Sélectionner les variables sur toutes les données avant la CV constitue toujours une fuite.
Une petite transformation ajustée sur l’entraînement
Le guide scikit-learn sur les fuites applique la même règle : apprendre le prétraitement sur l’entraînement, puis le réutiliser sans modification. Si les valeurs d’entraînement sont 2 et 4, et la validation contient 100, le centrage apprend 3 et transforme la validation en 97. Un centrage global apprendrait et laisserait la validation modifier la représentation des lignes d’entraînement.
train = [("A", 2.0), ("B", 4.0)]
valid = [("C", 100.0)]
assert {g for g, _ in train}.isdisjoint(g for g, _ in valid)
center = sum(x for _, x in train) / len(train)
assert [x - center for _, x in train] == [-1.0, 1.0]
assert [x - center for _, x in valid] == [97.0]
Ce petit exemple de découpage évalue de nouvelles entités : A et B sont à l’entraînement, C seulement en validation. S’il s’agit de prédire la prochaine visite d’un patient déjà connu, il est légitime d’utiliser l’historique disponible à cet instant ; un test sans patients communs répond à une autre question : comment le modèle se comporte-t-il face à des patients jamais vus ? Pour tester de futurs nouveaux patients, fixez une date de coupure : n’entraînez que sur les lignes antérieures dont les étiquettes ont atteint leur maturité à cette date, et ne testez que sur les lignes ultérieures de patients absents de l’entraînement. Les patients revenus après une visite antérieure à la coupure sortent ainsi du test, ce qui change la population testée ; le rapport doit indiquer combien ont été exclus.
Un pipeline évite les erreurs d’ajustement entre plis, mais pas toutes les fuites de cible internes à l’entraînement. Le codage de cible peut introduire l’étiquette d’une ligne dans ses propres variables ; calculez les encodages d’entraînement hors pli ou selon un ordre temporel approprié. Le rééchantillonnage ne doit porter que sur l’entraînement, sans modifier les proportions de classes dans la validation ou le test.
Exemple appliqué : à force de retoucher le prompt, le test devient une validation
Situation : Imaginez que vous ajustez le prompt système d’un assistant qui ne répond qu’à partir du manuel de votre propre produit. Vous disposez de 30 questions avec des réponses de référence rédigées. Après chaque révision du prompt, vous relancez les 30 questions et mettez en production la version au meilleur score.
Conception défaillante :
- Chaque révision du prompt est guidée par le score sur ces 30 questions. Après vingt tours, elles sont devenues un ensemble de validation, et une partie du gain vient d’un ajustement à ces 30 questions elles-mêmes.
- Les exemples few-shot sont choisis parmi ces mêmes 30 questions, ce qui inscrit les questions et réponses du test dans le prompt.
- Pour avoir plus de questions, un modèle reformule d’abord chacune de cinq façons, puis le test est découpé au hasard : les reformulations d’une même question se retrouvent à la fois dans l’ensemble de réglage et dans le test.
- Les questions de recherche augmentée sont écrites à partir de fragments du manuel. Les fragments d’un même document produisent des questions de réglage et des questions de test, qui partagent donc le même contexte et la même formulation.
Conception plus rigoureuse :
- Découper d’abord, augmenter ensuite : Regrouper par question d’origine (par document source pour la recherche augmentée), séparer réglage et test, puis reformuler et augmenter uniquement dans l’ensemble de réglage.
- Prendre les exemples dans le réglage seulement : Les exemples few-shot et les réponses modèles du prompt viennent uniquement de l’ensemble de réglage.
- Régler sur le réglage seulement : Comparer chaque révision du prompt sur l’ensemble de réglage et garder le test verrouillé.
- Tester une seule fois : Exécuter le test une fois sur la version finale et présenter les résultats par type de question. Si vous retouchez encore le prompt ensuite, prendre un nouveau lot de questions comme test.
- Figer les réglages d’exécution : Consigner l’identifiant du modèle, la température et la méthode de notation dans la fiche d’exécution, et ne pas les changer avant et après le test.
Si le score baisse nettement sur des questions nouvelles, une partie de l’ancien score venait de l’ajustement à ces 30 questions. C’est le même type de problème que l’identifiant patient de la KDD Cup 2008 : le score a absorbé des informations que l’usage réel ne fournirait pas.
Sondes de détection de fuites
Utilisez ces sondes et contrôles négatifs pour rechercher activement les fuites :
- Audit temporel : Enregistrez les dates de l’événement, de l’ingestion et de la révision pour chaque variable.
- Sonde à une variable : Entraînez sur chaque variable suspecte seule ; remontez son lignage si ses performances sont anormalement élevées.
- Sonde d’identifiants : Retirez ou mélangez les identifiants d’entité et les proxies à forte cardinalité. L’identifiant patient de la KDD Cup 2008 est exactement ce que cette sonde doit attraper.
- Audit des doublons : Vérifiez les doublons exacts et quasi-doublons.
- Permutation des étiquettes : Si le pipeline complet dépasse encore significativement une référence aléatoire après mélange des étiquettes, suspectez un bug ou une fuite.
- Assertions de frontière : Ajoutez au code des assertions vérifiant qu’aucun groupe n’apparaît dans plusieurs ensembles, que les dates d’entraînement précèdent celles du test lors d’une évaluation vers le futur et qu’aucune transformation n’est ajustée sur le test.
- Nouvelle réserve : Obtenez de nouvelles données de réserve pour un benchmark consulté à répétition.
Limite : Les tests par permutation ne détectent pas toutes les fuites : ils ne repèrent que les fuites que le pipeline recalcule à partir des étiquettes permutées. Une variable fuyante précalculée à partir des vraies étiquettes et stockée dans une table cesse de correspondre une fois les étiquettes permutées : le score retombe au niveau du hasard et le test paraît propre alors que la fuite demeure. Associez toujours les contrôles au lignage des données.
Distinctions
- Surapprentissage (overfitting) : Le modèle apprend le bruit de l’échantillon d’entraînement, même si le pipeline est valide. Une exactitude élevée sur l’entraînement ne suffit pas à établir une fuite : un modèle surajusté obtient lui aussi un score élevé sur ses données d’entraînement.
- Fuite : Le processus de développement traverse une frontière d’information.
- Dérive de distribution : La distribution au déploiement diffère de celle de l’évaluation.
- Confusion (confounding) : Une cause commune fausse l’interprétation causale.
Ces quatre phénomènes peuvent coexister : une fois la fuite corrigée, surapprentissage et dérive de distribution peuvent encore subsister.
Liste de contrôle avant publication
prediction_time: explicit
label_horizon_and_maturity: explicit
unit_and_group_key: explicit
split_algorithm_and_seed: versioned
all_learned_transforms_fit_on_train_only: true
test_used_for_selection: false
duplicate_and_overlap_audit: complete
feature_availability_lineage: reviewed
known_residual_risks: listed