Réseaux de neurones récurrents
Un RNN réutilise des paramètres tout en transmettant un état à travers le temps :
L'état de dimension finie est un résumé appris pour l'objectif visé, et non une archive sans perte. Cette compression permet le traitement au fil de l'eau (streaming) tout en perdant des détails à longue portée.
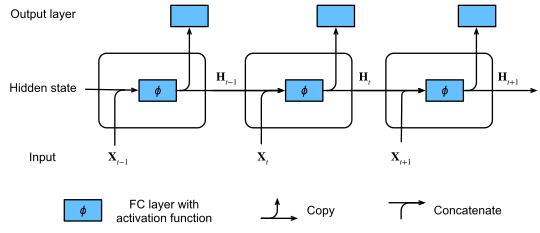 Voir l’image en grand
Lisez horizontalement pour suivre l’état dans le temps, puis verticalement pour relier entrée et sortie. Les blocs réutilisent les mêmes paramètres ; ce ne sont pas des réseaux entraînés séparément. Les sorties ultérieures peuvent ainsi dépendre des entrées précédentes par ce chemin d’état.
Objectifs séquentiels
La modélisation autorégressive factorise
Le forçage de l'enseignant (teacher forcing) fournit le préfixe réel lors de l'entraînement ; la génération libre réutilise les sorties antérieures du modèle, y compris leurs erreurs. Une faible perte sous teacher forcing ne garantit donc pas un déroulement (rollout) stable. Cet écart est souvent appelé biais d’exposition (exposure bias). Les remèdes dépendent de la tâche ; prolonger l’entraînement ne suffit pas à l’éliminer.
Pourquoi la rétropropagation à travers le temps échoue
Le chemin reliant l'instant à l'instant fait intervenir un produit de jacobiens :
Des contractions répétées provoquent la disparition du gradient ; des expansions provoquent son explosion. La longueur des séquences, le spectre des poids, la saturation des activations et les trajectoires rencontrées dans les données jouent tous un rôle. Dire que les RNN sont anciens n’explique pas ce mécanisme.
- L’écrêtage du gradient (gradient clipping) limite les grandes mises à jour, sans restaurer les gradients disparus.
- La BPTT tronquée réduit la mémoire et le calcul, mais coupe l’attribution du crédit à longue distance.
- Une initialisation adaptée, la normalisation et les portes peuvent améliorer l’entraînement, sans garantir une mémoire infinie.
Pour préciser l’ordre, posons . Le produit est ; on ne peut généralement pas inverser les facteurs matriciels. Les mêmes paramètres récurrents servent à chaque étape : leur gradient additionne toutes les contributions, y compris les chemins indirects par les états ultérieurs. C’est le mécanisme de dérivation en chaîne derrière les difficultés de gradient de la BPTT.
Pour la récurrence de lissage ci-dessous, avec , et les entrées , les états sont . La sensibilité à après trois étapes vaut . Détacher l’état après la deuxième étape conserve sa valeur pour la passe avant suivante, mais coupe le gradient vers le segment antérieur. Détacher n’est pas réinitialiser. Avec du padding et une sortie consommant l’état final, masquer seulement la perte ne suffit pas : ignorer les mises à jour sur les positions de padding ou sélectionner le dernier état valide.
Mécanisme de portes du LSTM
Un réseau à mémoire à long et court terme (LSTM) maintient un état de cellule en plus de l’état caché . La porte d’oubli pondère l’ancien état de cellule, la porte d’entrée pondère la mise à jour candidate , et la porte de sortie contrôle la contribution de la cellule à . Ici, désigne la sigmoïde, le produit élément par élément, et la concaténation des deux vecteurs. Dans ces équations, est la porte de sortie, et non le vecteur de scores de l’équation RNN initiale. Une forme courante est :
Le chemin additif de la cellule améliore l'écoulement de l'information et des gradients. Les portes sont des mécanismes de contrôle continus appris, et non des commutateurs de mémoire automatiquement interprétables ; les implémentations varient au niveau des biais, des projections, des connexions peephole et de l'ordre des portes.
Exemple appliqué : lissage en streaming
Considérons la récurrence scalaire
On obtient une moyenne mobile exponentielle. Chaque mise à jour utilise une mémoire constante. La nouvelle observation reçoit le poids ; une observation vieille de pas reçoit .
Cet exemple montre les deux faces de la récurrence : le RNN peut se mettre à jour en ligne sans conserver toute la séquence, mais l’information ancienne décroît selon une règle fixe et ne peut pas être relue à la demande. Un RNN entraîné est plus souple, tout en restant limité par son état de dimension finie et le signal d’entraînement. L’attention change ce compromis en conservant plusieurs positions représentées et en les consultant selon leur contenu.
Frontières d'état et de données
- Les RNN causaux ne voient que le présent et le passé, ce qui permet la prédiction en streaming.
- Les RNN bidirectionnels utilisent aussi le contexte futur ; ils ne conviennent pas aux décisions en ligne où ce contexte est indisponible.
- Masquez le padding dans les lots ; la longueur révélée par le padding ne doit pas divulguer l’étiquette.
- Réinitialisez l’état caché entre entités indépendantes, sauf si sa transmission a un sens explicite.
- Découper aléatoirement des fenêtres temporelles peut placer des segments voisins ou chevauchants dans l’entraînement et le test.
Le dernier point relève d’une fuite de données, pas des performances de l’architecture. Définissez les découpages par entité et par temps.
Modèles séquentiels modernes à base d'états
Les RNNs classiques ne constituent pas le point final de la modélisation à base d'états. Les modèles d’espace d’états structurés (SSM) partent d’équations d’état linéaires en temps continu ou discret et utilisent des paramètres structurés et des algorithmes parallèles pour combiner l'entraînement sur de longues séquences avec une inférence récurrente. S4 a montré les capacités des SSM structurés sur de longues séquences ; Mamba a rendu certaines parties de la mise à jour dépendantes de l'entrée et a introduit un balayage (scan) adapté au matériel ; xLSTM a revisité la mémoire récurrente et les portes.
Ces noms désignent des architectures distinctes :
- La transition d’état non linéaire d’un RNN classique diffère des équations structurées d’un SSM.
- La croissance linéaire avec la longueur annoncée pour Mamba décrit un chemin algorithmique ; elle ne garantit pas un temps d’exécution inférieur à celui de l’attention pour toute longueur, taille de lot ou machine.
- xLSTM poursuit la voie des réseaux récurrents à portes ; cela ne signifie pas que les LSTM surpassent universellement les Transformers.
- Les benchmarks des articles restent liés aux données, à l’échelle, aux kernels et au budget d’entraînement. Il faut reproduire ces résultats sur la tâche cible.
Au 2026-08-11, S4, Mamba et xLSTM sont d’importantes architectures concurrentes, pas un nouveau choix permanent par défaut.
RNN, SSM et auto-attention complète
Affirmer que les Transformers ont rendu les RNN inutiles ou que les SSM à coût linéaire en longueur de séquence remplaceront nécessairement l’attention est excessif. Le choix dépend de la latence, de la mémoire, de la longueur des séquences, de l’échelle d’entraînement, des kernels et de la structure de la tâche.
Expérimentation minimale
- Faites surapprendre le modèle sur une séquence courte pour vérifier l’implémentation.
- Vérifiez que modifier le padding masqué ne change pas les sorties.
- Mélangez volontairement les frontières d’état et vérifiez que les tests détectent la contamination.
- Présentez séparément la perte sous teacher forcing et les résultats en génération libre.
- Découpez par temps et par entité ; comparez à des références sans état, saisonnières ou à moyenne mobile.
- Notez les normes de gradient, la longueur de troncature, la dimension cachée, les kernels et les graines ayant échoué.
Cette note privilégie les séquences discrètes supervisées. Les systèmes en temps continu, l'ensemble des variantes de SSM, l'apprentissage par renforcement et le feedback en ligne nécessitent un traitement distinct.
Dans Visualizing memorization in RNNs de Distill, sélectionner les caractères des exemples d’autocomplétion et examiner leurs liens avec le contexte précédent. Comparer GRU et LSTM pour voir comment des scores globaux proches masquent des usages différents du contexte. Ces liens sont des diagnostics par gradient sur ces exemples, pas un classement universel des architectures.