Évaluer un modèle sous dérive de distribution
En 2019, des chercheurs ont suivi la procédure d’origine d’ImageNet pour constituer un nouveau jeu d’images de test. Un large éventail de classificateurs d’images y a perdu de 11 à 14 points d’exactitude, alors que leur classement restait à peu près le même (Recht et al., 2019). Aucun modèle n’avait changé ; seule l’origine des données de test avait changé. Le score de test initial ne décrivait que les données initiales.
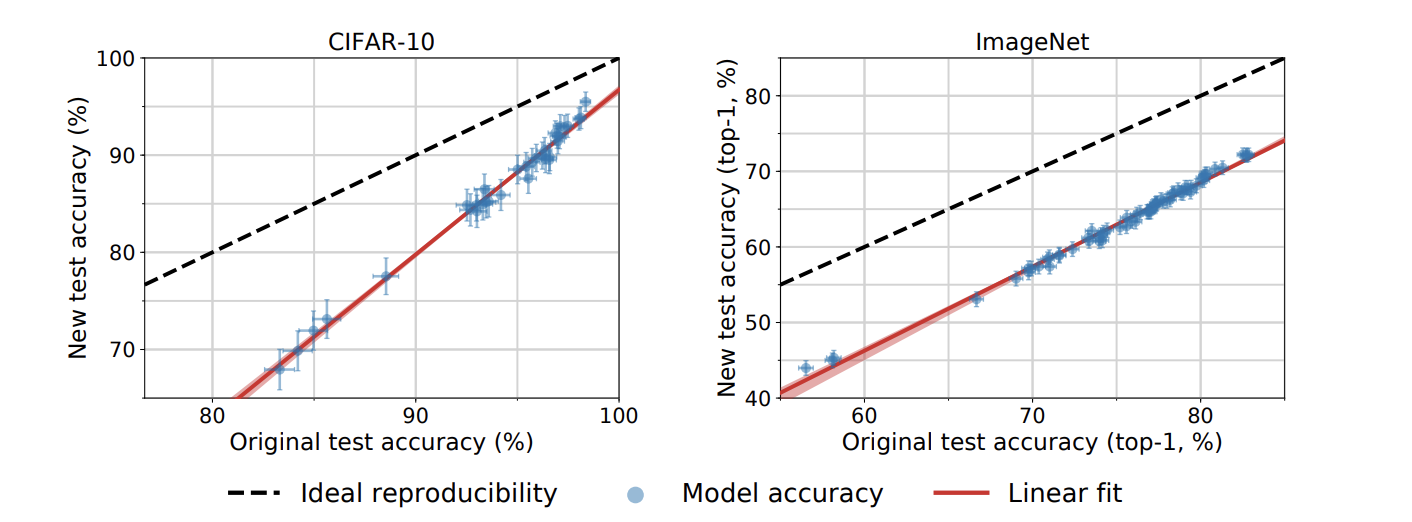 Voir l’image en grand
Chaque point bleu représente un modèle : l’abscisse donne son exactitude (accuracy) sur le test original, l’ordonnée celle sur de nouvelles données. Les points sous la diagonale en tirets indiquent une baisse, malgré la forte relation entre les scores décrite par la droite rouge. Les panneaux concernent CIFAR-10 et ImageNet ; les barres donnent des intervalles de Clopper–Pearson à 95 %. Un classement globalement préservé peut donc accompagner une baisse systématique des performances absolues.
L’évaluation estime donc le comportement d’un système pour une distribution cible, un seuil, un workflow et un coût d’erreur donnés ; elle ne lui attribue pas un score permanent.
Appelons distribution de déploiement les données que le modèle rencontrera réellement, où est l’entrée et le résultat réel ; la perte mesure la gravité d’une erreur de prédiction. Le risque cible est
Autrement dit, le risque cible mesure à quel point le modèle se trompe, en moyenne, sur les données où il servira vraiment. Une moyenne sur le jeu de test n’estime ce risque que si ses échantillons sont approximativement issus de , si le test reste en dehors du développement et si les étiquettes et la perte sont correctement définies. Si les échantillons de test viennent de la même source que l’entraînement et sont indépendants entre eux, même un intervalle de confiance étroit ne couvre que cette source, pas une dérive de distribution future : la baisse de 11 à 14 points d’ImageNetV2 se situe bien en dehors de l’intervalle de confiance du test d’origine.
Définir l’objet évalué
system           modèle + prétraitement + seuil + traitement humain
unit             objet d’une prédiction
population       personnes, période et lieu auxquels extrapoler les résultats
prediction_time  informations disponibles à cet instant
outcome_horizon  fenêtre d’observation et maturité des étiquettes
action           action déclenchée par la prédiction
loss             coûts des faux positifs, faux négatifs, retards et abstentions
Si l’action modifie les données futures, un test statique évalue la politique avant déploiement, pas la boucle de rétroaction.
Types de dérive
Ces dérives peuvent se chevaucher. Une dérive des entrées ne garantit pas une perte de performance, et l’absence de dérive détectée ne garantit pas la sûreté.
Un développeur seul rencontre le plus souvent trois autres dérives : les prompts de ses propres utilisateurs s’éloignent de l’ensemble utilisé pendant le développement ; une nouvelle langue ou un nouveau domaine apparaît ; le fournisseur change le modèle derrière le même nom. Pour repérer et traiter ce dernier cas, voir évaluer un modèle sur ses propres tâches.
Les splits répondent à des questions différentes
Consulter le jeu de test à répétition, ne publier que le meilleur seed ou ajuster le système à un benchmark externe transforme le test en validation.
Les métriques répondent à des questions différentes
Choisissez les métriques selon les actions et les coûts d’erreur, plutôt que de reprendre celles d’un classement public. L’exemple de fraude de la section suivante calcule l’exactitude, la précision et le rappel, et montre comment ils peuvent donner des impressions opposées ; les autres métriques courantes répondent aux questions suivantes.
En classification, ROC-AUC mesure un classement, sans fixer de seuil opérationnel. PR-AUC privilégie la classe positive, mais sa référence dépend de la proportion de positifs. La log loss et le score de Brier évaluent différents aspects de la qualité des probabilités. La calibration compare les probabilités prédites aux fréquences observées ; elle varie avec la distribution et la taille de l’échantillon.
Exemple : 1 % de fraude
Parmi 10 000 transactions, 100 sont frauduleuses. Toujours prédire « normal » donne 99 % d’exactitude (accuracy, la part de prédictions correctes), sans intercepter aucune fraude : le rappel est nul. L’exactitude est dominée par la classe majoritaire, ici les transactions normales.
Il faut donc deux autres nombres. La précision demande combien des transactions signalées sont vraiment frauduleuses ; le rappel, combien des vraies fraudes ont été signalées. Supposons qu’un seuil signale 200 transactions, dont 60 réellement frauduleuses :
precision = 60 / 200 = 30%
recall    = 60 / 100 = 60%
Les deux nombres bougent avec le seuil : en l’abaissant, on signale davantage, le rappel monte et la précision baisse en général.
Si aucun cas n’est signalé, la précision est indéfinie car son dénominateur est nul ; si un sous-groupe de test ne contient aucun positif, le rappel est indéfini. Signalez ces cas plutôt que de les assimiler implicitement à des prédictions réussies.
L’utilité dépend aussi du coût des 200 contrôles manuels, des pertes liées aux 40 fraudes manquées, des désagréments imposés aux clients légitimes, du retard des étiquettes et de la prévalence du mois suivant. Ajuster le seuil pour maximiser l’utilité sur le test, puis publier cette même utilité, surestime la généralisation. Choisissez le seuil sur le jeu de validation, puis évaluez-le sur un test ultérieur.
La prévalence modifie aussi la précision. Ici, 140 des 200 signalements sont des transactions normales : le taux de faux positifs vaut . Pour une prévalence (la part des fraudes parmi toutes les transactions), un taux de vrais positifs (la part des fraudes signalées, c’est-à-dire le rappel) et un taux de faux positifs (la part des transactions normales signalées),
Le numérateur compte les fraudes signalées, le dénominateur tous les signalements. Si seule la prévalence change et que la distribution des scores au sein de chaque classe reste la même (changement d’a priori), et restent fixes. Portons la prévalence à 5 % : le numérateur vaut , le dénominateur ajoute , et la précision vaut environ , tandis que le rappel reste à 60 %. Même modèle, même seuil : la précision passe de 30 % à 69 % uniquement parce que la fraude est devenue plus fréquente. Voir les définitions des métriques de scikit-learn.
La façon dont les coûts des fausses alertes et des fraudes manquées fixent le seuil est détaillée dans calibration des probabilités, seuils de décision et abstention ; une ROC-AUC ne peut pas le choisir seule.
Trois niveaux d’incertitude
- Échantillon d’évaluation : intervalles analytiques ou bootstrap ; conservez l’appariement pour comparer des modèles sur les mêmes cas, et rééchantillonnez par groupe ou par bloc en présence de dépendance de groupe ou de temps.
- Aléa d’entraînement : initialisation, ordre des données et kernels non déterministes ; répétez plusieurs seeds.
- Environnement : politiques, comportements, capteurs et populations futurs ; les intervalles calculés sur des échantillons indépendants de même source l’ignorent généralement.
Une moyenne ± un intervalle non précisé confond ces sources. Publiez les numérateurs et dénominateurs, les effectifs de chaque sous-groupe, les exécutions échouées et la source d’incertitude représentée par chaque intervalle.
Slices, seuils et abstention
Les métriques globales peuvent masquer des échecs dans des groupes importants ou des sous-ensembles définis par appareil, langue, période ou difficulté. Définissez ces sous-ensembles selon l’usage et les risques avant de voir les résultats. Les multiplier après coup produit des découvertes sélectives, qui exigent une correction ou une confirmation sur de nouvelles données.
Quand les erreurs ont de lourdes conséquences, le modèle peut s’abstenir ou transmettre certains cas à un humain. L’évaluation doit alors intégrer la compétence des personnes chargées de l’examen, leur capacité de traitement, la capacité de la file et le biais de sélection. La confiance du modèle n’est pas sa probabilité d’avoir raison ; sous dérive, la calibration des probabilités et les estimations d’incertitude peuvent toutes deux devenir peu fiables.
Pour les biais des benchmarks publics et de votre propre jeu de test, voir juger les preuves dans les expériences d’IA.