Préentraînement, ajustement supervisé et optimisation des préférences
L’architecture détermine comment circule l’information ; l’entraînement détermine les comportements acquis. Deux modèles de même architecture Transformer peuvent se comporter différemment selon leurs données, objectifs et mises à jour. Pour comprendre une étape, demander d’où vient la cible et quelles sorties la perte récompense.
Le préentraînement exploite de nombreux exemples
Un modèle autorégressif prédit le prochain token à partir des précédents. Décaler le texte d’une position fournit les cibles. Sa log-vraisemblance négative est :
Avec la séquence fictive the / lamp / is / blue, prédire blue utilise the / lamp / is. Un masque causal permet de calculer plusieurs positions en parallèle pendant l’entraînement. À la génération, les futurs tokens n’existent pas encore : la séquence s’allonge progressivement. Voir la génération autorégressive.
Un encodeur peut reconstruire des tokens masqués à partir de leur contexte. L’article BERT décrit ce préentraînement puis l’adaptation aux tâches en aval. La représentation bidirectionnelle sert à classer ou extraire de l’information, sans constituer automatiquement un assistant suivant des instructions. Les familles encodeur et décodeur expliquent la différence architecturale.
L’auto-supervision dispense d’annoter chaque exemple à la main, mais une cible et un signal d’erreur subsistent : la réponse est le token qui apparaît réellement ensuite dans le texte. Ce que le modèle apprend dépend donc de ce qu’il lit : sources, doublons, équilibre linguistique et frontières documentaires modifient tous le résultat.
L’ajustement supervisé précise la sortie souhaitée
L’ajustement supervisé, ou SFT, utilise des couples entrée–cible. Pour un assistant, la cible peut être une réponse acceptable ; pour un classifieur, une étiquette. SFT désigne une étape et une organisation des données, sans imposer une architecture conversationnelle.
En génération conditionnelle, on prédit souvent les tokens de réponse à partir de la consigne et des tokens cibles précédents. Un masque de perte peut exclure consigne et remplissage. Avec 80 tokens de consigne, 20 de réponse et 28 de remplissage, une perte moyenne limitée à la réponse se divise par 20, pas par 128. Confondre ces conventions change le poids relatif des réponses courtes et longues.
Chaque exemple de SFT enseigne une décision particulière : ce qui manque au jeu d’entraînement manque aussi au modèle. Si le jeu ne contient que des doublons aussi faciles à repérer que « identique à une page déjà enregistrée → jeter », le modèle n’apprendra pas quoi faire d’une entrée à moitié répétée et à moitié nouvelle. Il faut donc recueillir délibérément ces cas limites et les désaccords d’annotation, et garder les exemples d’une même source dans la même partition. Apprentissage par transfert, LoRA et distillation développe cet exemple en entier avec un routeur de pages enregistrées.
L’article InstructGPT décrit un pipeline concret : d’abord un SFT sur des démonstrations humaines, puis des personnes comparent plusieurs réponses à une même consigne, ces comparaisons entraînent un modèle de récompense, et l’optimisation de politique augmente enfin le score de récompense. Les deux dernières étapes utilisent les données de préférence de la section suivante.
Les préférences comparent des réponses
Une démonstration demande de produire une réponse ; une paire de préférences indique que A est meilleur que B pour une même entrée. Deux réponses peuvent être exactes mais différer par leur format, ou être toutes deux fausses avec une différence de persuasion.
Dans un pipeline à modèle de récompense, les comparaisons entraînent un évaluateur, le modèle de récompense, puis l’optimisation de politique augmente ce score, sous une contrainte qui empêche le modèle de trop s’écarter d’une politique de référence (en général le modèle tel qu’il était avant l’entraînement sur les préférences).
L’article sur l’optimisation directe des préférences (DPO) montre que la récompense peut être réécrite de sorte que le modèle entraîné la représente directement. Grâce à cette réécriture, la solution optimale de cet objectif, celui qui inclut « ne pas trop s’écarter du modèle d’origine », s’écrit sous forme explicite. On peut alors se passer du modèle de récompense entraîné à part et éviter que le modèle génère et note des réponses pendant l’entraînement : des paires « A gagne, B perd » mettent le modèle à jour par une simple perte de classification. DPO supprime le modèle de récompense et l’échantillonnage pendant l’entraînement ; les données de préférence restent à collecter.
Trois paires d’annotation imaginées montrent ce que chacune enseigne :
Si la plupart des données ressemblent à la première ligne, le modèle apprend à ne renvoyer qu’une étiquette, et son raisonnement factuel ne s’en trouve pas amélioré. Chaque étiquette de préférence doit donc correspondre à une règle d’évaluation écrite, pas simplement à un vague « meilleur ».
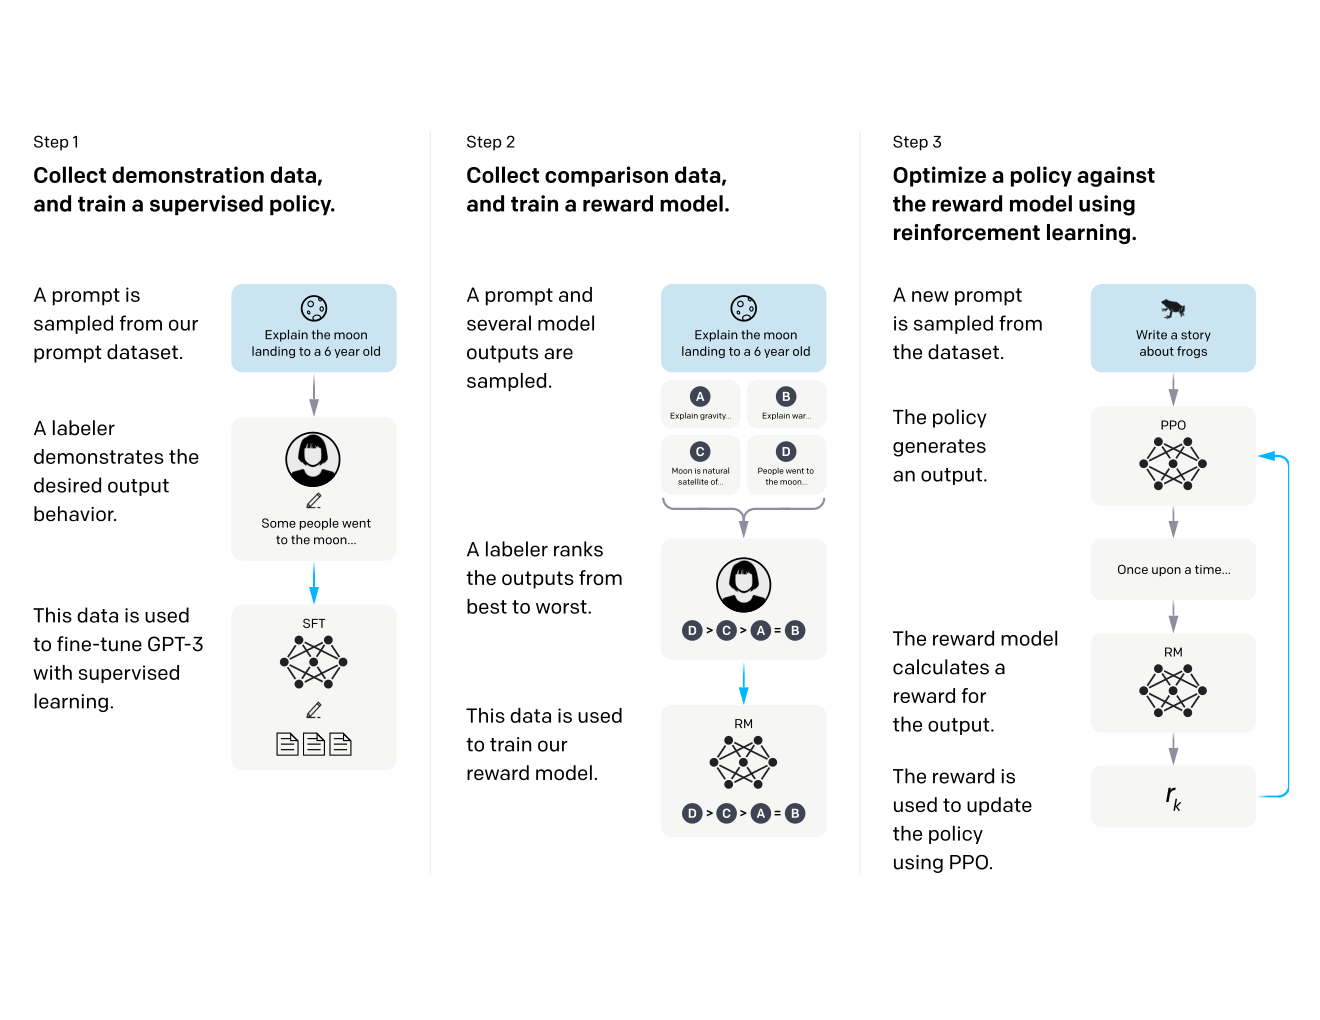 Voir l’image en grand
De gauche à droite : les démonstrations entraînent la politique SFT, les classements le modèle de récompense, puis ses scores guident PPO. Cette procédure d’InstructGPT intervient après le préentraînement. DPO, présenté plus haut, optimise les préférences autrement.
Quand un programme peut noter la réponse, la récompense peut venir d’un vérificateur
Les données de préférence exigent que des personnes comparent les réponses, mais un programme peut noter un problème de mathématiques ou de code : si la réponse finale correspond à la référence ou si le code passe ses tests, la récompense vaut 1, sinon 0. On parle de récompense vérifiable. L’apprentissage par renforcement avec une telle récompense ne demande pas au modèle d’imiter une solution rédigée par quelqu’un ; au fil de nombreux essais, il emprunte plus souvent les chemins qui rapportent des points.
GRPO (Group Relative Policy Optimization), présenté dans l’article DeepSeekMath comme une variante de PPO, est aujourd’hui une façon courante de mener cette étape. Il échantillonne un groupe de réponses au même problème, note chacune et prend la moyenne du groupe comme référence. Le score de chaque réponse, moins la moyenne du groupe, divisé par l’écart type du groupe, donne son avantage : de combien elle fait mieux que les autres réponses du groupe. PPO entraîne un modèle de valeur séparé pour estimer cette référence ; GRPO la remplace par la moyenne du groupe et économise cette mémoire. Le terme KL qui retient le modèle près d’un modèle de référence est ajouté directement à la perte.
Prenons un groupe de 4 réponses : deux sont justes et valent 1, deux sont fausses et valent 0, la moyenne du groupe vaut donc 0,5. Les deux réponses justes reçoivent un avantage positif, les deux fausses un avantage négatif de même taille, et la mise à jour suivante se déplace vers la manière dont les réponses justes étaient écrites. Si les 4 sont justes, ou les 4 fausses, chaque score égale la moyenne, tous les avantages valent 0 et le problème ne contribue en rien à la mise à jour. Il faut donc choisir des problèmes que le modèle de base résout parfois : trop faciles ou trop difficiles, ils ne donnent aucun signal.
L’article DeepSeek-R1 a appliqué cette voie à un modèle de raisonnement. DeepSeek-R1-Zero saute le SFT et lance l’apprentissage par renforcement directement sur le modèle de base, avec une notation par règles. En mathématiques, la réponse finale doit suivre un format fixé (par exemple dans une boîte) pour être vérifiée ; une récompense de format distincte exige que le raisonnement soit placé entre des balises désignées. L’article rapporte que le pass@1 sur AIME 2024 est passé de 15,6 % à 77,9 % pendant l’entraînement. Il a évité les modèles de récompense neuronaux, jugés exposés au détournement de récompense (reward hacking) dans un apprentissage par renforcement à grande échelle. Le raisonnement de R1-Zero était difficile à lire et mélangeait anglais et chinois. Le DeepSeek-R1 publié commence donc par un petit SFT de « démarrage à froid » sur de longues chaînes de raisonnement, puis enchaîne apprentissage par renforcement, échantillonnage par rejet avec SFT, et une dernière phase de renforcement visant l’utilité et l’innocuité.
Un vérificateur ne récompense que ce qu’il vérifie. Si la règle est « un point par citation ajoutée », le modèle apprend à empiler les citations, qu’elles soutiennent ou non l’affirmation ; la page apprentissage par renforcement montre comment récompenses et indicateurs indirects se font détourner. Inscrivez donc dans le vérificateur toutes les conditions qui comptent vraiment (réponse juste, citations qui soutiennent l’affirmation, format valide), puis regardez au-delà du score sur des problèmes mis de côté.
Une personne seule peut mener cette étape sur un petit modèle : le GRPOTrainer de TRL accepte de simples fonctions Python comme fonctions de récompense, et Unsloth range aussi GRPO parmi ses méthodes d’entraînement.
Ce que signifie une perte plus faible
Si la probabilité du bon token passe de à , sa perte fondée sur le logarithme naturel passe de à . L’objectif récompense seulement le modèle de donner une probabilité plus forte au token réellement apparu ; il ne vérifie jamais séparément si la phrase entière est vraie. Il en va de même pour la justesse des citations ou des appels d’outils : ces tâches ont d’autres critères d’évaluation, et une faible perte de prédiction textuelle ne peut pas les établir.
De même, améliorer la probabilité relative d’une réponse préférée peut apprendre des raccourcis : longueur, ton assuré ou style d’un annotateur. Évaluer séparément factualité, réussite, format et coût lorsque l’usage les exige. Séparer familles de consignes et documents sources entre entraînement et test, comme l’explique la note sur les fuites de données.
Choisir une étape selon le problème
Une mauvaise représentation du vocabulaire spécialisé peut justifier un préentraînement continu pour exposer le modèle à la distribution des textes du domaine. Une entrée comprise mais une sortie mal structurée peut appeler des démonstrations supervisées. Plusieurs réponses valides d’utilité différente peuvent justifier des préférences. Chacune est d’abord une hypothèse : la comparer à une référence qui saute cette étape d’entraînement, et n’investir que si elle fait nettement mieux. Les trois étapes n’ont pas à être enchaînées dans l’ordre.
Pour connaître le contenu d’un document mis à jour aujourd’hui, modifier les poids remplace mal la recherche d’une preuve actuelle. Pour un petit classifieur qui confond toujours la même catégorie, des étiquettes ciblées peuvent être plus adaptées qu’un grand générateur. Voir le pipeline de recherche et l’apprentissage par transfert.
Un objectif plus étroit peut aussi faire oublier au modèle ce qu’il savait faire. En plus du score sur la nouvelle tâche, mesurer ce qui subsiste des anciennes compétences, puis choisir le checkpoint d’après la validation. Les mentions base, instruct ou aligned dans le nom d’un modèle indiquent seulement quels entraînements il a suivis ; pour savoir s’il convient à votre tâche, il faut le mesurer sur votre tâche.