Apprentissage par transfert, LoRA et distillation
Un modèle préentraîné sait déjà transformer un texte en vecteurs utiles. Entraîner un nouveau classifieur par-dessus ne demande donc qu’un petit jeu d’exemples étiquetés, et non la masse de données nécessaire pour apprendre à lire depuis zéro. Encore faut-il que ces vecteurs conservent la distinction dont la nouvelle tâche a besoin. Avant de choisir une méthode, il faut donc savoir quel niveau doit changer : la tête de sortie, la représentation interne ou le modèle déployé lui-même.
La plupart des problèmes n’exigent pas de nouveaux poids
L’ajustement fin change les habitudes d’un modèle face à un type d’entrée récurrent ; il ajoute mal des faits qui changent. On essaie donc d’abord les étapes moins coûteuses : écrire une consigne plus claire et placer quelques exemples dans le prompt (few-shot) ; si ce qui manque au modèle, ce sont vos documents ou l’information du jour, passer par la recherche documentaire. L’ajustement fin ne vient qu’ensuite, quand ces étapes plafonnent sous le seuil sur un jeu d’évaluation fixe et que les échecs relèvent toujours du même comportement (format instable, mauvaise décision d’étiquette, ton inadapté) plutôt que d’un manque de connaissances.
L’ajustement fin est rentable dans trois situations. La première : une tâche étroite appelée des milliers de fois, où les longues consignes et les exemples du prompt se paient à chaque appel et ne marchent qu’une partie du temps. La deuxième : faire faire à un petit modèle ce qu’un grand modèle ne réussit qu’avec un long prompt ; c’est la distillation, traitée plus bas. La troisième : un modèle qui doit fonctionner hors ligne ou sur votre propre machine. Préentraînement, ajustement supervisé et optimisation des préférences explique quelle étape d’entraînement convient à quel type de problème.
Commencer par une représentation figée
Imaginez que vous recevez chaque jour de nombreux articles web enregistrés et qu’un petit modèle doit décider, pour chacun, s’il faut le garder, le résumer ou le jeter. Ce modèle est un routeur documentaire qui choisit entre trois étiquettes : keep, summarize et discard. Le plus simple consiste à figer un encodeur de texte, qui transforme chaque article en vecteur , et à n’entraîner que la couche de sortie :
Avec et trois classes, la tête comporte paramètres. Si les paramètres et les buffers de l’encodeur sont fixes, que le prétraitement est déterministe et que l’encodeur tourne en mode évaluation (dropout désactivé), les vecteurs peuvent être mis en cache pour entraîner la tête sans réexécuter l’encodeur. Ce point de départ répond directement à une question : les vecteurs existants séparent-ils déjà les trois sortes d’articles ?
Deux échecs ne se corrigent pas en entraînant plus longtemps. Si la phrase qui décide de l’étiquette a été coupée par la troncature, aucune tête ne peut la retrouver. Si l’encodeur donne presque le même vecteur à « ceci ressemble presque à un article déjà enregistré » et à « ceci est nouveau », régler la tête ne les séparera jamais. Il faut vérifier ces deux échecs avant de décider d’ajouter des époques. Le chapitre de Dive into Deep Learning distingue réutilisation des caractéristiques et adaptation des paramètres.
L’ajustement complet rend aussi le réseau principal entraînable. Il offre plus de liberté, mais exige gradients et états d’optimisation supplémentaires et peut effacer des comportements utiles. Plus de paramètres entraînables ne veut pas dire de meilleurs résultats : on compare un encodeur figé avec tête entraînée, un dégel partiel et une adaptation complète sur la même partition, et l’on retient celui qui fait réellement mieux sur l’ensemble de test.
LoRA restreint la mise à jour
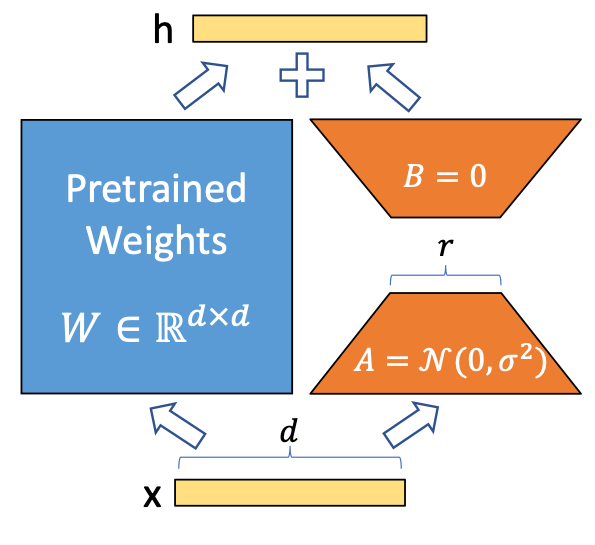
Pour une couche , LoRA fige le poids initial et apprend un ajout de faible rang :
 Voir l’image en grand
Suivez x dans les deux branches. La matrice bleue reste figée ; la branche orange passe par un goulot d’étranglement de rang r avant de retrouver la dimension de sortie. Seules A et B sont entraînées. L’initialisation de B à zéro annule au départ la contribution ajoutée.
est le rang choisi et un facteur d’échelle. Le nombre d’éléments entraînables devient au lieu de . Pour une couche de rang 8, cela donne 65 536 éléments contre 16 777 216, soit un facteur 256 pour cette couche. La mémoire totale d’entraînement ne diminue pas d’autant : poids de base, activations, couches ciblées et autres têtes restent à compter.
Le plus petit exemple montre déjà la limite : un ajout de rang 1 sur une matrice lit l’entrée selon une seule direction et écrit la sortie selon une seule direction ; il ne peut donc pas représenter n’importe quelle modification . Plusieurs couches adaptées et les non-linéarités enrichissent beaucoup le réseau, sans supprimer la contrainte de rang.
LoRA modifie la mise à jour des poids, pas la taille de l’architecture initiale. Un adaptateur compatible peut être fusionné avec les poids selon le moteur et la représentation numérique. Des adaptateurs séparés facilitent le changement de tâche, mais doivent correspondre au checkpoint de base et au tokenizer. Des noms de modèles proches ne suffisent pas à rendre les adaptateurs interchangeables.
La distillation change le modèle qui apprend
La distillation entraîne un élève avec des informations fournies par un enseignant. En classification, une distribution complète informe davantage qu’une seule étiquette. Une température adoucit les logits (l’effet de la température sur une softmax est expliqué dans régression softmax) :
Pour les logits fictifs , donne environ et environ . La cible adoucie révèle le classement des alternatives. Un objectif courant combine perte sur étiquettes et perte entre distributions enseignant–élève. Température, coefficient de mélange et convention de moyenne affectent l’échelle du gradient et doivent être consignés ensemble.
Un enseignant génératif peut produire des démonstrations ou explications candidates, à filtrer et vérifier selon la tâche. L’accord avec l’enseignant mesure l’imitation, pas la vérité : ses erreurs systématiques peuvent être transmises. Évaluer l’élève sur des étiquettes indépendantes ou sur les résultats réels de la tâche.
Des questions différentes
Ces méthodes se combinent : un enseignant fournit les exemples, un élève les apprend avec LoRA. La taille de l’élève dépend de l’architecture choisie, pas de l’usage de LoRA ; et les exemples mal étiquetés par l’enseignant, l’élève les apprend tout autant. La quantification constitue un autre axe : elle change la représentation numérique, tandis que la distillation change le modèle appris et LoRA contraint ses mises à jour.
L’ajustement hébergé s’est presque fermé : chacun lance son propre entraînement
Fin 2026, l’ajustement fin hébergé des deux plus grands fournisseurs s’est fermé aux particuliers. L’avis de dépréciation d’OpenAI, annoncé le 2026-05-07, procède en trois étapes : dès ce jour, les organisations qui n’avaient jamais lancé d’ajustement ne peuvent plus créer de tâche d’entraînement ; à partir du 2026-07-02, celles qui n’ont pas utilisé de modèle ajusté en inférence depuis 60 jours non plus ; le 2027-01-06, même les clients actifs ne pourront plus créer de nouvelles tâches. Les modèles déjà entraînés restent disponibles en inférence jusqu’à la dépréciation de leur modèle de base. Son guide d’optimisation des modèles indique lui aussi que la plateforme n’est « plus accessible aux nouveaux utilisateurs ». La page d’ajustement de l’API Gemini de Google (mise à jour le 2026-04-28) dit qu’aucun modèle ne permet plus l’ajustement fin dans l’API Gemini ni dans AI Studio. Le dernier, Gemini 1.5 Flash-001, a été déprécié en mai 2025, et Google n’a pas de projet immédiat pour le rétablir.
Pour un développeur individuel, l’ajustement fin consiste donc désormais à télécharger des poids ouverts et à entraîner un adaptateur sur sa machine ou sur un GPU loué. Trois outils couvrent la plupart des cas :
- Mac (puce Apple) : MLX-LM entraîne avec
mlx_lm.lora --trainet prend en chargelora,doraetfull; quand--modeldésigne un modèle quantifié, l’entraînement devient automatiquement du QLoRA. Le dossier de données contienttrain.jsonl(et éventuellementvalid.jsonl) au formatchat,tools,completionsoutext. Si la mémoire manque, réduire--batch-size, diminuer--num-layersou ajouter--grad-checkpoint. - GPU NVIDIA et autres : le SFTTrainer de TRL applique automatiquement le modèle de conversation (chat template) aux données conversationnelles ; passer
peft_confign’entraîne que LoRA, et ajouter unequantization_configen 4 bits en fait du QLoRA. Les adaptateurs eux-mêmes sont gérés par PEFT. - Unsloth : prend en charge LoRA, QLoRA, l’ajustement complet, DPO et GRPO sur NVIDIA, AMD, Intel et macOS. L’accueil de sa documentation annonce un entraînement « 2× plus rapide avec 70 % de VRAM en moins, sans perte de précision » ; c’est l’affirmation du fournisseur, et la page ne dit pas par rapport à quoi.
QLoRA compresse en 4 bits le modèle de base figé, rétropropage le gradient à travers ce modèle 4 bits et ne met à jour que les adaptateurs LoRA. L’article s’en sert pour ajuster un modèle de 65 milliards de paramètres sur un seul GPU de 48 Go. Les 4 bits ne compressent que les poids figés ; la mémoire des activations croît toujours avec la taille du lot et la longueur des séquences, et la page processus d’entraînement détaille ce budget mémoire.
Une adaptation QLoRA en six étapes
Pour le routeur d’articles, le parcours complet est le suivant :
- Choisir un modèle de base ouvert dont la licence permet votre usage. Lire d’abord la licence : usage commercial autorisé ou non, droit de publier des poids modifiés. S’il faut conserver le dialogue et l’appel d’outils, partir de la version instruct, pas de la version de base.
- Écrire les données d’entraînement dans le modèle de conversation de ce modèle. Chaque exemple est une liste de
messages, et l’outil d’entraînement applique le modèle. La documentation Hugging Face sur les chat templates note qu’avec de mauvais jetons de contrôle, un modèle donne des résultats nettement moins bons. Ne calculer la perte que sur les réponses de l’assistant ; le masque de perte explique pourquoi. - Entraîner en QLoRA. Sur Mac, charger un modèle quantifié dans MLX-LM ; sur NVIDIA, utiliser TRL ou Unsloth. Avant le vrai lancement, surajuster une fois quelques dizaines d’exemples pour vérifier que données et perte sont bien branchées.
- Comparer avant et après sur le même jeu d’évaluation fixe. Fixer ce jeu avant de générer toute paraphrase ou donnée augmentée, sinon les variantes d’une même phrase se retrouvent à la fois en entraînement et en test ; voir partitions et fuites de données. Pour la façon de comparer et les réglages à consigner, voir évaluer un modèle sur ses propres tâches.
- Charger l’adaptateur dans le moteur réellement utilisé. MLX-LM le charge avec
--adapter-path, ou le fusionne dans les poids avecmlx_lm.fuse; le serveur llama.cpp charge un adaptateur GGUF avec--lora; en Python, utiliserPeftModel.from_pretrainedde PEFT. - Revérifier les appels d’outils et le format de sortie. Si les données d’entraînement ne contiennent aucun appel d’outil, le modèle peut perdre les formats JSON et d’outils qu’il respectait. Relancer donc les tests rapides de JSON exact et d’appel d’outil de votre évaluation ; si l’usage d’outils doit survivre, mettre des conversations avec appels d’outils dans les données d’entraînement (le format
toolsde MLX-LM et TRL les prennent en charge).
Concevoir une adaptation utile
Les règles pour partitionner les données et fixer le test sont dans partitions et fuites de données. Utiliser un jeu de validation étiqueté pour choisir rang, taux d’apprentissage, arrêt et seuils de classe.
Pour le routeur, mesurer rappel par classe, coût de suppression d’un document utile, latence à la longueur visée et fréquence de renvoi des cas incertains. Comparer à une règle simple et à l’encodeur figé avec tête entraînée. Inclure négations, quasi-doublons, nouveaux thèmes et changements de proportions de classes.
Les traces d’agents deviennent des données utiles seulement si leurs étiquettes décrivent des actions à reproduire. Une action historique n’est pas automatiquement correcte. Corriger les erreurs récurrentes avant de les utiliser comme supervision, puis calibrer les probabilités sur des données tenues à l’écart.
Le quicktour PEFT propose un exercice concret : configurer LoRA, lancer print_healthcheck() pour voir la part de paramètres entraînables et l’état de l’adaptateur, puis sauvegarder et recharger l’adaptateur. La sauvegarde n’écrit que deux fichiers, adapter_config.json et adapter_model.safetensors, et le chargement exige toujours le modèle de base ; comparer les deux montre ce que contient un checkpoint d’adaptateur.