训练过程:梯度、优化器与学习率
训练把样本和学习目标转化为参数更新。前向计算先给出预测,损失衡量预测与目标的差距,反向传播求出各参数的导数,优化器再决定怎样利用这些导数。四件事各有职责:把 Adam 换成 SGD,不会改变标签的含义,也修不好标错的数据。
《深度学习》的优化章节区分了两件事:把训练目标降下来,以及学到能泛化的预测器。训练损失负责指引更新;验证集负责判断这些更新对没见过的样本是否还有用。
手算一次更新
使用不带截距的模型 ,构造两个样本 。把损失定义为均方误差的一半:
从 开始,损失为 ,梯度为 。学习率取 ,按 更新后得到 ,损失降为 。负梯度说明在当前位置增大权重能减小误差,却没有保证任意大的增加都有用。
这组数据的损失还可以写成 。每次更新后,参数到最优点的距离满足:
因此,只有 时距离才会缩小。取 会在最优点两侧等幅振荡,继续增大会发散。这个阈值来自当前二次函数,不能直接当作神经网络的推荐学习率。
x, y = [1.0, 2.0], [2.0, 4.0]
w, learning_rate = 0.0, 0.1
for step in range(50):
    gradient = sum((w * a - b) * a for a, b in zip(x, y)) / len(x)
    w -= learning_rate * gradient
loss = sum((w * a - b) ** 2 for a, b in zip(x, y)) / (2 * len(x))
assert abs(w - 2.0) < 2e-6
print(round(w, 6), round(loss, 10))
这段标准库代码演示数值更新,没有划分测试集,不能据此判断预测能力。带截距的模型和可交互图示见线性回归。
为什么分批读数据
全量梯度每走一步都要遍历所有训练样本。小批量训练只取一部分样本来估计梯度。在适当的随机抽样和平均损失定义下,这个估计指向全数据梯度;但每一步的参数已经变化,实际方向也带有噪声。《动手学深度学习》从这个角度解释随机梯度下降。
一次 step 指一次优化器更新,一次 epoch 指遍历一遍训练集。1,000 个样本、每批 100 个,通常一轮有 10 次更新。若累计四批梯度才更新一次,有效批量和更新次数都会改变。梯度的平均方式也要一致:四个已经取均值的损失直接相加、不再除以四,会把梯度放大四倍。存在依赖批量的层或随机操作时,累计小批量也未必等价于一次大批量。
增大批量有时能让设备更忙,但会增加激活内存,并减少每遍数据中的更新次数。比较训练方案时,只报 epoch 会掩盖这些差异,应同时看处理了多少样本或 token、更新次数、耗时和质量。
优化器记住了什么
SGD 使用当前梯度;动量额外保存过去更新方向的移动平均,减少来回摆动;Adam 保存梯度的一阶、二阶矩估计,并据此调整各参数的步幅。这些状态也占内存。因此,一个推理时放得下的模型,训练时加上梯度、优化器状态和反向传播要用的激活,可能就放不下了。
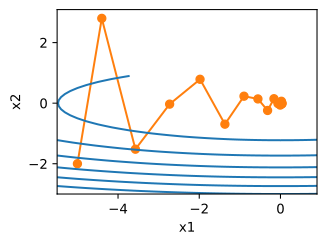 查看清晰大图
蓝线连接损失相同的位置,橙点是每次更新后的参数。这个独立的二维例子使用 f(x₁,x₂) = 0.1x₁² + 2x₂²,学习率为 0.6,动量系数为 0.5。轨迹先沿竖直方向摆动,再逐渐靠近最低点 (0, 0);在同一目标上,普通梯度下降使用这个学习率会发散。图中用的是二次函数的确定性梯度,摆动不来自小批量噪声,也不是上文标量 w 的轨迹。
三个优化器都从虚线圆圈出发,用同一个学习率 η 走 100 步。灰线连接损失相同的点,✕ 是最低点。
f(x, y) = 0.1x² + 2y²点击或轻触图面,可以换一个起点。
| 优化器 | (x, y) | 损失 | 上一步步长 |
|---|---|---|---|
| SGD | (−0.001, −1.3 × 10⁻²²) | 1.4 × 10⁻⁷ | 1.0 × 10⁻⁴ |
| 动量 | (−8.0 × 10⁻¹¹, −2.6 × 10⁻¹⁶) | 6.5 × 10⁻²² | 2.3 × 10⁻¹¹ |
| Adam | (0.021, 0.009) | 2.1 × 10⁻⁴ | 0.002 |
第 100 步: SGD 损失 1.4 × 10⁻⁷; 动量 损失 6.5 × 10⁻²²; Adam 损失 2.1 × 10⁻⁴
沿 y 方向的曲率 λ = 4,SGD 每走一步,y 方向的误差都乘以 1 − ηλ,这里它的大小是 0.6。只要 η 小于 2/λ = 0.5,这个大小就小于 1,SGD 会停下来;系数为负时,路径来回折返。 β = 0.5 的动量法只要 ηλ < 2(1 + β) 就保持稳定,这里即 η < 0.75。 动量把上一步的 0.5 加进新的一步,所以沿谷底越走越快。Adam 把每个坐标除以它梯度的滑动平均大小,步长总接近 η,与坡度无关:它不会爆掉,但 η 小时走得慢。
示意:二元函数的精确梯度,更新规则与 PyTorch 相同(动量 0.5,Adam β₁ = 0.9,β₂ = 0.999)。真实训练还有小批量噪声,维度也多得多。
PyTorch 的 AdamW 定义把权重衰减与自适应梯度更新分开。在当前 PyTorch 里,AdamW 就是打开了 decoupled_weight_decay=True 的 Adam,两种写法等价。因此,往损失中加 L2 惩罚,和设置 AdamW 的 weight decay 通常不能互换。比较正则强度前,先说明使用的定义,别直接搬用同一个系数。
优化器也不会自动找到普遍正确的学习率。输入尺度、初始化、批量组成和损失的平均方式都会影响合适的范围。Warmup 在训练初期逐渐提高学习率,衰减计划在后期逐渐降低。它们控制的是更新幅度,不能证明模型已经学会目标任务。
微调一个 7B 模型要多少显存
训练时显存里放着四样东西:权重、权重的梯度、优化器状态,以及反向传播要用的激活。拿一个 70 亿参数的模型算一遍。权重用 bf16 存,每个参数 2 字节,共 14 GB;梯度同样 14 GB;Adam 为每个参数各存一个一阶矩和一个二阶矩,用 fp32 存是 8 字节,共 56 GB。全参数微调还没算激活就要 84 GB,不少混合精度方案另存一份 fp32 主权重,再加 28 GB。
LoRA 冻结原有权重,只训练一小组适配器参数。假设适配器有 4,000 万个参数,约占 0.6%。适配器和它的梯度按 bf16 存,Adam 的两个矩按 fp32 存,梯度和优化器状态加起来不到 0.5 GB。冻结的权重仍要放进显存,所以 14 GB 这一项不变。QLoRA 再把冻结权重压成 4 bit,每个参数约半个字节,14 GB 降到约 3.5 GB,另加少量量化常数;梯度穿过这份冻结的 4 bit 模型,只更新适配器。论文用这个办法在一张 48 GB 显卡上微调了 650 亿参数的模型。
激活这一项 LoRA 和 QLoRA 都省不掉。梯度要从损失一路传回前面各层的适配器,途经的每一层都要用到前向时算出的中间结果。这些中间结果随批量大小和序列长度一起增长:同样的批量,序列从 512 个 token 加到 4,096 个,激活至少涨到 8 倍。显存不够时,先缩短序列或减小批量,再用梯度累计补回有效批量。还不够,就打开激活检查点:前向时丢掉中间结果,反向时重算一遍,用多花的计算换显存。
怎样读出训练失败
训练损失和验证损失都很高时,可以先尝试记住一个很小、标签干净的子集。如果连这也做不到,优先排查标签、梯度是否连通、损失定义和步长。小子集能拟合、全量数据不行,再考虑容量和优化预算。
训练持续变好、验证开始变差,说明新增更新正在拟合无法迁移的差异。调整正则化之前,先检查重复样本、同一用户或同一文档是否跨越了数据划分。用验证集选停止时机和超参数;每轮都看测试集,测试集实际上就成了另一份验证集。数据划分与泄漏进一步说明这条边界。
损失突然出现无穷或非数值时,要检查输入、除法、指数运算、梯度范数和数值精度。梯度裁剪能限制梯度范数,修不好无效标签或缺失值。损失不变也可能只是程序顺序写错:梯度清零太晚,或者意外跨 step 累积。
保存模型与恢复训练
只保存权重,足以再次运行预测。想接着同一条优化轨迹训练,还需要优化器、学习率调度器、更新计数,以及相关随机状态和数据读取位置。权重相同、动量重新置零,下一步仍可能不同。检查点也应附带预处理和标签定义,保证恢复后的模型读到相同的输入表示。