Calibration des probabilités, seuils de décision et abstention
Dix sorties successives à 0.99 ne démontrent pas la fiabilité d'un modèle. Il faut identifier l'événement prédit, puis comparer les prédictions aux fréquences observées dans des cas similaires. Exactitude, calibration et intérêt d'exécuter une action sont trois questions différentes.
Définir l'événement prédit
Imaginons un classificateur qui estime qu'un message au support nécessite un traitement humain, avec p = 0.8. Une bonne calibration signifie que, dans des données proches de l'environnement de déploiement, parmi les messages recevant environ 0,8, près de 80 % nécessitent réellement ce traitement. Elle ne garantit pas cette prédiction particulière et ne signifie pas que le modèle a compris 80 % du contenu. Le guide de scikit-learn présente cette interprétation fréquentielle.
Dans une classification multiclasse, « confiance » peut désigner la probabilité maximale. Ailleurs, ce terme renvoie à une entropie, une marge ou une tête indépendante. Il faut lire sa définition : concentrer toute la probabilité sur un mauvais choix peut donner une confiance élevée. Les probabilités de Jev et Laya s'interprètent selon leur interface et la tâche visée ; le nom du champ ne suffit pas à leur donner un sens commun.
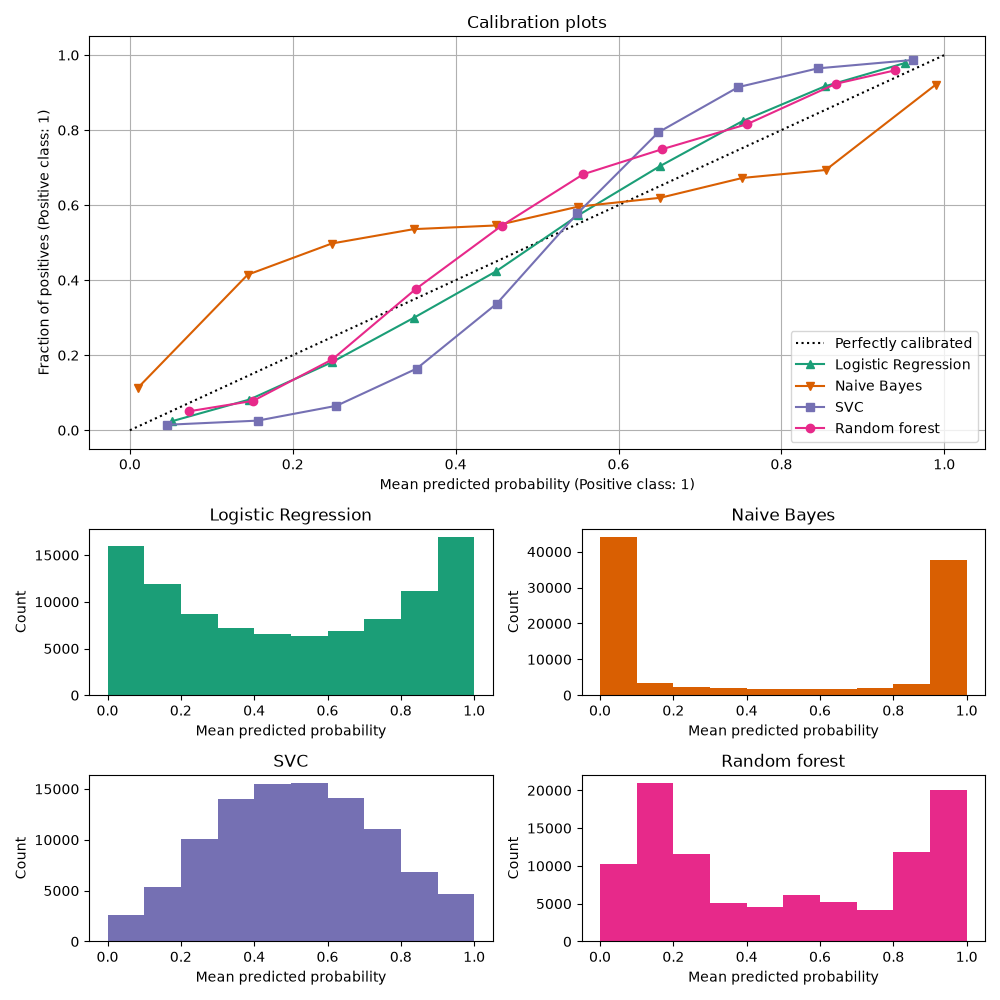 Voir l’image en grand
En haut, la diagonale représente une calibration parfaite. Une courbe située dessous indique moins de positifs que prévu. Les histogrammes montrent où se concentrent les prédictions. Ces résultats concernent un jeu de données d’exemple, sans établir de classement universel des modèles.
Exactitude et confiance peuvent diverger
Sur 100 exemples annotés indépendamment, supposons que le modèle attribue 0,9 à chaque classe choisie, mais ne réponde correctement que 70 fois. Son exactitude est de 70 %, sa confiance moyenne de 90 %. Ramener toutes ces confiances à 0,7 peut conserver les classes choisies et l'exactitude de 70 %, tout en améliorant l'accord fréquentiel de ce groupe.
Inversement, prédire toujours la proportion de positifs du corpus peut être globalement calibré sans distinguer les individus. Il faut donc examiner discrimination et calibration. Guo et ses collègues étudient la surconfiance des réseaux neuronaux et la calibration par température.
Une température positive T remplace softmax(z) par softmax(z / T) (l’effet de la température sur une softmax est expliqué dans régression softmax). Une température commune conserve l'ordre des classes tout en modifiant la concentration. Elle se règle sur des données de calibration, pas à l'intuition. Elle ne répare ni des candidats absents, ni des annotations erronées, ni une tâche que le modèle n'a pas apprise.
Trouver d’abord la probabilité d’un LLM
Quand un grand modèle classe ou oriente des requêtes, il ne fournit pas un p prêt à calibrer. Trois sources sont courantes, chacune moins fiable que la précédente.
La première est la probabilité des tokens. Quand le modèle ne produit qu’une étiquette (par exemple yes ou no), l’exponentielle de la log-probabilité (logprob) de ce token est la probabilité que le modèle lui attribue. L’API Chat Completions d’OpenAI renvoie la log-probabilité de chaque token de sortie avec logprobs, et top_logprobs liste jusqu’à 20 candidats à chaque position ; la même page précise que la prise en charge des paramètres varie selon le modèle, en particulier pour les modèles de raisonnement récents. Une réponse de l’API Gemini contient les champs avgLogprobs et logprobsResult. Si l’étiquette est découpée en plusieurs tokens, ou si le modèle écrit une explication avant l’étiquette, il faut combiner les probabilités des tokens concernés, ou limiter le format de sortie à la seule étiquette.
La deuxième est l’accord entre échantillons. On échantillonne N fois la même question à température non nulle et l’on prend la part de la réponse la plus fréquente comme score. La méthode d’auto-cohérence (self-consistency) choisit ainsi la réponse par vote majoritaire ; si 8 échantillons sur 10 répondent yes, le score vaut 0,8. Elle fonctionne avec toute API, au prix de N fois plus d’appels.
La troisième consiste à demander au modèle d’annoncer lui-même « confidence: 0.8 ». Xiong et al. (2023) ont constaté que les grands modèles ont tendance à être trop confiants quand ils verbalisent leur confiance, et que l’accord entre plusieurs réponses en corrige une partie. Un nombre annoncé par le modèle n’est donc qu’un score non calibré.
Les trois sources donnent des scores, pas encore des probabilités. Avant d’y fixer un seuil, répartir les données comme l’explique la section suivante, tracer un diagramme de fiabilité sur un ensemble de calibration étiqueté, et ajuster une correspondance si nécessaire.
Séparer les rôles des données
L'entraînement apprend le modèle ; la calibration ajuste la correspondance des probabilités ; la validation peut sélectionner les seuils et l'abstention ; un test final évalue le système fixé. La validation croisée aide lorsque les données manquent, mais l'étiquette qui évalue une prédiction ne doit pas avoir servi à la produire ou à la sélectionner.
Des messages presque identiques d'un même client, ou des passages d'un même document, ne doivent pas être dispersés entre ensembles puis considérés comme indépendants. Une utilisation future peut demander une séparation temporelle. Si la proportion de positifs change en production, probabilités et seuils peuvent devenir inadaptés malgré un bon classement.
Un diagramme de fiabilité compare probabilité moyenne et fréquence réelle par tranche, avec le nombre d'exemples. L'ECE résume leurs écarts, mais dépend du découpage et de l'effectif. Le score de Brier et la perte logarithmique évaluent l'ensemble des prédictions probabilistes ; aucun ne prouve à lui seul une meilleure calibration. Cet exemple binaire fictif calcule le score de Brier :
probabilities = [0.9, 0.8, 0.7, 0.1]
labels = [1, 1, 0, 0]
brier = sum((p - y) ** 2 for p, y in zip(probabilities, labels)) / len(labels)
print(round(brier, 4))  # 0.1375
La troisième prédiction, erronée et confiante, contribue 0.49, soit l'essentiel de l'erreur quadratique totale. Quatre exemples expliquent le calcul, sans permettre d'estimer la calibration d'un système réel.
Déduire le seuil des conséquences, plutôt que prendre 0,5 par défaut
Supposons qu'une action inutile coûte 9, qu'omettre une action nécessaire coûte 1, et qu'une décision correcte coûte 0. Si p estime de manière fiable la nécessité de l'action, agir coûte en moyenne 9(1-p) et ne pas agir coûte p. On agit lorsque le premier coût est inférieur, donc pour p > 0.9.
Ce modèle binaire est simplifié. Il faut ajouter, selon le cas, attente, contrôle humain et autres actions possibles. Les probabilités estiment les résultats, les coûts décrivent leurs conséquences, et les permissions déterminent les actions autorisées. Ces trois éléments ne sont pas interchangeables.
Rapporter la couverture avec l'abstention
Un système peut transmettre les cas incertains à une personne ou rechercher davantage de preuves, par exemple en ne traitant automatiquement que les demandes dépassant le seuil. Une exactitude de 99 % sur les demandes acceptées automatiquement doit être accompagnée de la proportion acceptée. Couvrir 1 % de demandes faciles ne vaut pas couvrir 90 % des demandes.
En augmentant progressivement le seuil, tracer la relation entre couverture et taux d'erreur des cas acceptés, puis l'examiner par langue, longueur et type de tâche. Des erreurs hors distribution peuvent rester très confiantes et franchir le seuil : l'abstention ne remplace pas le contrôle du domaine d'entrée. Si les données changent, recueillir des annotations représentatives et réévaluer toute la politique de décision plutôt que simplement relever le seuil.