Moindres carrés ordinaires et régularisation
Pour le modèle, les résidus et les mises à jour par gradient, commencer par la régression linéaire. Cette page explique comment résoudre directement le problème des moindres carrés, quand ses coefficients sont identifiables et quelles hypothèses supplémentaires permettent d’estimer leur incertitude.
Pour une matrice de conception , des cibles et un vecteur de coefficients , les moindres carrés ordinaires résolvent
La pseudo-inverse fournit une solution aux moindres carrés, . Lorsque les colonnes de sont presque linéairement dépendantes, de faibles variations des données peuvent entraîner de fortes variations des coefficients. Les prédictions peuvent rester acceptables alors que les coefficients individuels deviennent instables.
Du résidu à la solution
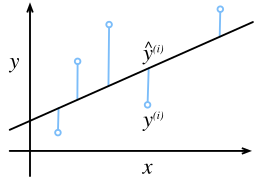
comporte lignes (observations) et colonnes (coefficients), avec et . Ajoutez une colonne de 1 pour ajuster une constante. Pour une droite , le résidu est un écart vertical dans l’unité de la cible, pas la distance minimale à la droite. Dans des coordonnées cartésiennes non redimensionnées, la distance perpendiculaire vaut ; la minimiser résoudrait un autre problème, autorisant aussi un déplacement en .
 Voir l’image en grand
Choisissez un point et rejoignez la droite verticalement, à x fixé : le point donne la valeur observée y, et la droite la prédiction ŷ. Chaque segment bleu représente la valeur absolue d’un résidu, plutôt que la distance perpendiculaire à la droite. OLS cherche la droite qui minimise la somme des carrés de ces écarts verticaux. Cette illustration de D2L utilise ses propres données ; le calcul sur trois observations ci-dessous constitue un autre exemple.
L’objectif conserve les mêmes minimiseurs OLS et donne
La Hessienne est semi-définie positive : un gradient nul correspond donc à un minimum global. L’annuler donne les équations normales :
Si (donc ), la solution est unique et vaut . Sinon, ajouter un vecteur du noyau de aux coefficients ne change pas les valeurs ajustées : les coefficients ne sont pas uniques. La pseudo-inverse de Moore–Penrose choisit le vecteur de norme euclidienne minimale ; les valeurs ajustées sur l’entraînement restent uniques. Par exemple, des colonnes identiques n’identifient que la somme de leurs coefficients. Les prédictions peuvent diverger si de nouvelles entrées ne respectent plus cette relation entre colonnes.
Utilisez un solveur de moindres carrés fondé sur QR ou SVD plutôt qu’une inversion explicite ; former élève au carré le conditionnement spectral lorsque est de rang colonne plein. Le guide des modèles linéaires de scikit-learn présente OLS et sa résolution par SVD.
Trois observations à la main
Prenons . La colonne constante et la colonne sont indépendantes. Avec et ,
Les prédictions sont , les résidus et leur somme de carrés vaut . Les égalités et vérifient les équations normales. La référence constante, moyenne d’entraînement , obtient une somme de carrés de . Cette comparaison porte sur l’entraînement, pas sur la généralisation.
from math import isclose
from statistics import mean

x, y = [0, 1, 2], [1, 2, 2]
xbar, ybar = mean(x), mean(y)
sxx = sum((v - xbar) ** 2 for v in x)
if sxx == 0:
    raise ValueError("A constant x cannot identify slope and intercept separately")
a = sum((u - xbar) * (v - ybar) for u, v in zip(x, y)) / sxx
b = ybar - a * xbar
r = [v - (b + a * u) for u, v in zip(x, y)]
assert isclose(a, 0.5) and isclose(b, 7 / 6)
assert isclose(sum(v * v for v in r), 1 / 6)
assert isclose(sum(r), 0, abs_tol=1e-12)
assert isclose(sum(u * v for u, v in zip(x, r)), 0, abs_tol=1e-12)
Ajustement et inférence statistique
Calculer le minimiseur ne nécessite aucune hypothèse gaussienne. Pour l’usage statistique, la documentation de régression statsmodels explicite le modèle de covariance des erreurs ; choisir une formule d’incertitude exige ce modèle supplémentaire. Sous un modèle de moyenne conditionnelle correctement spécifié , avec et un rang colonne plein, OLS est conditionnellement sans biais. Si, de plus, , alors
Pour , la somme des carrés résiduels divisée par estime sous ces hypothèses. Des erreurs conditionnellement gaussiennes justifient en outre l’inférence t/F exacte habituelle en échantillon fini. Des erreurs hétéroscédastiques ou corrélées nécessitent des estimateurs d’incertitude adaptés ; les erreurs-types robustes ne corrigent ni une mauvaise moyenne conditionnelle ni la confusion causale. Un intervalle pour la réponse moyenne diffère d’un intervalle de prédiction pour une nouvelle observation bruitée.
Les grands résidus peuvent dominer la perte quadratique, et les observations à fort levier (valeurs de variables inhabituelles) déplacer fortement la droite. Examinez les résidus selon les valeurs ajustées et le temps, puis comparez les erreurs sur données réservées à une référence avant d’interpréter les coefficients.
Objectifs pénalisés
Ci-dessous, et . Pour ces formules pénalisées, centrez avec les moyennes d’entraînement et ne mettez que les pentes dans ; retrouvez la constante non pénalisée par . Mettez les variables à l’échelle dans les plis d’entraînement, car les pénalités dépendent des unités. La normalisation fait partie de la définition : Ridge dans scikit-learn utilise , donc la formule Ridge ici correspond à . Les conventions Lasso et Elastic Net correspondent à , avec l1_ratio égal à . À identique, le terme Ridge d’Elastic Net avec a la moitié de l’intensité de celui de la formule Ridge ci-dessous.
Ridge
Ridge réduit les coefficients corrélés ou mal identifiés et les conserve généralement tous non nuls.
Lasso
La pénalité peut amener des coefficients exactement à zéro. Cette parcimonie est une propriété de l’objectif ajusté ; elle ne prouve pas que les variables retenues sont les seules importantes ni qu’elles sont causales. Avec des variables fortement corrélées, le membre sélectionné peut être instable.
Elastic Net
Elastic Net associe la parcimonie à la stabilisation de Ridge et se révèle souvent utile lorsque les prédicteurs forment des groupes corrélés.
Règles pratiques
- Ajuster la mise à l’échelle et les transformations de base uniquement sur les données d’entraînement ; appliquer ensuite la transformation enregistrée aux données de validation et de test.
- Ne pas pénaliser l’ordonnée à l’origine, sauf si la formulation le prévoit explicitement.
- Choisir et au moyen de la validation ou de la validation croisée au sein du processus d’entraînement.
- Comparer l’erreur de prédiction, la stabilité des coefficients et la simplicité opérationnelle, pas seulement la perte d’entraînement.
- Employer des objectifs robustes ou quantiles lorsque l’erreur quadratique ne représente pas la cible ou le coût des erreurs souhaité.
- Séparer la modélisation prédictive des affirmations inférentielles ; l’estimation de l’incertitude exige des hypothèses explicites sur le processus de génération des données.
Les variables polynomiales et les interactions peuvent rendre la relation avec les entrées non linéaire tout en conservant des coefficients ajustés linéaires. Le modèle obtenu hérite néanmoins des risques d’extrapolation et de surajustement liés à la base choisie.
Consultez le guide des modèles linéaires de scikit-learn pour les solveurs actuels et les API des estimateurs.