聚类与降维
聚类回答“按照某种相似性,哪些样本应该放在一起”;降维回答“能否用更少的坐标表示这些样本”。两者可以连用,但分得再整齐,分出来的组也不一定是你关心的类别。
例如,把文档向量聚在一起,可以帮助查看反复出现的主题;把向量压成两个坐标,可以帮助画图。图上分出来的几团,可能是按语言分的,可能是按长度或来源网站分的,碰巧才是按你关心的主题分的。要知道是哪一种,得回到原文去看。
距离也是模型的一部分
假设样本包含以秒计的时长,以及一到五分的评分。原始欧氏距离中,100 秒的差异可能淹没两分的差异。逐维标准化会改变几何关系,却不会发现唯一正确的距离。应根据任务要比较什么来选择尺度,并用拟合数据估计标准化统计量。
对长度归一化后的向量 :
也就是说,两个单位向量越像( 越大),它们的欧氏距离就越小,所以这时按欧氏距离找最近邻和按余弦相似度排序,结果一样。没归一化的向量不满足这个等式。就算样本都归一化了,K-means 按欧氏距离分组和按余弦分组仍可能不同:K-means 的中心是几条单位向量的平均,长度一般小于 1,不在单位球面上,上面的等式对中心不成立。Embedding、Reranker 与分类器说明向量模型在聚类之前已经做了什么选择。
K-means 交替分配与求均值
K-means最小化样本到所属中心的平方距离之和。一次常见迭代先把每个样本分给最近中心,再用组内均值更新中心。它可能停在局部解,所以初始化有影响。
构造一维数据 ,初始中心为 0 和 10。分组为 与 ,更新后的中心是 和 。组内平方距离总和为 。如果只设一个组,中心为 5,平方距离和为 。增加组数能继续降低这个目标,却未必增加有用解释。
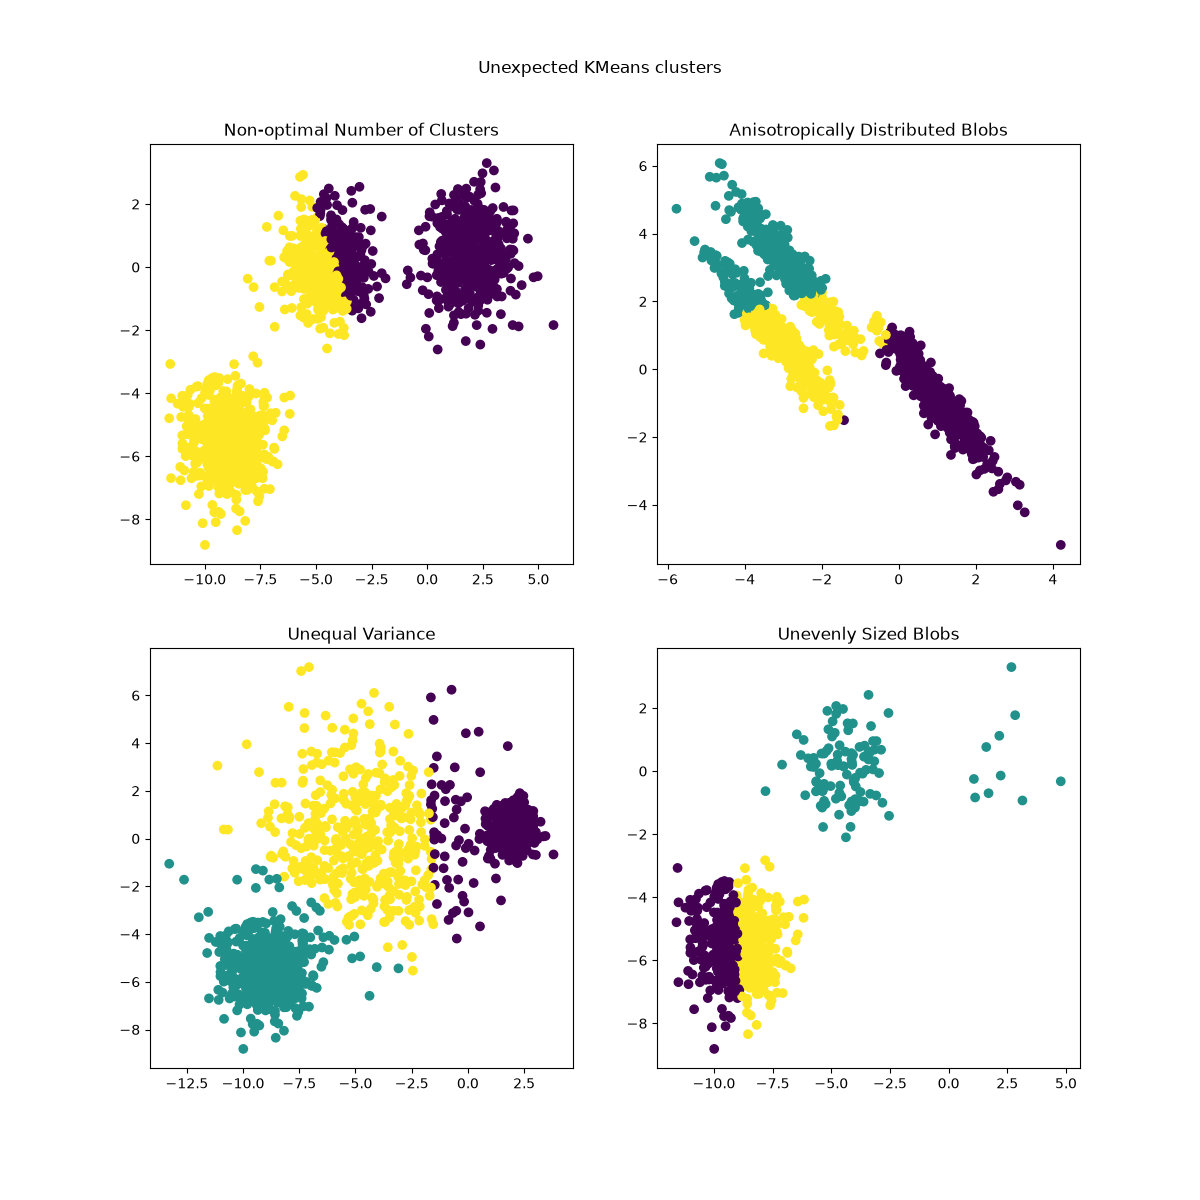
K-means 偏好围绕均值的紧凑分组,并要求提前指定 。密度不均、细长形状、异常值或不合适的距离都会误导分组。DBSCAN 等密度方法连接稠密邻域,可以把一些点标成噪声,但邻域尺度仍是实质性的选择。层次聚类给出逐层合并关系,使用哪种 linkage 决定了两组之间怎样算近。
 查看清晰大图
颜色表示 K-means 给出的分组。对照拉长的簇、不同离散程度和不同簇大小:按到中心的距离划分,可能切开原本期待的群体。四格分别展示不同失效情形,不是同一个数据集的四种视图。
PCA 保留变化,不直接保留标签
主成分分析 PCA从中心化数据中寻找相互正交的变化方向。保留主要方向,可以得到更低维的线性表示,并重建原坐标。它不读取类别标签。
取三个点 ,均值为 。中心化后是 ,第一主方向为:
投影得到 。把每个标量乘回 ,再加均值,就能完整恢复原始点。垂直方向 没有变化。这组构造数据位于一条直线上,所以一个坐标已经够用。
若要看两个非零奇异值的情况,特征值与 SVD算出了主成分得分、解释方差和重构误差。
换一组数据就能看到 PCA 丢掉要紧的东西。假设每篇文档有两个特征:长度在 200 到 20000 字之间变化,“和已存文档的重合度”只在 0.9 到 1 之间变化。不做标准化时,两者的取值范围差了 19800 ÷ 0.1 = 198000 倍,方差差得更多。PCA 只看方差,第一主成分几乎全是长度,重合度那一维排在最后被丢掉,可判断一篇是不是重复,靠的正是它。所以解释方差高,不等于任务要的信息留下来了;要在同一批留出样本上,比较降维前后下游任务的表现。
二维图只是一个视角
t-SNE 等非线性嵌入优先保留某些邻域关系,不会保留所有全局距离。图中很大的空隙或很小的簇,可能是超参数和初始化造成的。同样,一个类别在图上占的面积,也说明不了它在现实中占多大比例。
做探索时,保留原向量和文档标识,生成可视化后,再抽查明显分组及边界附近的样本。检查合理改变预处理、抽样后,分组是否仍然存在。如果用已知标签上色,应明确颜色来自人工标签,不是算法自己发现的语义。
没有标签怎样评价
轮廓系数等内部指标,比较所选距离下组内和组间的分离程度。它可能偏好与实际用途无关的几何结构。若目的是整理文档供人浏览,还要看读者是否更容易找到材料,以及代表文档是否能解释分组。
有参考标签时,可以用外部一致性指标比较两种分法,比如调整兰德指数(ARI):它只看两种分法是不是把同样的样本放在一起,不管组的编号叫 1 还是 2。但不一致也可能意味着另一种有效分组:按主题标注的数据,可能被按语言聚类。先决定需要哪种区分,再谈结果对错。
如果降维服务后续预测,标准化和 PCA 都只能在训练数据上拟合,再变换验证与测试数据。先在全量上做 PCA 再划分,会让表示提前接触评价分布。如果只是描述整个集合,使用全量数据可以是有意选择,但不能把这张图说成独立预测测试。
检查后若形成了可靠标签,可以让监督分类器或树模型直接学习所需区别。聚类适合探索,给一组样本编号则不等于获得了经过验证的决策标签。
聚类还有一个直接的用处:标注评测集之前,先把自己的提示词或日志转成向量再聚类。同一簇里几乎一样的样本只留一条,再从每簇各抽几条去标注。这样几十条标注能覆盖更多种请求,近重复样本也不会同时落进调参集和测试集,见数据划分与泄漏表中“重复/近重复”一行。
在 How to Use t-SNE Effectively 中,对同一组数据改变 perplexity 和迭代步数,比较簇的大小与间距如何变化。先做这个实验,再解释自己的散点图:图上分开的“小岛”,未必对应原空间里稳定分离的群体。