Tokenisation et représentations du texte dans un modèle
Avant de traiter une phrase, un modèle transforme le texte en identifiants issus d’un vocabulaire fini, puis récupère des vecteurs dans une table. Les couches calculent ensuite des représentations dépendantes du contexte : un même identifiant peut produire des états différents selon la phrase. Cela distingue trois questions : combien de tokens coûte un caractère chinois, peut-on remplacer le tokenizer, et les états cachés conviennent-ils à la recherche ?
Les tokens servent à encoder le texte
Un vocabulaire de mots entiers rencontre des mots nouveaux, des variantes orthographiques et des composés ; un découpage en caractères peut allonger fortement les séquences. Les travaux de Sennrich et al. sur les sous-mots représentent les mots rares par de petits fragments réutilisables. Un token peut être un mot, un fragment, un signe de ponctuation ou une suite d’octets. Ses limites dépendent du tokenizer.
BPE part de petites unités et fusionne à répétition la paire adjacente la plus fréquente en un nouveau fragment. Faisons un tour à la main sur un corpus minuscule : low apparaît 7 fois et log 3 fois, tous deux d’abord découpés en lettres. Parmi les paires de lettres voisines, l+o figure dans les deux mots, soit occurrences, le maximum : on fusionne en lo. On recompte : lo+w apparaît 7 fois et lo+g 3 fois, donc lo+w devient low.
L’ordre des fusions, une fois enregistré, constitue les règles du tokenizer ; un mot nouveau comme lows, fusionné dans le même ordre, se découpe en low et s.
WordPiece utilise ses propres procédures d’apprentissage du vocabulaire et d’appariement. Unigram attribue des probabilités aux segmentations possibles. Tous découpent selon des statistiques ; aucun ne consulte un dictionnaire pour comprendre le sens. La documentation de Hugging Face les distingue. SentencePiece permet notamment d’entraîner BPE ou Unigram sur des phrases brutes, sans exiger une segmentation préalable par espaces ; voir son article.
Dans un vocabulaire pédagogique fictif, 重新加载 (« recharger ») est encodé en deux tokens, 重新 et 加载 ; un autre vocabulaire pourrait utiliser quatre caractères séparés.
Le découpage du chinois par un tokenizer réel part des octets : en UTF-8, un caractère chinois courant occupe 3 octets, et certains caractères rares 4. Un BPE au niveau des octets fusionne en 1 token les octets des caractères fréquents dans son corpus d’entraînement, tandis qu’un caractère rarement vu peut être coupé en plusieurs fragments d’octets. « Combien de tokens par caractère chinois » n’a donc pas de réponse fixe : il faut compter avec le tokenizer du modèle choisi, sans ratio fixe entre caractères et tokens.
Pour la même raison, une couverture complète des octets permet d’encoder des caractères inconnus, mais cette capacité n’établit pas la compréhension d’une langue. Caractères rares, emoji, mélanges de langues et longues suites de chiffres peuvent occuper beaucoup de tokens.
Un tout petit tokenizer BPE apprend sur le texte d’entraînement, une fusion à la fois : il compte chaque paire de symboles voisins et réunit la plus fréquente en un nouveau token. Les deux phrases ci-dessous sont encodées avec les fusions apprises jusque-là. Choisissez un token pour suivre son identifiant jusqu’à la table d’embeddings.
1 · Apprendre les fusions
Fusion 14 : ▁r + at → ▁rat, vue 2 fois. Vocabulaire : 282. Plus aucune paire voisine n’apparaît deux fois : l’entraînement s’arrête après 14 fusions.
▁the▁cat▁sat▁on▁the▁mat.
▁the▁rat▁sat▁on▁the▁hat.
▁the▁cat▁ate▁the▁rat▁on▁a▁mat.
2 · Encoder deux phrases
Anglais 22 caractères → 6 tokens
Chinois 6 caractères → 19 tokens
Les tokens en pointillé comme <E7> sont des octets isolés. Un caractère absent du texte d’entraînement est écrit avec ses octets UTF-8. Ajoutez du chinois au texte d’entraînement et regardez le nombre baisser.
3 · Token → identifiant → ligne d’embedding
▁cat a l’identifiant 275 : le modèle lit la ligne 275 de la matrice d’embeddings E (282 lignes × 4 colonnes). L’identifiant n’est qu’un numéro de ligne.
| # | Token | ID | Ligne de E | |||
|---|---|---|---|---|---|---|
| 1 | ▁the | 271 | −0.4 | 0.86 | −0.52 | −0.76 |
| 2 | ▁cat | 275 | −0.12 | 0.09 | 0.14 | −0.09 |
| 3 | ▁sat | 277 | 0.45 | −0.62 | 0.33 | 0.07 |
| 4 | ▁on | 273 | 0.31 | −0.03 | 0.67 | −0.73 |
| 5 | ▁the | 271 | −0.4 | 0.86 | −0.52 | −0.76 |
| 6 | ▁mat | 279 | −0.76 | −0.95 | 0.1 | 0.4 |
Illustration : un BPE jouet avec repli sur les octets, entraîné seulement sur les phrases affichées ; ses comptes ne sont ceux d’aucun tokenizer réel. ▁ marque le début d’un mot. Les valeurs d’embedding sont des nombres aléatoires à graine fixe, à la place de poids entraînés.
Des identifiants aux vecteurs
Pour un vocabulaire de taille et une largeur cachée , une matrice entraînable fournit sa ligne pour l’identifiant . Un identifiant est un indice : 20 ne signifie pas deux fois ce que signifie 10.
Reprenons le vocabulaire fictif ci-dessus et supposons qu’il contienne BOS=0, 重新=1, 加载=2, où BOS est un token spécial marquant le début de la séquence. L’entrée [BOS, 重新, 加载] a pour identifiants [0,1,2], qui sélectionnent trois lignes. Pour un lot de taille 2, une longueur complétée à 5 et une largeur 4 :
La consultation équivaut à multiplier un vecteur one-hot de longueur par la matrice, sans devoir allouer ce grand vecteur. Ce petit programme Python illustre uniquement cette opération, sans rien entraîner :
embedding = [[0.0, 0.1], [0.5, -0.2], [-0.1, 0.8]]
ids = [0, 1, 2, 1]
x = [embedding[i] for i in ids]
assert x[1] == x[3]  # Un même identifiant donne le même vecteur initial.
Dans les couches contextuelles, un identifiant ne correspond plus à un seul vecteur. Même si bank porte le même identifiant dans « my bank account » et « the river bank », il reçoit des représentations différentes parce que le contexte visible diffère. L’attention décrit l’opération qui actualise ces représentations.
L’ordre et les positions valides font partie de l’entrée
Un ensemble non ordonné de vecteurs ne distingue pas « le chat poursuit le chien » de la phrase inverse. Il faut une information de position. Le Transformer original ajoute des vecteurs positionnels à l’entrée ; RoPE effectue des rotations des requêtes et des clés dans l’attention. Ces opérations interviennent à des endroits différents : l’« encodage positionnel » ajoute tantôt un vecteur à l’entrée, tantôt modifie les requêtes et les clés de l’attention ; voir l’architecture Transformer.
Pour réunir des séquences de longueurs 3 et 5, on peut compléter la première jusqu’à 5. Ce remplissage occupe des positions du tenseur, mais ne devrait généralement ni fournir du contenu valide à l’attention ni contribuer aux cibles supervisées. Le masque d’attention et le masque de perte ont des fonctions distinctes. Exclure une position du calcul de perte n’empêche pas les autres de la consulter. Les bibliothèques peuvent traiter séparément causalité, remplissage et indices de position ; il faut respecter les conventions du modèle.
Les gabarits conversationnels ajoutent des marqueurs de rôle, des limites de message et des marqueurs de génération. Le comptage doit porter sur l’entrée effectivement sérialisée ; c’est elle que comptent les points d’accès des fournisseurs. La troncature supprime des informations ; augmenter le budget de sortie ne rétablit pas une condition supprimée de l’entrée.
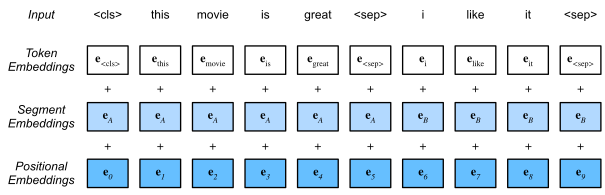 Voir l’image en grand
Lire une colonne verticalement : BERT additionne trois vecteurs de même dimension. La première ligne représente le token, la ligne A/B son segment et la dernière sa position. Le séparateur répété conserve son embedding de token, mais change de segment et de position. Cette construction est propre à BERT ; les modèles utilisant RoPE introduisent la position ailleurs.
Trois sens du mot embedding
Le plongement de token est le vecteur initial obtenu dans la table. L’état caché contextuel est la sortie d’une position dans une couche. Un vecteur de recherche représente généralement une phrase ou un document après une agrégation définie et un entraînement adapté. Ces objets peuvent avoir la même dimension tout en remplissant des rôles différents.
Faire la moyenne de [batch,sequence,d] donne aussi un vecteur, mais son utilité pour la recherche dépend de l’objectif pour lequel il a été entraîné ; voir plongements, rerankers et classifieurs.
Compter avant de payer
Prix, limites de débit et fenêtres de contexte se mesurent tous en tokens : compter une requête avec le point d’accès du fournisseur avant de l’envoyer. Au 2026-10-29, les trois principaux sont :
count_tokenschez Anthropic accepte les mêmes entrées que la création d’un message, y compris prompt système, outils, images et PDF. La documentation présente ce nombre comme une estimation, qui peut différer légèrement de l’usage réel.POST /v1/responses/input_tokenschez OpenAI accepte la même entrée que l’API Responses. La documentation note que les tokenizers locaux comme tiktoken conviennent au texte brut mais ont des limites ; le nombre renvoyé inclut aussi les tokens de format, comme les rôles et les limites de message, qu’un découpage local du seul texte ne voit pas.countTokenschez Gemini ne compte que l’entrée. Son ordre de grandeur : un token vaut environ 4 caractères, et 100 tokens environ 60 à 80 mots anglais.
Le comptage change aussi d’une génération à l’autre chez un même fournisseur. La documentation d’Anthropic indique que Claude 4.7 et les modèles suivants, ainsi que Claude Mythos Preview, utilisent un nouveau tokenizer. Le même texte produit environ 30 % de tokens en plus, l’écart exact dépendant du contenu ; la documentation conseille de recompter sur le modèle visé plutôt que de réutiliser des comptes faits sur les anciens modèles. Un prompt compté à 10 000 tokens sur un ancien modèle en fait environ 13 000 sur un nouveau, et à prix unitaire égal son coût d’entrée augmente d’environ 30 %.
Avec un modèle local, le tokenizer est sous la main. Choisir quelques exemples : phrases équivalentes en chinois et en anglais, code avec et sans espaces, caractère rare, puis la même phrase en texte brut et dans le gabarit conversationnel. Relever identifiants, longueurs, tokens spéciaux et textes décodés. Certains tokenizers normalisent le texte : decode(encode(text)) ne restitue donc pas forcément les octets originaux. Poids, tokenizer, configuration des tokens spéciaux et gabarit forment un ensemble assorti. Changer seulement le vocabulaire modifie le sens des identifiants, alors que les lignes apprises correspondent toujours aux anciens fragments.
La suite, Encoder, Decoder et Encoder–Decoder, explique notamment quelles positions chaque token peut consulter.
Le cours BPE de Hugging Face construit un tokenizer à partir des fréquences de mots et de paires. Suivre une fusion, puis appliquer les règles à un nouveau mot, rend concrète la différence entre apprendre un vocabulaire et utiliser un tokenizer existant.