Embeddings, reclasseurs et classificateurs : similarité, pertinence et décision
« Exécuter BERT en local » ne décrit pas encore une capacité. Une même famille d'encodeurs peut recevoir différentes têtes de sortie et apprendre selon différents objectifs. Produire un vecteur, noter un couple question–document et choisir une action correspondent à des interfaces distinctes, quel que soit le lieu d'exécution.
Identifier les entrées et les sorties
Sentence-BERT apprend des représentations de phrases destinées à comparer leur similarité. La question n'est pas de savoir si BERT produit des états cachés, mais si l'entraînement rend leurs distances utiles pour la tâche. Faire la moyenne de vecteurs de tokens quelconques ne crée pas automatiquement un bon moteur de recherche.
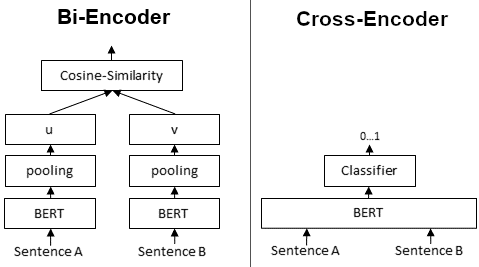
Le bi-encodeur traite séparément questions et documents : les documents n'ont pas à être recalculés pour chaque requête. Le cross-encoder traite les deux ensemble et permet à leurs tokens d'interagir pendant un même passage. L'exemple de recherche puis reclassement illustre cette répartition. Certains modèles produisent un score brut sans borne inférieure ni supérieure ; d'autres le ramènent entre 0 et 1. Son nom ne prouve pas qu'il s'agit d'une probabilité calibrée.
 Voir l’image en grand
Lire les flèches de bas en haut. À gauche, chaque phrase devient un vecteur réutilisable avant la comparaison par cosinus. À droite, les deux phrases entrent ensemble dans BERT : changer de candidat impose de recalculer la paire. La recherche peut donc indexer les vecteurs des documents, tandis que le reclassement traite généralement une sélection réduite. La sortie entre 0 et 1 dépend de la tête représentée ; elle ne garantit pas une probabilité calibrée.
Un même système peut employer les trois
Prenons un assistant documentaire fictif auquel on demande comment transcrire des enregistrements de réunions hors ligne. La recherche vectorielle retrouve 50 notes sur la parole et l'inférence locale ; un reclasseur met en avant les 5 qui précisent le matériel et les restrictions hors ligne ; un classificateur choisit ensuite « répondre », « poursuivre la recherche » ou « demander une précision ». Les candidats passent de 50 notes à 5, puis à une seule action.
Ce que chaque étape apprend à l'entraînement diffère : similarité, pertinence d'un passage pour une question, puis action adaptée à un état de tâche. Une note très pertinente peut être obsolète. Une action facile à prédire peut être interdite. La pertinence ne remplace pas la vérification des versions, ni les probabilités d'action l'autorisation des outils (voir Contrats d’outils pour les agents d’IA).
Un classificateur d'actions n'a pas besoin d'étiquettes fixes : le modèle peut noter la description de chaque action candidate avec l'entrée, si bien qu'ajouter une option revient à écrire une description de plus. Jev et Laya : modèles de décision structurée traite ce cadre de décision structurée et ses limites.
La similarité n'est pas une probabilité
Cet exemple calcule le produit scalaire de vecteurs unitaires inventés. Aucun modèle n'est chargé.
from math import sqrt

def unit(v):
    length = sqrt(sum(x * x for x in v))
    return [x / length for x in v]

query = unit([1, 1, 0])
documents = [[1, 0, 0], [0, 1, 0], [0, 0, 1]]
scores = [sum(a * b for a, b in zip(query, unit(d)))
          for d in documents]
print([round(s, 3) for s in scores])  # [0.707, 0.707, 0.0]
Les deux premiers documents forment le même angle dans cette représentation. L'un pourrait contenir la procédure exacte, l'autre seulement mentionner le sujet. 0.707 ne signifie pas 70,7 % de chances d'avoir raison. Un softmax appliqué aux scores change les valeurs normalisées lorsqu'on ajoute dix candidats inutiles, alors que les documents initiaux restent identiques.
Déclencher des actions à partir de scores demande des annotations propres à la tâche, des coûts d'erreur et une vérification de la calibration (voir Calibration des probabilités, seuils de décision et abstention). Qualité du classement, exactitude de classification et fiabilité des probabilités sont distinctes.
L’effet de la métrique et de la normalisation sur les voisins, ainsi que les omissions possibles de la recherche approximative, sont expliqués dans Index vectoriels : recherche exacte, HNSW et IVF.
Comparer des modèles locaux sur le même travail
Pour la recherche, utiliser des questions associées à des documents pertinents et mesurer rappel et classement. Pour le choix d'action, utiliser des états de tâche avec actions autorisées et résultats, puis mesurer erreurs, abstention et latence. La vitesse d'encodage vectoriel et la latence de notation de nombreux couples ne décrivent pas la même opération.
Fixer aussi langue, longueur, nombre de candidats, matériel, précision, taille de lot et démarrage à froid ou à chaud. Un petit téléchargement ne garantit pas une exécution rapide sur de longs textes ou avec de nombreux candidats. Une fois l'interface identifiée, Recherche documentaire : découpage, rappel, reclassement et citations et Performance d’inférence : chargement, premier token, décodage et débit permettent de remplacer « BERT local » par des tâches comparables.
Pour un point de départ sur des textes mêlant chinois et anglais, essayer un modèle multilingue local comme potion-multilingual-128M, qu'utilise la base minimale de la recherche documentaire ; le guide des modèles de zvec-grep liste d'autres candidats pour le code, l'anglais et les textes multilingues. Requêtes et documents doivent être encodés avec le même modèle et la même normalisation ; changer de modèle oblige à recalculer les vecteurs de toute la collection.