Transformers : architecture originale et blocs modernes
Un Transformer n’est pas synonyme d’attention. Il combine représentations des tokens, position, attention, sous-couches feed-forward, connexions résiduelles et normalisation. L’article de 2017 décrivait un encodeur–décodeur ; les blocs à décodeur seul courants ont depuis modifié de nombreux détails.
Cette page porte sur l’assemblage du bloc Transformer, les formes des tenseurs et le coût du calcul. La tokenisation développe la chaîne d’entrée ; les familles encodeur, décodeur et encodeur–décodeur expliquent contexte visible et têtes de sortie ; le décodage autorégressif transforme les scores du vocabulaire en réponses.
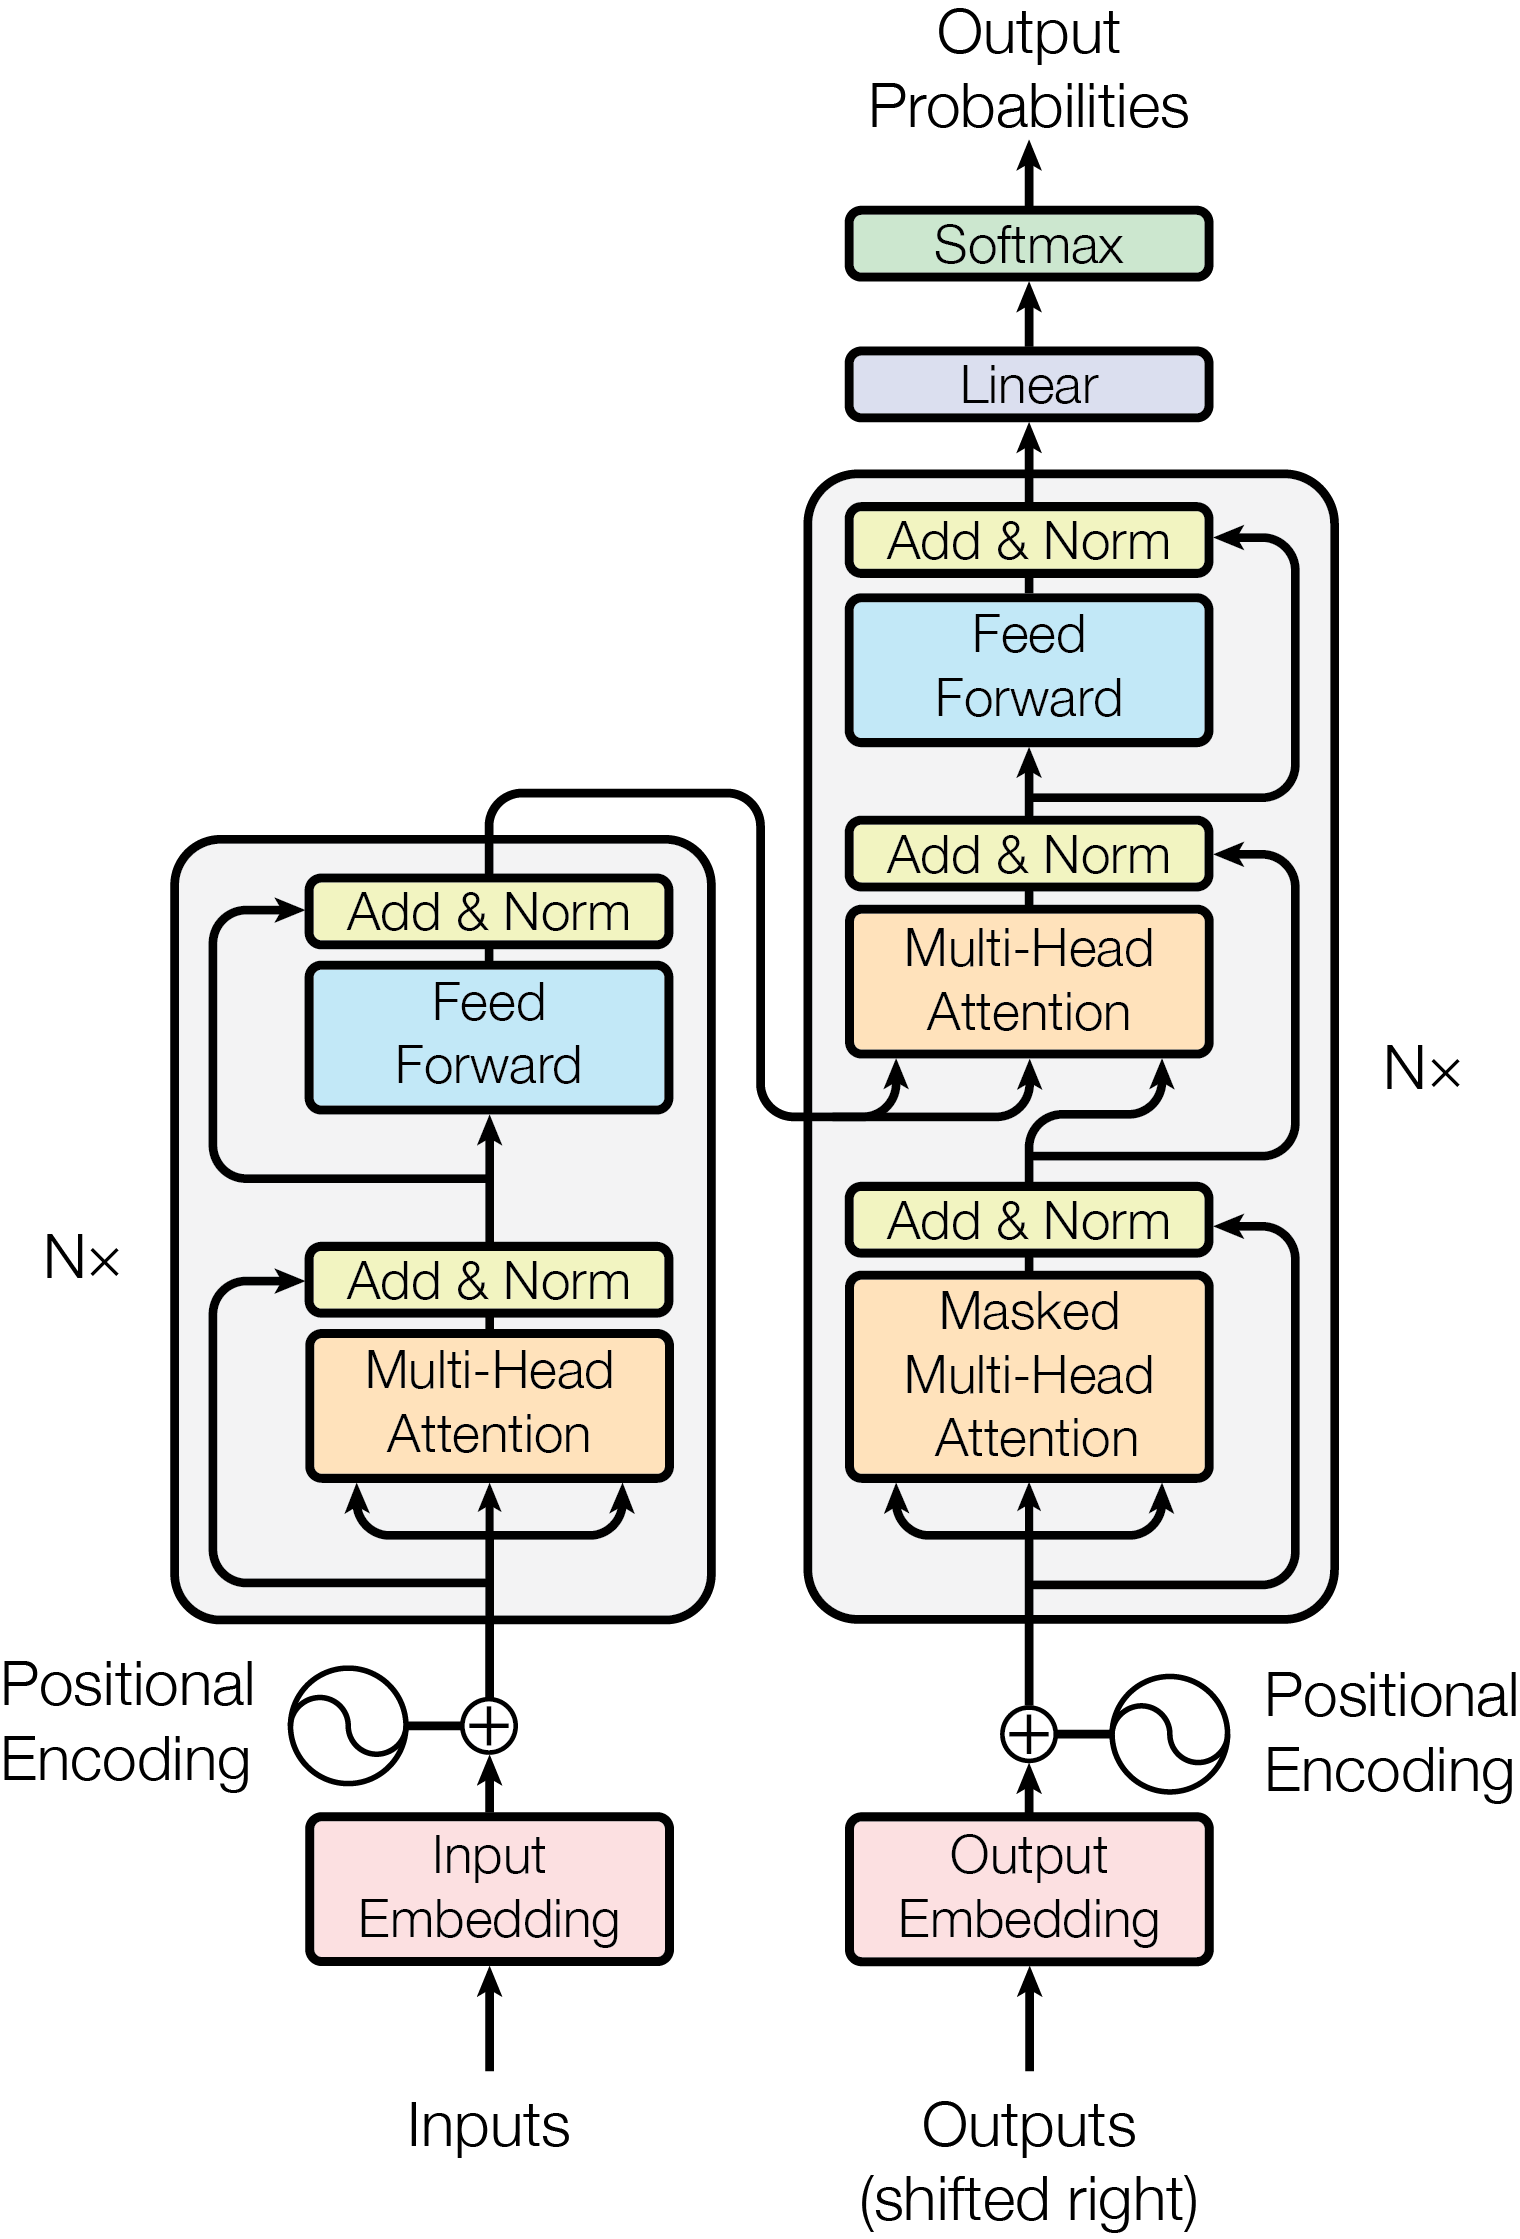 Voir l’image en grand
Lisez depuis les embeddings, en bas. L’encodeur à gauche traite l’entrée ; le décodeur à droite utilise les tokens précédents et les représentations de l’encodeur. Les flèches contournant les sous-couches sont les connexions résiduelles. Cette architecture originale est post-norm ; les variantes pre-norm et à décodeur seul décrites plus bas en diffèrent.
Du texte aux vecteurs d’entrée
Un tokenizer convertit le texte en éléments du vocabulaire et en identifiants entiers de tokens. Un token peut être un mot, un fragment de mot, un signe de ponctuation ou une unité au niveau des octets. Les frontières et les identifiants dépendent du tokenizer, pas seulement de la langue. Des tokens spéciaux peuvent marquer les limites de séquence ou les rôles des messages.
Prenons un vocabulaire purement illustratif : BOS=0, hello=1, world=2. La séquence [BOS, hello, world] devient [0,1,2]. Une table d’embeddings apprise fournit les lignes , soit une matrice , ou [1,3,d] avec un axe de lot. Les identifiants sont des indices de consultation, pas des mesures : l’identifiant 2 ne représente pas deux fois le sens de l’identifiant 1. Le Transformer original, §3.4, décrit ces embeddings d’entrée.
La position est intégrée selon l’architecture ci-dessous ; la pile rend ensuite les vecteurs dépendants du contexte. Un embedding de token d’entrée n’est pas automatiquement un vecteur de phrase ou de document adapté à la recherche. La projection de sortie sur le vocabulaire, décrite dans la section d’entraînement, ferme le parcours du texte aux vecteurs puis aux tokens.
Tenseurs principaux
Pour , des projections apprises produisent Q, K et V. Avec têtes de requête et , les formes courantes sont :
Q: [batch, h_q, sequence, d_h]
K: [batch, h_kv, sequence, d_h]
V: [batch, h_kv, sequence, d_h]
L’attention multi-têtes (MHA) utilise ; l’attention multi-requêtes (MQA) utilise ; l’attention à requêtes groupées (GQA), dans le cas intermédiaire, emploie . L’article GQA inclut aussi MHA et MQA comme cas limites. MQA et GQA réduisent surtout le trafic du cache KV, pas le nombre de requêtes, et ne garantissent pas une qualité identique.
La formule d’attention exige des têtes correspondantes : on ne peut pas multiplier aveuglément les tenseurs Q et K affichés. Pour des groupes contigus de même taille, doit être divisible par ; posons . La tête de requête , numérotée depuis zéro, partage la tête KV :
Avec huit têtes de requête et deux têtes KV, les requêtes 0–3 utilisent la tête KV 0 et les requêtes 4–7 la tête KV 1. Chaque sortie a la forme [batch, sequence, d_h] ; concaténer les huit sorties restaure la largeur . Répéter explicitement K/V par groupe illustre le calcul, mais les kernels efficaces peuvent les partager sans matérialiser les copies.
Un bloc ne se réduit pas à l’attention
Un FFN simple s’écrit :
Les blocs modernes utilisent souvent SwiGLU ou GEGLU, avec des projections distinctes pour la porte et la valeur. Les FFN concentrent souvent la majeure partie des paramètres et du calcul d’un bloc.
L’ordre des résidus et de la normalisation varie lui aussi :
- Post-Norm original : ;
- Pre-Norm courant : .
Pre-Norm rend souvent l’entraînement des réseaux profonds plus stable, mais n’est pas mathématiquement équivalent à Post-Norm. LayerNorm centre les valeurs et remet leur variance à l’échelle ; RMSNorm les remet à l’échelle par leur moyenne quadratique. Précisez epsilon, l’emplacement Pre/Post et la présence ou non d’un biais, plutôt que d’indiquer seulement « norm ».
Sur quel axe normaliser ?
Dans un Transformer conventionnel, LayerNorm normalise les caractéristiques de chaque token indépendamment, sans traverser le lot ni les positions. Pour un token , elle calcule , avec et . RMSNorm calcule plutôt dans sa forme usuelle sans biais. Pour , une échelle unitaire, un biais nul et en négligeant epsilon dans cet exemple arithmétique, LayerNorm donne et RMSNorm donne . Ni l’une ni l’autre n’utilise les statistiques de lot accumulées de BatchNorm ; ce calcul reste identique entre entraînement et inférence.
Le FFN applique les mêmes poids séparément à chaque position ; l’attention mélange les positions. Les sorties des têtes sont concaténées, puis une projection apprise les ramène à la largeur , nécessaire à l’addition résiduelle.
Position
Sans information de position ni masque dépendant de l’ordre, l’auto-attention est équivariante aux permutations : permuter les lignes d’entrée permute les lignes de sortie. Un masque causal fixe introduit déjà un ordre ; cette symétrie arbitraire ne s’y applique donc pas.
RoPE est courant dans les décodeurs modernes. Une longue fenêtre configurée ne prouve pas que le modèle retrouve efficacement l’information, et le scaling de position peut dégrader la qualité sur les contextes courts.
Architecture originale et implémentations modernes courantes
La colonne de droite ne décrit pas une norme unique. L’ensemble RMSNorm, RoPE, GQA et SwiGLU de Llama 3 constitue une combinaison documentée ; il ne définit pas tous les Transformers et n’isole pas la contribution de chaque composant.
Exemple de dimensions et de mémoire
Pour batch=2, , et , on obtient :
Q/K/V: [2, 8, 128, 64]
attention scores: [2, 8, 128, 128]
concatenated output: [2, 128, 512]
Pour batch=1, et huit têtes, les scores contiennent :
éléments. En fp16, la seule matrice des scores occupe environ 256 Mio, sans les gradients, les intermédiaires de Softmax, les projections Q/K/V, les FFN et les couches supplémentaires. FlashAttention calcule par blocs pour éviter de stocker toute la matrice intermédiaire et réduire le pic mémoire, mais l’arithmétique exacte de l’attention complète reste quadratique.
Entraînement et génération sont deux systèmes différents
L’entraînement d’un modèle de langage causal calcule en parallèle les positions d’une séquence connue ; la génération dépend token par token des sorties précédentes. Le cache KV évite de recalculer les anciennes clés et valeurs, mais son stockage principal est proportionnel au produit du nombre de couches, de la longueur du contexte, du nombre de têtes K/V, de leur dimension, de la taille du lot et du nombre d’octets par élément.
Un rapport de performances doit distinguer :
- La latence de traitement initial du prompt (prefill) et celle du décodage.
- Le débit pour une taille de lot, des longueurs de prompt et de sortie et des paramètres d’échantillonnage précisés.
- Les stratégies de quantification, de fenêtrage, de pagination ou de déport (offload) du cache KV.
- La mémoire des activations à l’entraînement et la mémoire résidente en inférence.
- L’implémentation des kernels, le compilateur, le matériel et la précision.
« Contexte 1M » ou « utilise FlashAttention » ne suffit pas à établir l’utilité de bout en bout.
La pile produit un vecteur caché à chaque position, pas un identifiant de token. Une projection de vocabulaire donne les logits . Softmax et entropie croisée convertissent ces scores en distribution sur le vocabulaire et en perte d’entraînement pour la cible du token suivant. La génération sélectionne ou échantillonne un token dans cette distribution : l’axe normalisé est celui du vocabulaire, tandis que l’attention normalise sur les clés.
Pour prédire le token suivant, prenons les entrées [BOS, A, B] et les cibles [A, B, EOS]. Chaque position voit sa propre entrée et les précédentes ; fournir les cibles sans décalage révèle la réponse même avec un masque causal. L’encodeur–décodeur de 2017 ajoute une attention croisée entre l’auto-attention masquée du décodeur et le FFN : les états du décodeur fournissent les requêtes, les sorties de l’encodeur les clés et valeurs. Toutes les positions sources valides sont visibles ; le padding source reste masqué.
À la génération, traiter une fois le prompt (prefill), sélectionner le token suivant depuis la dernière sortie, puis faire passer ce token dans la pile (decode). Avec un cache exact et un préfixe causal inchangé, les anciens états ne dépendent pas du token ajouté, donc leurs K/V restent réutilisables. Désactiver le dropout pour comparer de façon déterministe les sorties avec et sans cache. Voir Variantes de l’attention et compression du cache KV pour la taille et les conditions de réutilisation.
Familles d’architecture
- Encodeur seul : Utilise un contexte bidirectionnel, souvent pour apprendre des représentations ou effectuer des tâches discriminatives.
- Décodeur seul : Suit un objectif causal et convient à la génération.
- Encodeur–décodeur : Sépare l’encodage de l’entrée et la génération conditionnelle ; il convient à la transformation de séquences.
- Transformer MoE : Dirige les tokens vers un sous-ensemble d’experts, augmentant la capacité totale mais ajoutant des besoins d’équilibrage de charge, des coûts de communication et des risques d’échec du routage.
Ces étiquettes ne suffisent pas à reproduire un système : le tokenizer, les données, l’objectif, le curriculum de contexte, l’optimiseur, le post-training et le protocole d’outils influencent souvent davantage le comportement final qu’un détail du bloc.
Pour la sélection des experts, l’équilibrage et la distinction entre paramètres totaux et actifs, voir le mélange d’experts.
Modes d’échec et contre-exemples
- Un masque causal inversé révèle les tokens futurs.
- Le padding, le regroupement de séquences (packing) ou l’attention entre documents peuvent contaminer l’entraînement.
- Dans un long contexte, l’information au milieu peut être moins bien utilisée que celle du début ou de la fin.
- Une modification d’architecture ne corrige pas la contamination d’un benchmark ou du corpus.
- Le scaling de RoPE, GQA, la quantification et les kernels fusionnés peuvent interagir et dégrader les performances à certaines longueurs ou avec certains types de données (dtypes).
- Le streaming à mémoire fixe peut favoriser les RNN ou les SSM face à un cache KV qui grandit.
- Pour les tâches visuelles locales, le biais inductif de la convolution peut demander moins de données que l’attention.
Fiche minimale de configuration reproductible
architecture: encoder | decoder | encoder-decoder
layers: N
width: d_model
attention: heads, kv_heads, head_dim, window, kernel
position: method, base, scaling, trained_length
norm: type, pre_or_post, epsilon
ffn: activation_or_gate, intermediate_width, experts
training: objective, data boundary, precision, optimizer, seeds
inference: cache, quantization, batch, prompt/output lengths
Les produits et API du moment relèvent du Radar Frontier ; cette page conserve les limites architecturales réutilisables.
Dans Transformer Explainer, saisir une courte amorce et suivre les tokens à travers l’attention, le MLP et les probabilités du token suivant. Garder le texte fixe et modifier la température pour distinguer les logits du choix d’échantillonnage. La démonstration utilise GPT-2 : comparer ses blocs à décodeur seul au schéma encodeur–décodeur présenté ici.