Variantes de l’attention et compression du cache KV
Lors du décodage autorégressif, chaque nouveau jeton porte attention aux clés et aux valeurs de tous les jetons précédents ; des variantes comme l’attention à fenêtre glissante restreignent cette portée. Conserver ces clés et ces valeurs, c’est le cache KV. Il évite de les recalculer, mais sa mémoire croît linéairement avec la longueur de séquence et avec le nombre de séquences décodées en même temps (taille de lot) : dans l’exemple à 32 couches ci-dessous, une séquence de 4096 jetons demande 512 Mio de cache, et un contexte de 128K (32 fois 4096) en demande 16 Gio.
Avec de longs contextes ou de nombreuses séquences décodées en même temps, les octets lus dans le cache à chaque pas peuvent égaler ou dépasser ceux lus pour les poids ; avec un contexte court et une seule séquence, la lecture des poids domine encore.
Trois voies permettent d’alléger le cache : faire partager un même jeu de clés et de valeurs à plusieurs têtes de requête (moins de têtes KV), stocker pour chaque jeton une représentation plus étroite (une largeur de cache réduite), ou garder moins de jetons et les stocker à plus faible précision (moins de jetons en cache, ou moins précis). Les deux premières se décident à l’entraînement ; la troisième agit sur le cache d’un modèle existant.
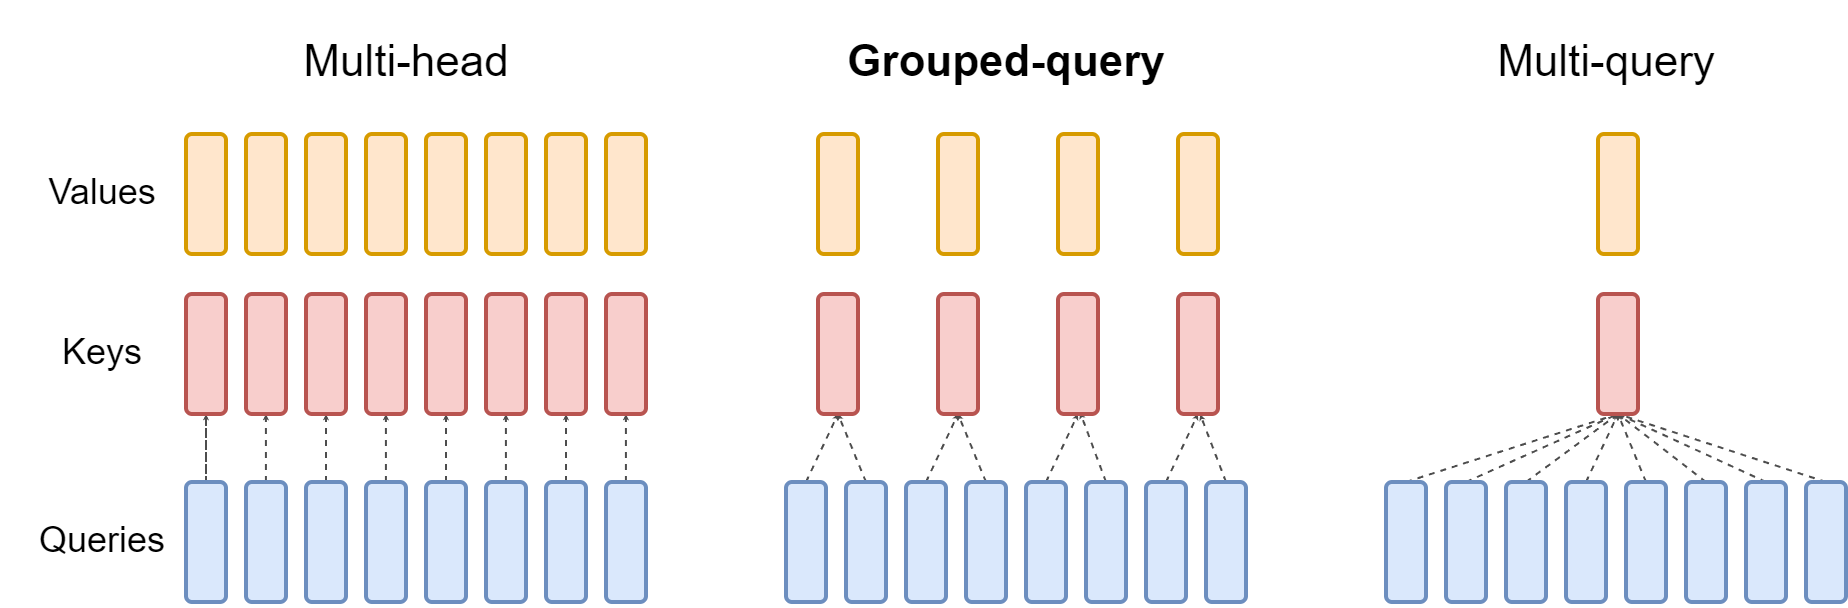 Voir l’image en grand
Partez des requêtes bleues. Au centre, deux requêtes partagent une paire clé-valeur ; à droite, toutes partagent la même. Le nombre de requêtes reste constant. À dimensions égales, le cache diminue parce qu’il contient moins de clés et de valeurs.
MHA et GQA
La taille du cache dépend du nombre de têtes KV pour lesquelles chaque couche stocke des clés et des valeurs. Soit un modèle ayant couches, une longueur de séquence , têtes de requête, têtes KV, une dimension de tête et octets par élément mis en cache. Les trois types d’attention ne diffèrent que par :
- L’attention multi-tête (MHA) utilise normalement : chaque tête de requête a sa propre tête KV.
- L’attention à requête multiple (MQA) utilise une tête KV partagée par toutes les têtes de requête.
- L’attention à requêtes groupées (GQA) se situe entre les deux : plusieurs têtes de requête partagent chaque tête KV.
En ignorant les surcoûts d’allocateur et de métadonnées, le cache KV pour une séquence est approximativement
Autrement dit : pour chaque couche et chaque jeton, chaque tête KV stocke une clé et une valeur de nombres chacune, d’où le facteur deux ; on multiplie ensuite par le nombre de couches, le nombre de jetons et le nombre d’octets par nombre.
Pour un exemple hypothétique avec , , , , et deux octets par élément, le calcul se déroule dans cet ordre :
En MHA, chacune des 32 têtes de requête reçoit sa propre tête KV : passe de 8 à 32 et le cache quadruple, à 2 Gio. Autrement dit, toutes les autres dimensions étant fixes, passer de MHA à GQA réduit le cache proportionnellement à , ici , soit un quart. Le cache croît aussi linéairement avec la concurrence : quatre séquences GQA de même longueur occupent elles aussi 2 Gio avant surcoûts. Ces chiffres ne couvrent que le cache ; les poids occupent leur propre mémoire.
GQA est un choix architectural fait pendant l’entraînement, pas un commutateur sans perte applicable à des poids arbitraires. La recette de l’article GQA regroupe les têtes clé-valeur d’un modèle multi-tête existant, puis poursuit l’entraînement avec environ 5 % du calcul de pré-entraînement d’origine. Le modèle GQA obtenu approche la qualité multi-tête à une vitesse proche de MQA.
Chaque nouveau token ajoute une clé et une valeur par tête K/V dans chaque couche. Choisissez comment les têtes de requête partagent les têtes K/V, puis avancez dans le décodage.
32 têtes de requête → 8 têtes K/V
token 12Décodage du token 12 : ajouter une ligne (128 Kio sur toutes les couches), puis la nouvelle requête lit les 12 lignes : 1,5 Mio pour cette séquence.
une ligne = 2 (K et V) × 32 couches × 8 têtes K/V × 128 × 2 o = 128 Kio
À une longueur de contexte réelle
- Cache KV
- 512 Mio
- 4 096 × 1 × 128 Kio
- Lu à chaque pas de décodage
- 512 Mio
- par séquence, pour chaque nouveau token
- Par rapport à MHA
- 25%
- 8 / 32 têtes K/V
Avec 1 séquence(s) simultanée(s), le cache GQA dépasse ces poids (14,9 Gio) à partir de 122 071 tokens de contexte.
Forme de l’exemple hypothétique de la note : 32 couches, 32 têtes de requête, dimension de tête 128. La ligne des poids de 8 milliards de paramètres est une taille supposée. Les surcoûts d’allocation et les activations ne sont pas comptés.
Quand la réutilisation est-elle exacte ?
Un cache n’est réutilisable tel quel que si les clés et valeurs des anciens tokens restent identiques à l’arrivée d’un nouveau token. Un modèle causal remplit cette condition : ajouter un token ne modifie pas les représentations antérieures, et chaque couche ne calcule que les nouvelles positions. Deux requêtes qui commencent de la même façon peuvent donc partager ce morceau de cache : c’est l’origine du cache de préfixe des runtimes. Si le préfixe tokenisé, les poids (adaptateurs compris) ou les indices de position diffèrent en un point, ou si un token ancien est modifié, tous les états mis en cache à partir de là deviennent invalides.
La spéculation en arbre étend ce problème aux branches candidates : les isoler et conserver les états KV et comprimés correspondant au chemin accepté.
Attention latente multi-tête
GQA économise le cache en stockant moins de têtes. DeepSeek-V2 a introduit l’attention latente multi-tête (MLA), qui prend un autre chemin : au lieu de mettre en cache les tenseurs complets de clés et de valeurs par tête, le modèle apprend une représentation latente de dimension plus faible, ne garde en cache que ce court vecteur pour chaque jeton et le reprojette en clés et valeurs par tête au moment voulu. Des parties du chemin des clés utilisées pour l’information de position rotative (RoPE) restent distinctes, sous la forme d’un petit morceau à part, car la rotation dépendante de la position ne peut pas simplement être incorporée dans une projection fixe.
Une comparaison simplifiée de la largeur du cache est :
où est la largeur latente compressée et la largeur découplée des clés rotatives. Dit autrement, la largeur MHA/GQA croît avec le nombre de têtes KV, tandis que MLA stocke un vecteur latent et une clé de position, quel que soit le nombre de têtes.
Avec la configuration donnée dans l’article DeepSeek-V2 : 60 couches, 128 têtes d’attention de 128 dimensions chacune, largeur latente et largeur de clé rotative . Le tableau suppose deux octets par nombre :
MLA stocke par jeton environ cinquante-sept fois moins de nombres qu’une MHA de même forme (). Ses 576 nombres sont même inférieurs aux 2 048 par couche de l’exemple GQA à 8 têtes KV ; l’article le formule ainsi : un cache équivalent à une GQA de seulement 2,25 groupes ().
Comme GQA, MLA se décide à l’entraînement : les projections de compression et de reconstruction sont apprises, et les résultats publiés concernent des modèles entraînés avec cette architecture.
À l’exécution, on règle la longueur, la précision et le cache de préfixe
La structure de l’attention est fixée à l’entraînement ; qui exécute le modèle ne peut pas la changer. On peut en revanche changer les deux autres nombres de la formule : combien de tokens le cache garde () et combien d’octets occupe chaque valeur (), ainsi que le recalcul ou non d’un début identique.
Avec l’exemple GQA ci-dessus : 128 Kio par token donnent 4 Gio à 32K de contexte ; q8_0 ramène cela à environ 2 Gio et q4_0 à environ 1 Gio. La répartition du budget d’une machine entre poids et cache se trouve dans le déploiement sur un appareil.
Compresser un cache existant
Une autre famille de méthodes de recherche laisse l’architecture entraînée intacte et supprime des tokens du cache. SnapKV note les positions antérieures avec l’attention d’une fenêtre d’observation placée en fin de prompt et ne garde que les clés et valeurs les mieux notées. PyramidKV donne aux couches des budgets de cache différents selon la répartition de leur attention. La mémoire économisée vient du stockage de moins de tokens, au risque de supprimer un passage bref mais décisif.
Ce qu’il faut mesurer
Pour un déploiement concret, consignez :
- le modèle exact, l’architecture d’attention et le dtype du cache ;
- la longueur du prompt, la longueur générée et le nombre de séquences simultanées ;
- la mémoire GPU et hôte de pointe ;
- le temps de préremplissage, le temps jusqu’au premier jeton et le débit de décodage ;
- la réussite de la tâche sur des cas à long contexte exigeant des informations situées à différentes positions ;
- le comportement après éviction du cache, quantification ou déport vers le CPU.
L’adéquation mémoire et la qualité des réponses préservée nécessitent des tests distincts : un modèle qui annonce une longue fenêtre de contexte peut ne pas tenir sur le matériel disponible, tandis qu’une méthode économisant le cache qui tient en mémoire peut encore échouer à la tâche.