Modèles multimodaux : alignement, fusion et questions visuelles
Un modèle multimodal combine texte, image, audio ou vidéo, mais « accepte des images » ne définit pas une tâche. Retrouver une photo à partir d’une phrase exige une similarité image–texte. Répondre sur une capture d’écran demande de relier les indices visuels à la génération. Produire une image correspond encore à un autre objectif ; voir les modèles de diffusion. Partir des entrées, des sorties et des détails à préserver.
Transformer une image en séquence
Un Vision Transformer (ViT) élémentaire découpe l’image en patches, aplatit leurs pixels et projette chaque patch vers un vecteur. L’image n’a pas besoin de devenir d’abord une description textuelle.
Dans un exemple simplifié, une image 224×224 et des patches 16×16 donnent patches. Chaque patch RGB comporte valeurs avant projection vers une largeur . Sans token de classification, les états ont la forme [batch,196,d_v]. Le nombre 768 vient des pixels, pas d’une obligation sur la largeur cachée.
L’information de position préserve l’ordre spatial. Le prétraitement définit redimensionnement, recadrage et normalisation. Les systèmes réels peuvent employer des tuiles haute résolution, une résolution dynamique ou une compression : 196 tokens par image n’est donc pas une règle universelle de mémoire ou de facturation. Les patches sont généralement des vecteurs continus, sans correspondance obligatoire avec les identifiants du vocabulaire textuel.
Les fournisseurs facturent les tokens visuels au pixel et à la seconde
Au 2026-10-29, Anthropic et Google publient tous deux leur calcul. Claude découpe une image en blocs de 28×28 pixels et compte chaque bloc comme un token visuel : une image coûte donc tokens (documentation vision d’Anthropic). Chaque modèle a aussi un plafond de résolution : Claude 4.7 et les modèles suivants acceptent 2 576 px sur le grand côté et jusqu’à 4 784 tokens visuels ; les autres modèles, 1 568 px et 1 568 tokens. Une image qui dépasse l’une des limites est d’abord réduite, en gardant ses proportions.
Une image de 1000×1000 coûte 1 296 tokens dans les deux niveaux. Une capture de 1920×1080 n’est pas réduite au niveau haute résolution et coûte 2 691 tokens ; au niveau standard, elle est d’abord ramenée à 1456×819 et coûte 1 560 tokens. La documentation indique aussi qu’une image haute résolution peut utiliser jusqu’à environ trois fois plus de tokens visuels que la même image sur un modèle de niveau standard.
Le guide des tokens de Gemini indique qu’une image d’au plus 384 pixels dans les deux dimensions compte 258 tokens, et qu’une image plus grande est découpée en tuiles de 768×768 de 258 tokens chacune. L’audio coûte 32 tokens par seconde, soit 1 920 par minute. Pour la vidéo, la même page donne deux chiffres : la liste des points clés indique 263 tokens par seconde (traitement statique), tandis que le tableau des modes de traitement indique, pour le traitement statique, environ 100 tokens par seconde par défaut (basse résolution) ou environ 300 (haute résolution), avec un échantillonnage à 1 image par seconde. Pour budgéter une vidéo, lancer countTokens sur le fichier réel.
Il faut donc recadrer une capture avant de l’envoyer. Si l’on n’a besoin que d’une boîte d’erreur de 600×400 dans une capture de 1920×1080, le recadrage coûte tokens selon la formule de Claude, environ un huitième de la capture entière au niveau haute résolution. Le recadrage reste aussi sous les deux plafonds : il n’est pas réduit, et le petit texte de la boîte garde sa netteté d’origine.
L’alignement rend les modalités comparables
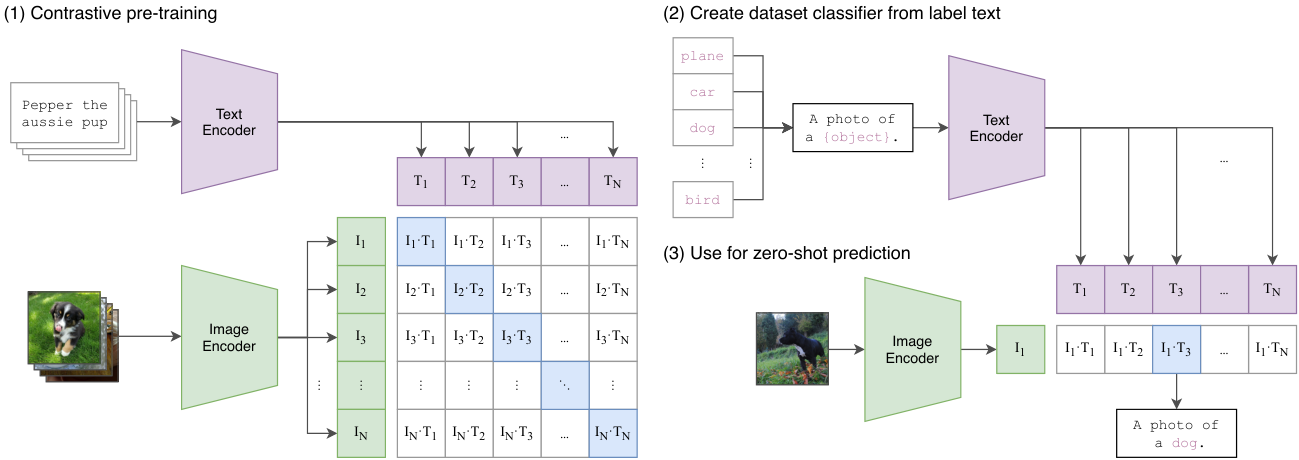
CLIP produit des vecteurs avec deux encodeurs distincts et apprend par contraste à rapprocher les paires image–texte correctes. Il n’a pas besoin de générer une légende. Cette structure convient à la recherche et à la comparaison avec des descriptions candidates.
Imaginons trois images et leurs trois descriptions. Les vecteurs normalisés ont chacun la forme [3,d]. Leur produit matriciel donne une table [3,3], dont la diagonale contient les bonnes paires. L’entraînement favorise la bonne case dans chaque ligne et colonne. Une description considérée négative mais réellement pertinente apporte une supervision bruitée.
En inférence, comparer une image à « voiture rouge », « voiture bleue » et « vélo » donne des scores. Leur softmax dépend de cet ensemble : retirer un candidat ou ajouter une description proche modifie la distribution. Ce n’est pas une probabilité universelle qu’une voiture rouge soit présente. Il faut évaluer les seuils sur la distribution réelle de la tâche.
 Voir l’image en grand
À gauche, l’entraînement produit des vecteurs d’images et de textes ; les cases diagonales surlignées correspondent aux paires dont la similarité doit augmenter. À droite, l’inférence transforme les noms de classes en descriptions, les encode et les compare à une image. La description du chien est sélectionnée parmi les candidats, et non générée librement.
La fusion relie les indices à la génération
Répondre « Quelle est la deuxième ligne d’erreur ? » demande généralement plus qu’une similarité globale. La conception initiale de LLaVA relie un encodeur visuel préentraîné à un modèle de langage, utilise une projection entraînable pour adapter les caractéristiques visuelles à sa largeur et apprend à répondre avec des instructions visuelles.
Un connecteur simplifié multiplie [batch,N,d_v] par [d_v,d_l] pour atteindre la largeur du modèle de langage ; des formes compatibles rendent seulement le calcul possible, et le modèle de langage doit être entraîné à exploiter ces vecteurs. D’autres modèles se connectent par rééchantillonnage ou attention croisée.
La génération de la réponse dépend encore du décodage et de l’arrêt.
Les informations peuvent disparaître avant la réponse
Réduire une image peut effacer les petits caractères, et les fournisseurs réduisent d’office les images qui dépassent leurs plafonds ; la recadrer peut retirer ses bords ; comprimer les positions peut supprimer des relations fines. Une réponse plus longue ou plus fluide ne restitue pas les indices absents de l’entrée traitée.
Reconnaître une scène générale diffère du comptage fiable, de l’extraction de coordonnées ou des relations gauche–droite. Les régularités du langage peuvent conduire le modèle à ajouter un objet fréquent dans cette scène. Lire plusieurs cellules correctement ne prouve pas que lignes et colonnes d’un tableau ont été correctement associées.
La vidéo ajoute un problème d’échantillonnage temporel : une image toutes les quelques secondes peut manquer un événement bref ou faire confondre une succession temporelle avec une cooccurrence statique. Une transcription audio peut perdre intonation, chevauchements et sons non verbaux. Les tâches concernées doivent évaluer la chaîne utilisant la modalité originale, pas seulement les réponses à une transcription.
Tester la dépendance aux indices
Construire un petit ensemble public et contrôlé où une image simple ne change que par couleur, nombre, position ou texte. Garder la question identique et vérifier que la réponse suit la variation. Masquer ensuite la région décisive pour observer si le modèle donne toujours la même réponse avec autant d’assurance. Il s’agit d’un protocole proposé, pas d’un résultat mesuré.
Localiser les erreurs : prétraitement, représentation, connexion au langage ou décodage. Pour l’OCR, mesurer erreurs de caractères et relations de mise en page ; pour le comptage, erreur absolue ; pour les questions, justesse et comportement sans preuve. Comparer à résolution, recadrage, questions et budget de sortie identiques, en relevant séparément latence et tokens visuels.
Pour la recherche image–texte, relier les modèles d’alignement à la chaîne de recherche. Pour les captures, tester détails lisibles et dépendance aux indices. Pour un agent multimodal, séparer vérification de l’action et jugement visuel : décrire un bouton ne prouve ni sa localisation fiable ni la confirmation de l’état après clic.