Mélange d’experts : calcul parcimonieux, routage et coût de déploiement
Un mélange d’experts, ou MoE, stocke plusieurs groupes de paramètres mais n’en active qu’une partie pour chaque entrée. Dans les Transformers parcimonieux courants, il remplace certaines couches FFN : un routeur choisit quelques experts par token, puis combine leurs sorties. La capacité totale peut ainsi croître sans augmenter proportionnellement le calcul FFN par token.
La taille d’un modèle MoE se lit donc en deux nombres : la mémoire suit les paramètres totaux, la vitesse et le coût par token suivent les paramètres actifs. Dans Mixtral 8x7B, chaque token a accès à 47B paramètres mais n’en active que 13B. L’article indique que le coût mémoire du service est proportionnel aux 47B paramètres parcimonieux, et que n’utiliser qu’une partie des paramètres par token accélère l’inférence à faible taille de lot. La génération locale pour un seul utilisateur est justement ce cas : chaque étape relit en mémoire les poids qu’elle utilise, et un MoE ne lit que les experts choisis ; il va donc plus vite qu’un modèle dense de même taille totale. Pour les modèles MoE exécutables en local aujourd’hui, avec leurs paramètres totaux et actifs, voir les modèles de code locaux.
Les experts sont des sous-réseaux entraînés avec un objectif commun au sein d’un modèle, pas des agents conversationnels réunis en discussion. Leur nom ne garantit pas des spécialités distinctes en mathématiques, droit ou code.
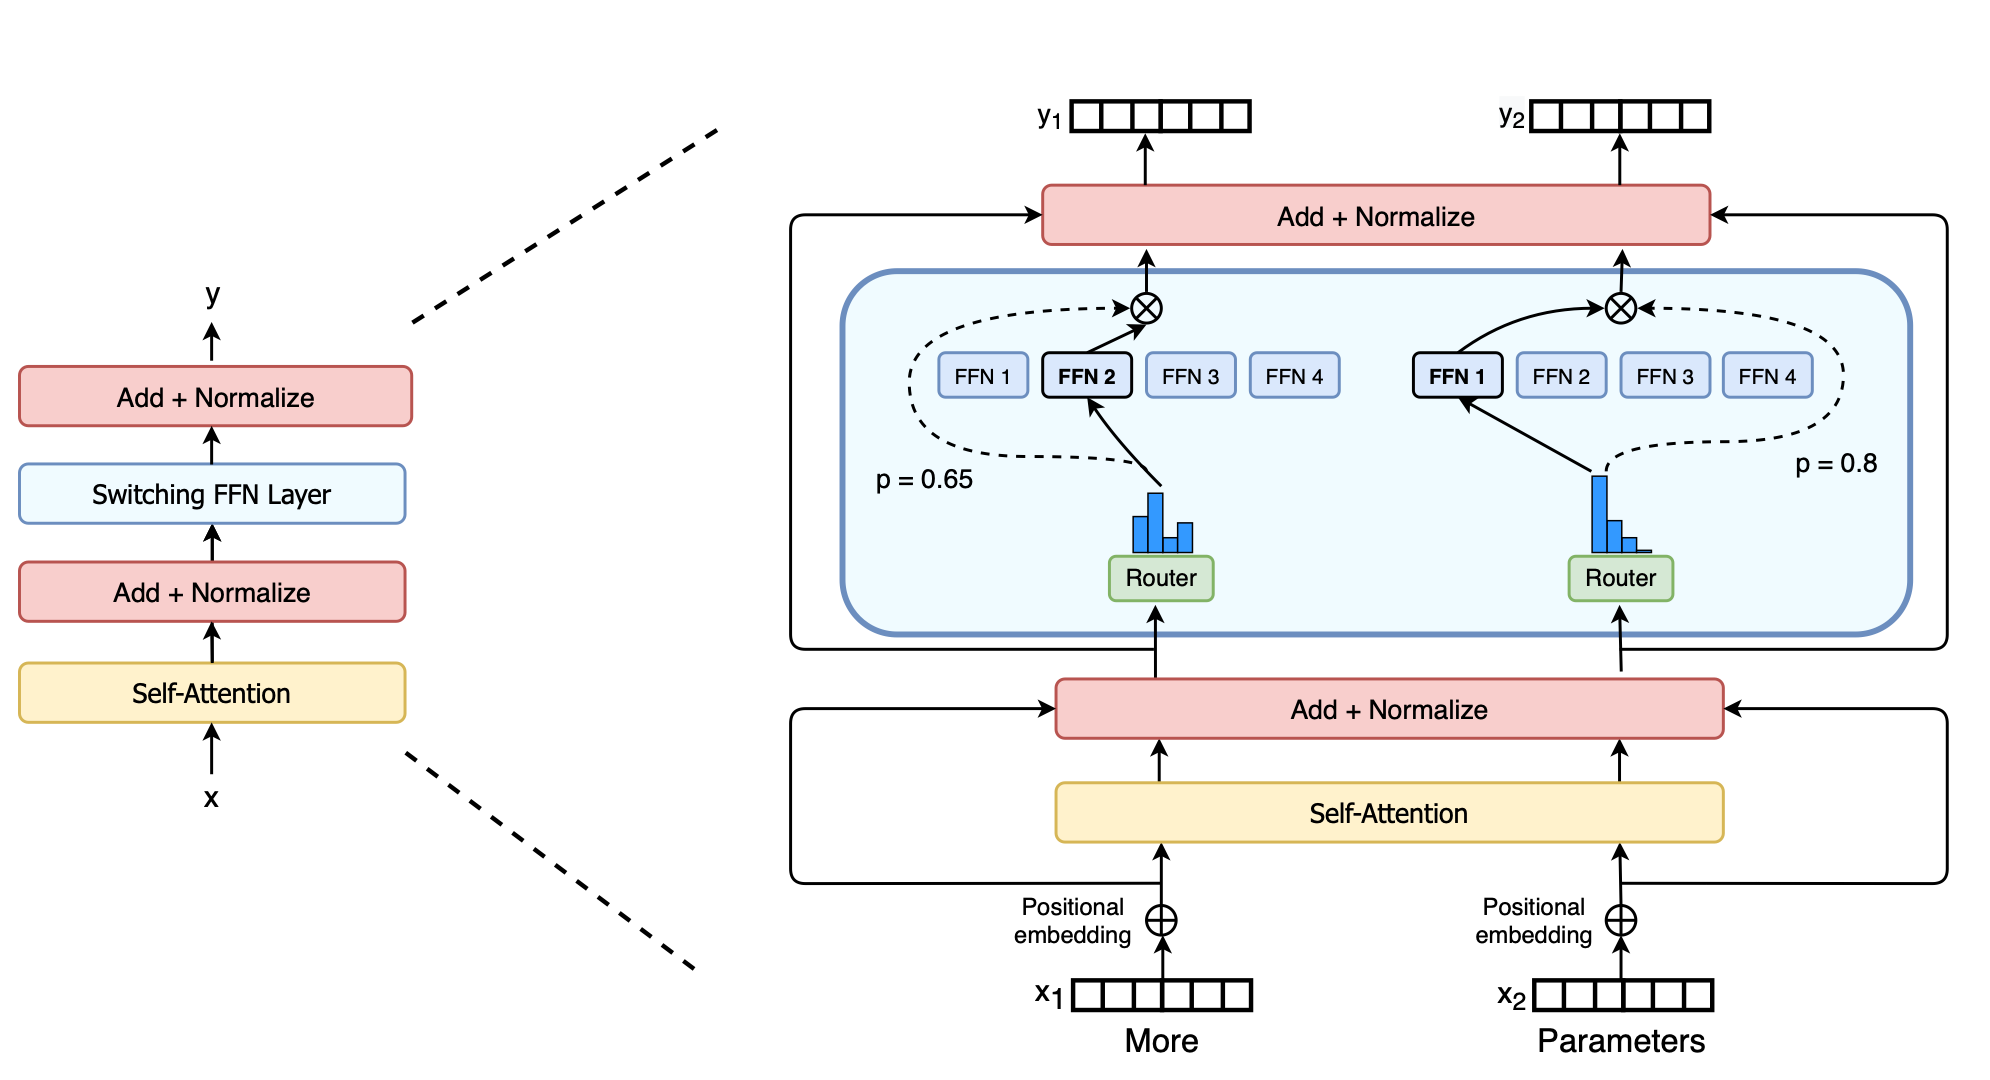 Voir l’image en grand
Le bloc bleu suit deux tokens : chaque routeur choisit un FFN, puis pondère sa sortie. Il s’agit du routage top-1 de Switch. La formulation top-k ci-dessous peut activer plusieurs experts pour un même token.
Suivre un token
L’article fondateur sur le MoE à portes parcimonieuses utilise un mécanisme appris pour sélectionner certains experts. Une formulation simplifiée de top-k choisi par token est :
L’état a une largeur ; la matrice de routage a la forme [d,E] pour E experts. désigne un sous-réseau et son poids. Scores, normalisation, experts partagés et biais varient selon l’implémentation. La formule montre sélection, calcul et combinaison.
Avec quatre experts et top-2, supposons [0.50,0.30,0.15,0.05]. En renormalisant les experts retenus, les deux poids deviennent 0,625 et 0,375. Si leurs sorties sont [2,0] et [0,4], le mélange vaut [1.25,1.50]. Ces valeurs sont pédagogiques, pas des mesures d’un modèle réel.
Les tokens peuvent choisir des experts différents ; un même token peut changer de route entre couches. Attention, normalisation et résidus partagés restent généralement présents. Le routeur choisit un calcul interne, pas une réponse lisible.
Paramètres stockés et paramètres actifs
Switch Transformer présente un expert par token ; Mixtral en sélectionne deux sur huit par couche. Ces proportions sont des choix d’architecture, pas la définition du MoE.
Considérons seulement les FFN d’une couche : huit experts de 10M paramètres et top-2 donnent 80M paramètres stockés, mais deux groupes, environ 20M, utilisés par un token. Les paramètres partagés s’ajoutent séparément. Dans un lot, les routes peuvent collectivement utiliser les huit experts.
Les paramètres actifs ne réduisent pas le total des poids. Les experts inactifs doivent quand même être stockés, car le token suivant peut choisir n’importe lequel. Les garder tous sur GPU mobilise la mémoire de tous les poids. Quand ils ne tiennent pas, le serveur llama.cpp peut garder tous les poids d’experts MoE en mémoire CPU avec --cpu-moe, ou seulement ceux des N premières couches avec --n-cpu-moe N. La mémoire GPU est libérée, au prix d’une lecture de ces experts dans la mémoire système, plus lente : chaque token prend plus de temps. Le cache KV dépend surtout de l’attention, de la longueur et du lot. Le nombre d’experts ne multiplie ni ne divise directement sa formule.
Gérer la charge du routage
Si presque tous les tokens choisissent un expert, les autres restent inactifs et le premier devient un goulot d’étranglement. L’apprentissage peut renforcer cette préférence. L’équilibrage évite une concentration excessive du calcul et des occasions d’apprentissage ; il n’exige pas des tâches identiques partout.
Switch fixe une capacité par expert ; une fois un expert populaire plein, les tokens excédentaires passent par le résidu sans calcul d’expert à cette couche ; voir la discussion sur capacité et équilibrage. D’autres implémentations utilisent une autre planification et ne suppriment pas de tokens.
Une perte auxiliaire favorise une distribution plus équilibrée ; trop pondérée, elle peut perturber l’objectif de tâche. Stabilité, précision numérique et changement de distribution comptent aussi. Un trafic équilibré à l’entraînement ne garantit pas l’équilibre avec de longs documents ou une langue particulière en production.
La communication peut absorber le gain arithmétique
Quand un fournisseur répartit les experts sur plusieurs GPU, chaque token est envoyé aux experts choisis, puis les sorties reviennent pour être combinées ; cet échange all-to-all coûte un temps qui dépend des interconnexions, du lot et de la planification, et absorbe une partie du gain arithmétique. Une machine locale unique n’a pas cette étape : ce qui compte, c’est l’endroit où résident les poids totaux ; voir plus haut, la quantification et les performances d’inférence.
Lire les résultats de performance
- Relever d’abord les paramètres totaux et actifs par token : les premiers fixent la mémoire nécessaire, les seconds ce que chaque étape calcule et lit.
- Comparer latence du premier token, vitesse de génération suivante et débit sur le même matériel, la même précision, les mêmes longueurs d’entrée et de sortie et la même concurrence ; comparer la qualité sur le même jeu de test.
- Le nom d’un expert ne dit rien de son rôle. Recevoir souvent des tokens de code montre une préférence de routage ; parler d’« expert du code » demande des interventions contrôlées ou des ablations.