迁移学习、LoRA 与蒸馏
预训练模型已经学会把文字变成有用的向量,所以训一个新分类器只需要少量带标签的样本,不必从头攒够让模型学会读文字的海量数据。前提是这些向量里还留着新任务要的区别。所以选方法之前,先判断要改的是哪一层:输出分类头、内部表示,还是最终部署的模型本身。
多数问题用不着改权重
微调改变的是模型面对同一类输入时的习惯,它不擅长塞进会变的事实。所以先按成本从低到高试:把指令写清楚,在提示里放几个示例(few-shot);模型缺的是你的文档或今天的信息,就交给检索。这两步在一份固定的评测集上停在门槛以下,而且失败总是同一种行为(格式不稳、标签判错、语气不对),不是缺知识,才轮到微调。
微调划算的情形有三种。第一种是同一个窄任务要调用成千上万次,提示里的长说明和示例每次都要付费,还时好时坏。第二种是想让一个小模型做大模型靠长提示才做得好的事,这就是后面讲的蒸馏。第三种是必须离线或在本机运行。预训练、监督微调与偏好优化一页按问题类型讲该选哪个训练阶段。
先试冻结表示
设想你每天收到很多网页剪藏,要一个小模型决定每篇是留着、做摘要,还是丢掉。这个模型就是一个文档路由器,在 keep、summarize、discard 三个标签里选一个。最省事的做法是冻结文本编码器,让它把每篇剪藏变成一个向量 ,只训练最后的输出层:
若 、类别数为 3,分类头只有 个参数。编码器的参数和缓冲区(buffer)都固定、预处理确定,并且编码器处于评估模式(关闭 dropout)时,可以缓存向量,训练分类头不必反复运行编码器。这个基线直接回答一个问题:现有的向量是否已经把三类剪藏分开了。
有两种失败是多训几轮也救不回来的。如果决定去留的那句话在输入截断时就被删掉了,分类头无法凭空找回。如果编码器把“这篇和我已存的某篇几乎一样”和“这篇是新的”编成差不多的向量,分类头再怎么调也分不开。所以先检查这两种失败,再决定要不要增加训练轮数。《动手学深度学习》的微调章节解释了复用特征与更新预训练参数的区别。
全量微调还会训练主干模型,自由度更大,也需要更多梯度、优化器内存,并可能覆盖已有能力。可训练参数多,不等于结果好;要在同一份数据划分上比较“冻结编码器、只训练分类头”、部分解冻和完整适配,看哪个在测试集上真的更好。
LoRA 限制怎样更新参数
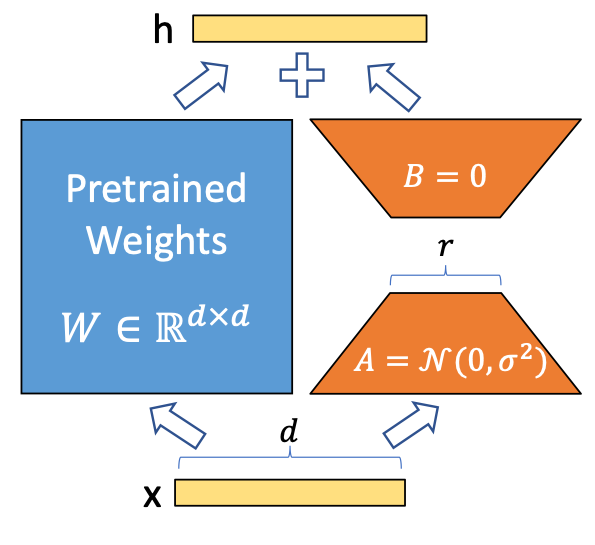
对线性层 ,LoRA冻结原权重,学习一个低秩增量:
 查看清晰大图
输入 x 同时经过两条分支:蓝色权重保持冻结,橙色分支先经过秩为 r 的瓶颈,再回到输出维度。训练只更新 A 和 B;图中 B 的零初始化让新增分支在起点不改变原层输出。
是选定的秩, 是缩放系数。可训练矩阵元素从 变为 。一个 的层,秩取 8 时,需要训练 65,536 个元素,原矩阵则有 16,777,216 个,相差 256 倍。但总训练内存不会因此直接缩小 256 倍:底模权重、激活、适配哪些层以及其他可训练头仍然占内存。
秩的限制在最小的例子里就看得出:秩为 1 的 增量 只沿一个方向读输入、沿一个方向写输出,所以它表达不了任意的 修改。多层适配和非线性让完整网络复杂得多,但秩仍是实际约束。
LoRA 改变权重的更新方式,不会把原架构变小。底模与数值表示、运行时兼容时,可以把适配增量合并到权重后推理;保留独立适配器则便于切换任务。适配器必须匹配底模检查点和 tokenizer,不能只因模型名字相近就混用。
蒸馏改变由谁学习
知识蒸馏让学生模型学习教师提供的信息。分类教师可以输出完整分布,而不是只给获胜标签。用温度 平滑 logits(温度怎样改变 softmax,见 Softmax 回归):
构造 logits , 时概率约为 , 时约为 。较软的目标暴露了教师怎样排列次优选择。常见训练目标把硬标签损失与师生分布差异结合;温度、混合系数和取均值方式都会影响梯度尺度,应一起记录。
生成式教师也能产生示范或候选解释,但要针对任务筛选、检查。与教师一致,只能说明模仿得好;教师系统性标错,学生也会继承错误。最终应以独立标签或真实任务结果评价学生。
这些方法回答不同的问题
这几种方法可以组合:教师提供样本,学生用 LoRA 学习。学生的大小由选的架构决定,跟用不用 LoRA 无关;教师标错的样本,学生照样学进去。量化是另一个维度:量化改变数值表示,蒸馏改变学出来的模型,LoRA 限制更新方式。
托管微调基本关门了,个人得自己跑训练
2026 年下半年,两家大厂的托管微调都已对个人关上。OpenAI 在 2026-05-07 的弃用公告里分三步收口:当天起,从没跑过微调的组织不能再建训练任务;2026-07-02 起,过去 60 天没调用过微调模型的组织也不能再建;2027-01-06 起,仍在用的老客户也不能再建新任务。已经训好的模型可以一直调用,到其底模弃用为止。它的模型优化指南也写着微调平台“不再向新用户开放”。Google 的 Gemini API 微调页(2026-04-28 更新)说,Gemini API 和 AI Studio 里已经没有可微调的模型。最后一个可微调的 Gemini 1.5 Flash-001 在 2025 年 5 月弃用,Google 也没有近期恢复的计划。
所以对个人开发者,微调现在就是:下载开放权重,在自己的机器或租来的 GPU 上训练适配器。常用的工具有三个:
- Mac(Apple 芯片):MLX-LM 用
mlx_lm.lora --train训练,支持lora、dora和full三种方式;--model指向量化模型时,训练自动变成 QLoRA。数据目录里放train.jsonl(可选valid.jsonl),格式可以是chat、tools、completions或text。内存不够时,先调小--batch-size、减少--num-layers,或加上--grad-checkpoint。 - NVIDIA 等 GPU:TRL 的 SFTTrainer 收到对话格式的数据时会自动套用模型的聊天模板;传入
peft_config就只训 LoRA,再加上 4 位的quantization_config就是 QLoRA。底层的适配器由 PEFT 管理。 - Unsloth:支持 LoRA、QLoRA、全量微调、DPO 和 GRPO,覆盖 NVIDIA、AMD、Intel 和 macOS。文档首页说它“快 2 倍、显存少 70%、不损失精度”,这是厂商自己的说法,那一页没写和什么比。
QLoRA 把冻结的底模压成 4 位,梯度穿过这个 4 位模型,只更新 LoRA 适配器。论文用这种办法在一张 48GB 显卡上微调了 65B 参数的模型。4 位只压缩冻结权重,激活值的内存仍随批量和序列长度增长,训练过程一页列出了这笔内存账。
一次 QLoRA 适配走六步
拿剪藏路由器来说,整个流程是这样的:
- 选一个许可证允许你用的开放底模。 先读许可证:能不能商用,能不能发布改过的权重。还要保留对话和工具调用能力时,从 instruct 版出发,不要从 base 版出发。
- 把训练数据写成这个底模的聊天模板。 每条样本是一组
messages,由训练工具套模板。Hugging Face 的聊天模板文档说,控制 token 用错,模型表现会大幅变差。损失只算在助手的回答上,道理见损失掩码。 - 用 QLoRA 训练。 Mac 上用 MLX-LM 加载量化模型,NVIDIA 上用 TRL 或 Unsloth。正式开跑前,先让模型在几十条样本上过拟合一遍,确认数据和损失没接错。
- 训练前后在同一份固定评测集上比较。 评测集要在生成任何改写、扩充数据之前就定下来,否则同一句话的变体会同时落进训练集和测试集,见数据划分与泄漏。比较的做法和要记录的运行配置,见在自己的任务上评测模型。
- 在实际用的运行时里加载适配器。 MLX-LM 用
--adapter-path加载,或用mlx_lm.fuse把适配器合并进权重;llama.cpp 服务端用--lora加载 GGUF 格式的适配器;Python 里用 PEFT 的PeftModel.from_pretrained。 - 重新检查工具调用和输出格式。 训练数据里没有工具调用时,模型可能把原来会的 JSON 和工具格式忘掉。所以要重跑评测里的精确 JSON 和工具调用冒烟测试;需要保住工具能力,就在训练数据里放进带工具调用的对话(MLX-LM 的
tools格式和 TRL 都支持)。
怎样设计一次有效适配
划分数据和固定测试集的规则见数据划分与泄漏。用有标签的验证集选择秩、学习率、停止时机和类别阈值。
对文档路由器,除了每类召回率,还要测误删有用文档的代价、目标输入长度下的延迟,以及不确定样本的转交比例。与简单规则、“冻结编码器、只训练分类头”的基线比较,并放入否定、近似重复、新主题和类别比例变化的样本。这些情况才真正考验路由器要学的区别。
Agent traces 可以提供训练材料,前提是记录里的标签值得重复。历史上做过的动作不自动等于正确动作。先纠正反复出现的错误,再把记录变成监督数据;训练后还应在留出数据上校准决策概率。
PEFT quicktour 把 LoRA 变成一个小练习:建立适配器配置,用 print_healthcheck() 查看可训练参数比例和适配器状态,再保存、重新加载适配器。保存下来的只有 adapter_config.json 和 adapter_model.safetensors 两个文件,加载时仍要那个底模;对照这两样,就能看清适配器 checkpoint 究竟包含什么。