Mécanisme d'attention
Supposons que deux informations soient représentées par les vecteurs suivants :
Prendre la moitié de chacune puis les additionner donne
Quelle proportion prendre de chacune ? L’attention calcule ces poids à partir du contenu, au lieu de les fixer à une moitié.
Cette page explique le mélange pondéré Q/K/V, les masques et la normalisation. Pour l’origine des vecteurs, voir la tokenisation et les représentations ; pour assembler le réseau, poursuivre avec Transformer. Les modèles multimodaux expliquent la connexion entre patches visuels et texte.
Quel poids attribuer à chaque vecteur ?
Les vecteurs à mélanger sont appelés valeurs (values). Pour choisir leurs poids, introduisons une requête (query), le vecteur utilisé pour rechercher l’information.
Chaque valeur possède une clé (key), que l’on compare à la requête pour calculer un score de correspondance. Prenons ici
Calculons d’abord les poids avec la requête et les clés seulement. Les produits scalaires valent et . Chaque clé a deux composantes. La division par , racine carrée de cette dimension, donne les scores .
Softmax transforme ces scores en poids positifs ou nuls dont la somme vaut un : il prend leurs exponentielles et divise par leur somme.
Mélangeons ensuite les valeurs : chaque poids multiplie la valeur de la même position. Avec les poids arrondis, la sortie est
La première clé correspond mieux, mais la sortie contient toujours la seconde valeur. La température, les écarts de score, les clés en double et les masques modifient le mélange. « Porter attention à une position » n’est généralement pas un fait binaire.
Modifiez une composante de ci-dessous ; les clés et les valeurs restent fixes. Pour , les deux scores sont nuls, les poids valent et la sortie . Pour , les poids s’inversent et la sortie vaut environ . Les scores déterminent les proportions ; les valeurs déterminent ce qui est mélangé.
k1 = [1, 0]Score 0.707
Poids 67.0%
k2 = [0, 1]Score 0.000
Poids 33.0%
Pour un nombre quelconque de paires clé/valeur, ce calcul s’écrit
La requête, la clé et la valeur sont des rôles calculatoires, et non des significations intrinsèques. Ces vecteurs proviennent généralement de différentes projections apprises des entrées ; les valeurs ne sont pas nécessairement égales aux clés. Ce calcul des poids à partir du contenu, suivi du mélange des valeurs, est une opération différentiable appelée adressage par le contenu.
Scores
L'attention additive utilise un petit réseau appris :
L'attention par produit scalaire mis à l'échelle (scaled dot-product attention) utilise
Si les coordonnées de la requête et de la clé sont mutuellement indépendantes, de moyenne nulle et de variance unitaire, le produit scalaire non redimensionné a une variance et un écart-type , ce qui peut saturer le softmax. La mise à l'échelle est un choix de conception adapté à ce score, et non une loi générale pour toute attention.
Forme matricielle et masques
Pour , et :
a pour dimensions et a pour dimensions . Les masques s’appliquent avant Softmax :
- Les masques de padding excluent les clés de remplissage.
- Les masques causaux excluent les positions futures.
- Les masques structurels limitent les connexions locales, de graphe ou par blocs.
Avec un masque additif , une ligne entièrement masquée contient uniquement des logits : le softmax ordinaire n’y définit aucune distribution de probabilités. Consultez le comportement de l’API choisie et traitez explicitement ces lignes ; aucune valeur de retour n’est universelle. Modifier un token masqué ne doit pas changer une sortie non masquée si les représentations Q/K/V autorisées restent fixes.
Normaliser sur les clés, pas sur les requêtes
Le softmax de agit séparément sur chaque ligne, donc sur l’axe des clés. Pour un masque additif, autorise une paire et l’interdit. Dans une séquence causale de trois positions, la première ligne voit la première clé, la deuxième les deux premières et la troisième les trois. Si tous les scores autorisés sont nuls, les lignes valent , et . La diagonale est autorisée quand l’entrée à cette position prédit le token suivant. C’est la convention du Transformer original.
Un masque de padding sur les clés ne supprime pas automatiquement les sorties des requêtes de padding : les exclure de la perte ou de l’agrégation ultérieure. Les conventions booléennes varient selon les API ; vérifier si True signifie autorisé ou interdit. Le test d’invariance au token masqué suppose que Q/K/V aux positions autorisées restent fixes : aucun calcul en amont ne doit déjà y avoir mélangé le contenu masqué.
Auto-attention, attention croisée et multi-têtes
- Auto-attention (self-attention) : Q/K/V proviennent du même ensemble de représentations, généralement par des projections apprises distinctes.
- Attention croisée (cross-attention) : Les requêtes viennent d’un côté, les clés et valeurs de l’autre.
- Attention multi-têtes : Plusieurs sous-espaces projetés calculent l’attention en parallèle ; leurs sorties sont ensuite concaténées et projetées.
Les têtes fournissent plusieurs canaux de calcul, sans garantir que chacun corresponde à un concept humain stable comme la syntaxe ou la coréférence. Elles peuvent être redondantes ou changer après reparamétrisation tout en conservant des sorties proches.
L’attention de style Bahdanau a d’abord permis à chaque étape du décodeur RNN de construire un contexte différent à partir de plusieurs états de l’encodeur ; Luong a comparé les formes globales et locales. Le Transformer a ensuite fait de l’auto-attention l’une des principales opérations au sein d’une couche. L’attention n’a pas commencé avec le Transformer.
Différentes conceptions d'efficacité pour différents problèmes
L’auto-attention dense forme scores ; à dimensions de tête fixes, le temps et la mémoire intermédiaire de l’implémentation naïve croissent quadratiquement avec la longueur. Les variantes ci-dessous ciblent des coûts différents.
MQA/GQA réduisent surtout le stockage et le trafic mémoire du cache KV autorégressif, sans réduire le nombre de têtes de requête. Ces variantes changent le partage, pas la fonction de score ; leurs noms seuls ne garantissent ni qualité, ni adéquation à l’entraînement, ni compatibilité. Rapportez le nombre de têtes de requête, de têtes K/V, la dimension par tête, la fenêtre, le type de données (dtype) et le kernel plutôt que de dire simplement « attention efficace ». Les RNNs/SSMs peuvent convenir au streaming à état fixe ; la convolution peut économiser données et calcul lorsque la localité est forte. L’attention n’est pas la réponse par défaut à toutes les relations.
Frontière d'interprétation
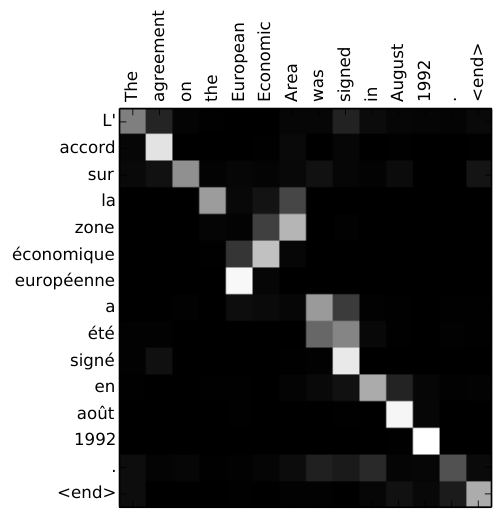 Voir l’image en grand
Lire une ligne horizontalement : elle donne les poids des mots anglais lors de la génération d’un mot français. Le blanc vaut 1, le noir 0. Autour de European Economic Area, les cellules claires quittent la diagonale : zone vise Area, puis économique et européenne remontent la phrase anglaise. Il s’agit d’attention additive dans un encodeur–décodeur récurrent, pas d’une tête d’auto-attention Transformer. Cet alignement appris ne dispense pas des vérifications causales ci-dessous.
Les poids d’attention décrivent les coefficients de routage d’une passe avant donnée, mais ne suffisent généralement pas à établir une importance causale :
- Des poids différents peuvent produire des sorties similaires.
- Les valeurs et les couches ultérieures modifient l’influence finale.
- Les gradients, les remplacements contrefactuels et les interventions peuvent donner des classements différents.
- Une distribution très concentrée ou très plate ne signifie pas automatiquement un bon ou un mauvais comportement.
« Attention is not Explanation » démontre les défaillances de l'interprétation directe ; une analyse concurrente soutient que l'attention peut néanmoins être informative sous des diagnostics et des tests contrefactuels définis. La conclusion défendable est que les poids peuvent constituer des indices, mais qu'ils doivent être associés à des suppressions, remplacements ou autres interventions, ainsi qu’à une validation sur la tâche. Ils ne constituent pas à eux seuls une explication causale.
Liens entre les explications
La normalisation utilise la même opération que la régression softmax, mais les poids mélangent ici les valeurs au lieu de prédire des classes. La note Transformer assemble attention, information de position, connexions résiduelles, normalisation et couches feed-forward. Les variantes d’attention et le cache KV reprennent ces formes Q/K/V pour expliquer l’inférence autorégressive et son coût mémoire.
Cette description en Q/K/V est orientée vers le NLP et la pratique des Transformers. La vision, les ensembles, les graphes et les formulations antérieures à base de noyaux statistiques ne sont abordés qu'à la marge.