预训练、监督微调与偏好优化
模型架构决定信息怎样流动,训练决定参数最终学会什么行为。两个使用同样 Transformer 架构的模型,也可能因为数据、目标和更新方式不同,表现得很不一样。理解训练阶段,可以先问:正确答案从哪里来,损失在奖励什么输出?
预训练从大量样本中学习
自回归语言模型根据前面的 token 预测下一个 token。把文本错开一个位置,就得到了输入和目标。对应的负对数似然为:
假设分词结果为 the / lamp / is / blue,预测 blue 时使用的前文是 the / lamp / is。训练时通过因果注意力掩码,可以同时计算多个位置的损失;生成时还没有未来 token,只能逐个延长序列。自回归生成进一步解释这一区别。
Encoder 也可以通过上下文恢复被遮住的 token。BERT 原论文使用掩码语言建模预训练,再适配下游任务。这种双向表示可以服务分类或抽取,却不会自动变成听懂任意指令的助手。架构上的差异见 Encoder 与 Decoder 家族。
自监督省掉了逐条人工标注,但目标和误差信号仍在:答案就是文本里实际出现的下一个 token。所以模型学到什么,取决于它读到什么:数据来源、重复程度、语言比例和文档边界都会改变结果。
监督微调明确期望输出
监督微调,通常简称 SFT,使用输入与目标组成的样本。聊天助手的输入可以是请求,目标是合适的回答;Encoder 分类器的目标可以是类别标签。SFT 描述训练阶段和数据形式,不要求模型一定采用聊天架构。
对条件文本生成,常见目标是根据提示词和前面的目标 token,预测回答中的后续 token。损失掩码可以排除提示词及填充位置。例如,一条训练记录有 80 个提示 token、20 个回答 token 和 28 个填充 token;若只计算回答部分的平均损失,分母应是 20,不是 128。混淆这一点,会悄悄改变长短回答在训练中的权重。
SFT 的每条样本教的是一个具体决策,所以训练集缺什么样本,模型就缺什么决策。如果训练集里只有“这篇和已存的一模一样 → 丢掉”这种一眼就能认出的重复,模型不会因此学会处理一半重复、一半新增的输入。所以要专门收集这类边界样本和标注分歧,并把同一来源的样本放进同一份数据划分。迁移学习、LoRA 与蒸馏用一个网页剪藏路由器把这个例子讲完整。
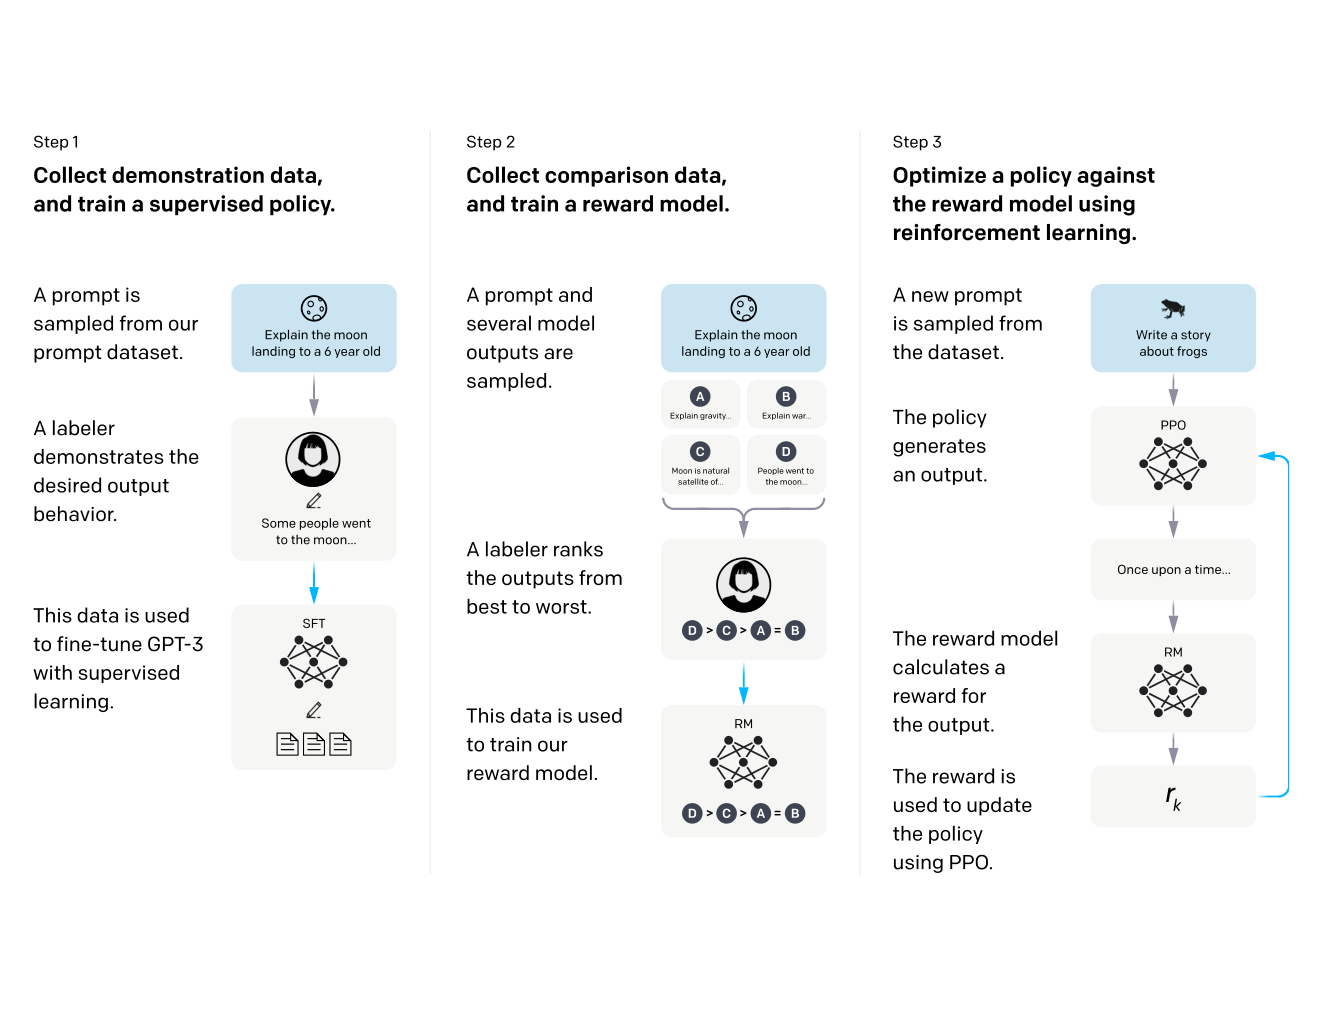
InstructGPT 论文给出了一个具体流程:先用人工示范数据做 SFT,再请人比较同一提示的多个回答,用这些比较训练奖励模型,最后用策略优化提高奖励分数。后两步用到的,就是下一节的偏好数据。
偏好数据比较多个答案
示范数据说“请产生这个答案”,偏好数据说“对同一输入,A 比 B 更好”。两者传递的信息不同。两个回答可能都正确,只是一个更符合格式;也可能都错误,只是一个听起来更有说服力。
奖励模型流程先用比较数据训练一个评分器,也就是奖励模型,再通过策略优化提高评分;同时还约束模型,不要偏离参考策略(通常是偏好训练开始前的那个模型)太远。
直接偏好优化 DPO 的论文证明,奖励可以换一种写法,直接用正在训练的模型来表示;这样,这个带着“别偏离原模型太远”的目标,最优解能直接写出来。于是可以跳过单独训练的奖励模型,也不用在训练中让模型现场生成回答再打分,直接拿“A 赢、B 输”的样本,用一个简单的分类损失去改模型。DPO 省掉的是奖励模型和训练中的采样,偏好数据照样要收集。
下面三对是设想的标注样本,看每一对在教什么:
如果数据大多像第一行,模型学会的是只回一个标签,事实推理不会因此变好。所以每条偏好标签都要对应一条写明的评价规则,不能只写含糊的“这个更好”。
 查看清晰大图
从左向右看:人工示范训练 SFT 策略,回答排序训练奖励模型,奖励分数再指导 PPO 更新。这是 InstructGPT 在预训练之后采用的具体流程;上文介绍的 DPO 使用另一种偏好优化方式。
答案能由程序判对错时,奖励可以来自检查器
偏好数据要靠人来比较,数学题和编程题却能由程序判分:最终答案和标准答案对得上、代码通过测试,就给 1 分,否则给 0 分。这种奖励叫可验证奖励(verifiable reward)。拿它做强化学习,模型不必模仿谁写好的解题过程,只要在大量尝试里多走能拿分的路。
DeepSeekMath 论文提出的 GRPO(Group Relative Policy Optimization)是 PPO 的一个变体,现在常用来做这一步。它对同一道题采样一组回答,逐个判分,再拿这组分数的平均值当基线。每个回答的分数减去组均值、再除以组内标准差,就是它的优势(advantage),也就是它比同组回答好多少。PPO 要另训一个价值模型来估计基线,GRPO 用组均值代替,省下了这部分内存。防止模型偏离参考模型太远的 KL 项,直接加在损失里。
拿一组 4 个回答来看:两个答对得 1 分,两个答错得 0 分,组均值是 0.5。答对的两个得到正优势,答错的两个得到同样大小的负优势,下一步更新就往答对的写法上挪。如果 4 个全对或全错,每个分数都等于组均值,优势全是 0,这道题对更新不起作用。所以题目要挑底模偶尔能做对的:太简单和太难的题都给不出信号。
DeepSeek-R1 论文把这条路用在了推理模型上。DeepSeek-R1-Zero 不先做 SFT,直接在底模上用规则判分做强化学习。数学题要求把最终答案写进指定格式(例如方框里)再核对;另有格式奖励,要求把推理过程写在指定标签内。论文报告,训练过程中 AIME 2024 的 pass@1 从 15.6% 升到 77.9%。论文没有用神经网络奖励模型,理由是大规模强化学习里它容易被钻空子(reward hacking)。R1-Zero 的推理过程难读,还会中英混杂。所以正式的 DeepSeek-R1 先用少量长思维链数据做 SFT 冷启动,再依次做强化学习、拒绝采样加 SFT,最后做一轮面向有用与无害的强化学习。
检查器只奖励它检查到的东西。如果规则是“每加一个引用就得一分”,模型会学会堆引用,不管引用是否支持结论;强化学习一页讲奖励和代理指标怎样被钻空子。所以真正在意的条件(答案对、引用支持结论、格式合法)都要写进检查器,训练后再到留出的题上看分数以外的表现。
个人也能在小模型上跑这一步:TRL 的 GRPOTrainer接受普通 Python 函数当奖励函数,Unsloth也把 GRPO 列为支持的训练方式。
损失降低具体说明了什么
假设正确下一个 token 的概率从 提高到 ,自然对数损失从 降到 。这个目标只奖励模型给实际出现的那个 token 更高的概率,从不另外检查整句话是不是真的。引用准不准、工具调用对不对也一样:这些任务的评价目标不同,文本预测损失低证明不了它们。
同样,提高偏好回答的相对概率,也可能学到意外捷径:更长的答案更容易赢、自信语气更容易赢,或者只学会某位标注者的风格。如果使用场景同时关心事实性、任务成功率、格式和成本,就应分别评估。测试集需要按提示家族或原始文档与训练隔开,具体见数据划分与泄漏。
根据问题选择训练阶段
领域术语学得不好,继续预训练可以让模型接触该领域的文本分布;理解了输入却总用错输出结构,监督示范可能更直接;多个有效答案的实用程度不同,偏好数据可以教它如何选择。每一种都先当作假设,和不做这步训练的基线比,确实更好再投入;三个阶段不必按顺序全做一遍。
假如助手缺的是今天更新的文档,更新权重很难替代实时检索证据。假如本地小分类器反复错分一个常见类别,补一批针对性标签可能比换大生成模型更合适。检索流程和迁移学习分别解释这两类方案。
针对更窄的目标训练,还可能让模型忘掉以前会做的事。所以除了新任务的成绩,也要测旧能力保住了多少,再按验证结果挑检查点。模型名字里的 base、instruct、aligned 只说明它经历过哪些训练;它在你的任务上行不行,要拿你的任务来测。