Tokenization 与模型内部的文本表示
模型处理一句话之前,先把文本变成有限词表中的编号,再查表取出向量。经过网络计算,同一个编号在不同句子里会得到不同的上下文表示。分清这几个阶段,就能解释为什么“一个汉字几个 token”“能否替换 tokenizer”“拿隐藏状态直接做搜索”是三个不同问题。
Token 解决的是怎样编码文本
按整词建词表,会遇到新词、拼写变化和复合词;按单字符编码,序列又可能过长。Sennrich 等人的子词研究用可复用的较小片段表示罕见词。这里的 token 可以是完整单词、词的一部分、标点或字节组合,边界取决于具体 tokenizer。
BPE 从较小单位出发,反复把最常一起出现的相邻片段合并成新片段。用一个很小的语料手算一轮:low 出现 7 次,log 出现 3 次,先都拆成单个字母。相邻字母对里,l+o 在两个词里都有,共出现 次,最多,于是合并成 lo。再数一遍,lo+w 出现 7 次,lo+g 出现 3 次,于是把 lo+w 合并成 low。
合并的先后顺序记下来,就是这个 tokenizer 的规则;遇到新词 lows,按同样的顺序合并,就切成 low 和 s。
WordPiece 使用自己的词表学习与匹配方法;Unigram 为候选切分建立概率模型。这些方法都是按统计切分,并不查词典理解词义。Hugging Face 的算法说明给出了它们的区别。SentencePiece 是可以训练 BPE 或 Unigram 等模型的工具,能够直接处理原始句子,不要求先用空格切出词;见原论文。
在一个假想的教学词表里,重新加载 被编码成 重新、加载 两个 token;换一个词表,也可以是四个单字。
真实 tokenizer 怎么切中文,要从字节说起:UTF-8 里一个常用汉字占 3 个字节,部分生僻字占 4 个。字节级 BPE 在训练语料里见得多的字,几个字节会合成 1 个 token;见得少的字可能拆成好几个字节片段。所以“一个汉字几个 token”没有固定答案,要用所选模型自己的 tokenizer 去数,不能把字符数固定除以某个系数。
同样的道理,一个支持完整字节覆盖的 tokenizer 可以把未见过的字符拆成字节片段,但“能够编码”仍不代表模型理解该语言。稀有字符、emoji、混合语言和长数字都可能占用较多 token。
一个很小的 BPE 分词器从训练文本里逐次学习合并:统计每一对相邻符号出现的次数,把最常见的一对并成新 token。下面两句话用目前学到的合并规则编码。点选一个 token,可以顺着它的编号找到 embedding 表里的那一行。
1 · 学习合并
第 14 次合并:▁r + at → ▁rat,共出现 2 次。词表大小 282。 已经没有出现两次的相邻对,训练在 14 次合并后停止。
▁the▁cat▁sat▁on▁the▁mat.
▁the▁rat▁sat▁on▁the▁hat.
▁the▁cat▁ate▁the▁rat▁on▁a▁mat.
2 · 编码两句话
英文 22 个字符 → 6 个 token
中文 6 个字符 → 19 个 token
虚线框里的 <E7> 这类 token 是单个字节。训练文本里从没出现过的字符,只能拆成它的 UTF-8 字节。把中文加进训练文本,再看 token 数怎样下降。
3 · token → 编号 → embedding 行
▁cat 的编号是 275,模型就取 embedding 矩阵 E 的第 275 行(E 共 282 行 × 4 列)。编号只是行号。
| # | token | 编号 | E 的这一行 | |||
|---|---|---|---|---|---|---|
| 1 | ▁the | 271 | −0.4 | 0.86 | −0.52 | −0.76 |
| 2 | ▁cat | 275 | −0.12 | 0.09 | 0.14 | −0.09 |
| 3 | ▁sat | 277 | 0.45 | −0.62 | 0.33 | 0.07 |
| 4 | ▁on | 273 | 0.31 | −0.03 | 0.67 | −0.73 |
| 5 | ▁the | 271 | −0.4 | 0.86 | −0.52 | −0.76 |
| 6 | ▁mat | 279 | −0.76 | −0.95 | 0.1 | 0.4 |
示意:带字节回退的玩具 BPE,只用图中几句话训练,token 数不代表任何真实分词器。▁ 表示词的开头。embedding 数值是固定种子生成的随机数,代替训练好的权重。
编号怎样变成向量
设词表大小为 ,隐藏宽度为 ,模型保存一个可训练矩阵 。token ID 为 时,输入向量就是矩阵第 行。编号只是索引;编号 20 不比编号 10“多一倍意思”。
还用上面的假想词表,设它包含 BOS=0、重新=1、加载=2,其中 BOS 是标记序列开头的特殊 token。输入 [BOS, 重新, 加载] 对应编号 [0,1,2],查表取出三个向量。取批量大小 2、补齐长度 5、隐藏宽度 4,张量形状依次为:
查表也可理解为 one-hot 向量乘以矩阵,但实现不需要真的分配长度为 的 one-hot。下面的纯 Python 例子只演示查表,不训练模型:
embedding = [[0.0, 0.1], [0.5, -0.2], [-0.1, 0.8]]
ids = [0, 1, 2, 1]
x = [embedding[i] for i in ids]
assert x[1] == x[3]  # 同一个 ID 的初始向量相同
到了上下文层,同一个 ID 就不再对应同一个向量。英文句子 my bank account 和 the river bank 里的 bank 即使是同一个 ID,也会因可见上下文不同而获得不同表示。网络更新表示所用的计算见注意力机制。
顺序和有效位置也属于输入
只有一组词向量不足以表达“猫追狗”和“狗追猫”的区别。模型还需要顺序信息。原始 Transformer 在输入中加入位置向量;RoPE 则旋转注意力中的查询和键。两者接入的位置不同,所以“位置编码”有时是往输入上加一个向量,有时是改写注意力里的查询和键;结构细节见 Transformer。
为了合成批量,长度分别为 3 和 5 的句子可以补齐到 5。补齐 token 占据张量位置,但通常不应成为被注意力读取的有效内容,也不应成为监督损失中的有效目标。注意力 mask 和损失 mask 负责不同事情;把 padding 从 loss 中排除,并不会自动禁止别的位置读取它。具体库还可能分别处理 causal mask、padding mask 和位置编号,应遵守该模型的输入约定。
聊天模板也会增加角色标记、消息边界及生成起始符。比较两次请求的 token 数时,应统计实际序列化后的输入,而不只是肉眼看到的用户句子;服务商的计数接口数的就是这个。截断会删除实际证据;把重要条件截掉以后,提高生成长度无法补回它。
 查看清晰大图
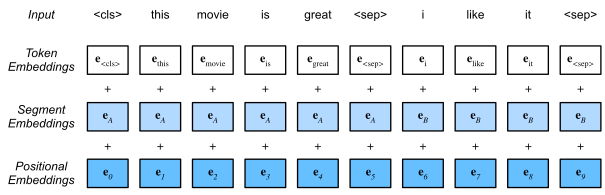
竖着看任意一列:BERT 把三个等宽向量相加。第一行表示 token,A/B 行标记所属句段,最下面一行表示位置。重复出现的分隔符虽然使用相同的 token 向量,句段向量和位置向量却不同。这是 BERT 的输入构造方式;使用 RoPE 的模型会在别处加入位置信息。
三种常被叫作 embedding 的东西
token embedding 是查表得到的初始向量。上下文隐藏状态 是某一层、某一个位置的输出。检索 embedding 通常是经过指定池化和训练目标得到的句子或文档向量。它们可能拥有相同维度,却承担不同任务。
把 [batch,sequence,d] 平均成 [batch,d] 也能得到一个向量,但它能不能拿来搜索,取决于它按什么目标训练过,见 Embedding、Reranker 与分类器。
付费前先数一数
价格、速率限制和上下文窗口都按 token 算,所以发请求前,用服务商自己的计数接口数一遍。截至 2026-10-29,三家的接口如下:
- Anthropic 的
count_tokens接受和创建消息相同的输入,包括 system 提示、工具、图片和 PDF。文档说明这个数是估计值,实际用量可能有少量出入。 - OpenAI 的
POST /v1/responses/input_tokens接受和 Responses API 相同的输入。文档指出,tiktoken 这类本地 tokenizer 适合纯文本,但有局限;接口返回的数还包括消息角色、边界这些格式 token,在本地只对文字分词时数不到它们。 - Gemini 的
countTokens只数输入。文档给的粗略换算是 1 个 token 约 4 个字符,100 个 token 约合 60 到 80 个英文单词。
同一家服务商换代时,计数也会变。Anthropic 的文档写明,Claude 4.7 及之后的模型和 Claude Mythos Preview 使用新的 tokenizer。同样的输入文字大约多出 30% 的 token,具体增幅随内容而变;文档建议按要用的模型重新计数,不要沿用在旧模型上量出的数。一段在旧模型上数出 10,000 个 token 的提示,换到新模型大约是 13,000 个,单价不变时输入费也多三成。
用本地模型时,tokenizer 就在手边。挑几条例子:同义的中英短句、带空格与不带空格的代码、一个生僻字,以及同一句话的纯文本和聊天模板版本,记下 token ID、长度、特殊 token 和解码结果。部分 tokenizer 会规范化文本,所以 decode(encode(text)) 不一定逐字节等于原文。模型权重、tokenizer、特殊 token 配置和聊天模板是匹配的一组;仅替换词表会改变编号含义,原来的嵌入行随即对应错误片段。
理解输入表示后,可以继续读 Encoder、Decoder 与 Encoder–Decoder:它们最大的结构差别之一,就是每个位置能够看到哪些其他位置。
Hugging Face 的 BPE 课程 从词频和相邻片段频率开始,逐步构造 tokenizer。手动跟一轮合并,再看学到的规则如何切分新词,就能分清“学习词表”和“使用已有 tokenizer”这两件事。