分布偏移下的模型评估
2019 年,一组研究者照 ImageNet 当年的做法,重新收集了一套测试图片。一大批图像分类模型在新测试集上的准确率都掉了 11 到 14 个百分点,可它们之间的排名大体没变(Recht 等,2019)。模型一个没改,变的只是测试数据从哪里来;原来的测试分数,只代表原来那批数据。
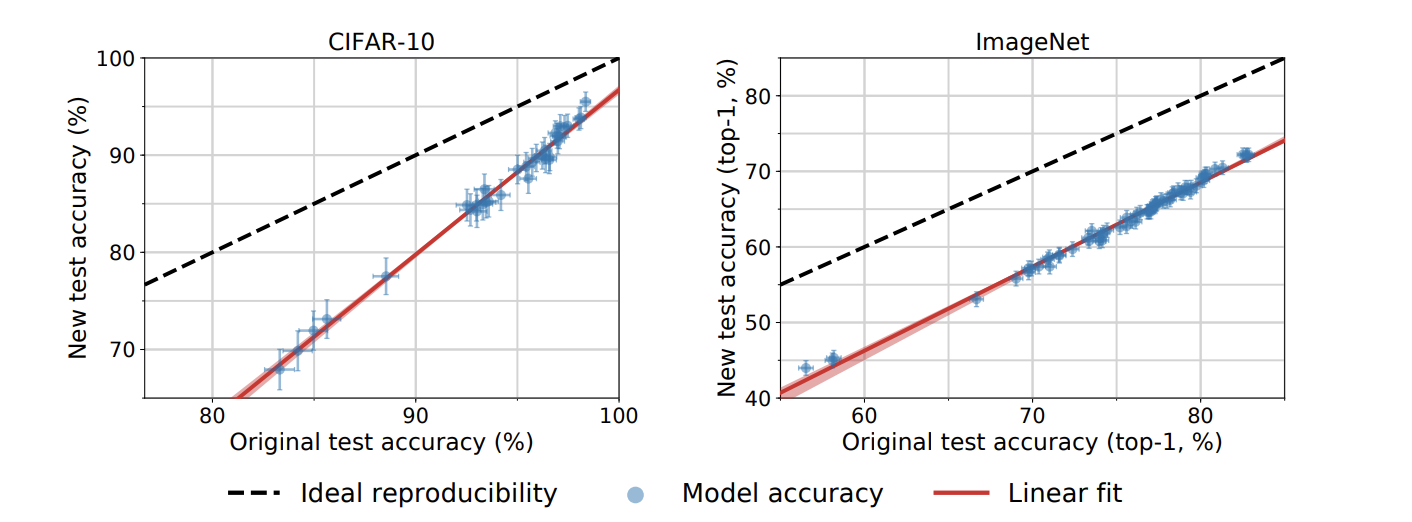 查看清晰大图
每个蓝点代表一个模型:横轴是原测试集准确率,纵轴是重新收集的测试集准确率。点落在虚线对角线下方,就表示换了测试数据后准确率下降;红色拟合线仍显示两组分数有很强的关联。左右两图分别对应 CIFAR-10 和 ImageNet,误差线为 95% Clopper–Pearson 区间。模型的大致排名能够延续,绝对表现却仍可能整体下降。
所以评估不是给模型贴一个永久分数,而是估计:在某个目标分布、阈值、流程和错误代价下,这套系统会怎样表现。
把真正要用模型的那批数据记作部署分布 ,其中 是输入, 是真实结果;损失 衡量一次预测错得多严重。目标风险是
用白话说,目标风险就是模型在真正要用的那批数据上平均错多少。测试集上的平均损失,只有在测试样本近似来自 、没有被开发过程用过、标签与损失定义正确时,才是这个风险的估计。如果测试样本和训练数据来自同一来源、彼此独立,置信区间算得再窄,也只覆盖这一个来源,不包括未来的分布偏移:ImageNetV2 那 11 到 14 个点的下跌,就远在原测试集的置信区间之外。
先写评估对象
system          模型 + 预处理 + 阈值 + 人工流程
unit            一次预测对应什么
population      结果要外推到谁/何时/何地
prediction_time 当时可见信息
outcome_horizon 标签观察窗口与成熟期
action          预测会触发什么
loss            假阳性、假阴性、延迟和弃权成本
如果动作会改变后续数据,静态测试集只能评估上线前策略,不能直接预测反馈回路形成后的表现。
常见的分布偏移
这些分类可重叠。检测到输入分布变了,不等于性能必然下降;没检测到也不证明安全。
个人开发者最常遇到的是另外三种偏移:自己用户的提示词渐渐偏离开发时用的那批;换了一种语言或领域;服务商在同一个模型名背后换了模型。最后一种怎样发现、怎样应对,见在自己的任务上评测模型。
切分必须对应问题
反复查看测试集、只发布效果最好的随机种子,或者根据外部榜单修改系统,都会让测试集退化为验证集。
指标回答不同问题
指标应由业务动作和错误成本决定,不要因为公开榜单用了某指标就照搬。下一节的欺诈例子会把准确率、精确率和召回率各算一遍,看它们怎样给出相反的印象;其余常见指标各自回答的问题如下。
分类任务里,ROC-AUC 衡量排序能力但不给出运营阈值;PR-AUC 更关注正类,但基线会随正类比例变化;对数损失和 Brier 分数评估概率质量的不同侧面;校准度比较预测概率与实际观察频率,且会随分布和样本量改变。
示例:1% 欺诈率
一万个交易中有 100 个欺诈。永远预测“正常”的系统,accuracy(预测对的比例)为 99%,却一笔欺诈也拦不住,recall 为 0。accuracy 主要由占多数的类别决定,这里就是正常交易。
所以要看另外两个数。precision 问的是“标记出来的交易里,有多少真是欺诈”;recall 问的是“真正的欺诈里,有多少被标记出来”。假设模型在某阈值下标记 200 笔,其中 60 笔是真欺诈:
precision = 60 / 200 = 30%
recall    = 60 / 100 = 60%
两个数都随阈值变:阈值放低,标记得更多,recall 会升,precision 往往会降。
若没有标记任何样本,precision 的分母为零,因而无定义;若测试切片没有正类,recall 无定义。应报告这些情形,不要默认当成预测成功。
是否可用还取决于:200 次人工审核成本、漏掉 40 笔的损失、合法客户摩擦、标签延迟以及下月基率。把阈值调到测试集收益最高后再报告同一个数字,会高估泛化;阈值必须在验证集确定,再到时间后移的测试集上检验。
基率也会改变 precision。这里 200 笔里有 140 笔是误标的正常交易,假阳性率为 。设基率为 (欺诈占全部交易的比例)、真阳性率为 (真欺诈被标记的比例,也就是 recall)、假阳性率为 (正常交易被误标的比例),则
公式的分子是被标记的真欺诈,分母是全部被标记的交易。如果只是基率变了,每一类内部的得分分布不变(也就是先验偏移), 和 就都不变。把基率升到 5% 代进去:分子是 ,分母再加上 ,precision 约为 ,recall 仍为 60%。同一个模型、同一个阈值,precision 从 30% 升到 69%,只因为欺诈变多了。定义见 scikit-learn 指标文档。
阈值怎样由误报和漏报的代价定出来,见概率校准、决策阈值与弃权;单个 ROC-AUC 值给不出阈值。
不确定性至少有三层
- 评估样本误差:解析区间或 bootstrap 区间;在相同案例上比较模型要保留配对,有群组或时间依赖时需按群组或时间块重采样;
- 训练随机性:不同初始化、数据顺序和非确定 kernel;应重复 seed;
- 环境不确定性:未来政策、行为、传感器和人群变化;同源独立样本算出的区间通常不覆盖。
只报告均值±一个不明区间会混淆这些来源。还应给分子/分母、每切片样本量和失败运行。
切片、阈值与弃权
总体指标可能掩盖关键群体、设备、语言、时间或难度切片。切片应在看结果前由用途与风险确定;大量事后切片会产生选择性发现,需要校正或新数据确认。
在错误后果严重的场景中,可以设置模型弃权、转交人工的区域。评估这一安排时,也要考虑人工处理能力、队列容量和选择偏差。模型置信度不等于正确概率;分布偏移时,概率校准和不确定性估计可能同时失准。
公共 benchmark 和自己的测试集各有哪些偏差,见怎样判断 AI 实验的证据强弱。