激活函数与门控前馈网络
几层线性变换叠在一起,结果仍是一个线性变换。所以没有激活函数,再深的网络也只等于一层(见多层感知机)。激活函数夹在两层之间,决定每个单元怎样把输入弯折,网络才拟合得出曲线和边界。
现代 Transformer 在这之上还改了一处更大的地方:把前馈网络(FFN)拆成两条分支再相乘。一条分支算内容,另一条分支决定这份内容放行多少,而且放行多少随每个 token 变化。
这里讨论的是单个位置内部的非线性与通道混合;跨位置的信息交换见注意力机制。FFN 的门控对通道数值做乘法,而 MoE 路由为 token 选择专家网络,两者可以同时存在。参数怎样通过损失更新,见训练过程;输出层该接 Sigmoid 还是 Softmax 由任务决定,见多层感知机的输出头一节。
逐元素激活决定每个单元怎样弯折输入
表中 。 是标准正态分布的累积分布函数(CDF),即标准正态变量不超过 的概率,所以 GELU 是把 乘上一个 0 到 1 之间、随 增大的系数。精确 GELU 使用 ,常见的 tanh 表达式是它的近似,不同 kernel 在混合精度下会有小差异。
两个名字和记号的约定也要写清。Swish 论文讨论可学习的 ,而框架中的 SiLU 通常固定 ,文献常把二者近似同义,比较时必须写清实现。表中的 假设 ;若 PReLU 的参数不受此约束,就按分段形式定义:非负输入取 ,负输入取 。
SiLU 的导数为 。在零点,ReLU、GELU、SiLU 的输出均为零,但 GELU 与 SiLU 的导数为 ;ReLU 在此没有唯一导数,实现时须选择约定。 时,SiLU 约为 ,导数约为 。所以 SiLU 拿来当门时,门值不限于 :可以略小于零,也可以大于一。
 查看清晰大图
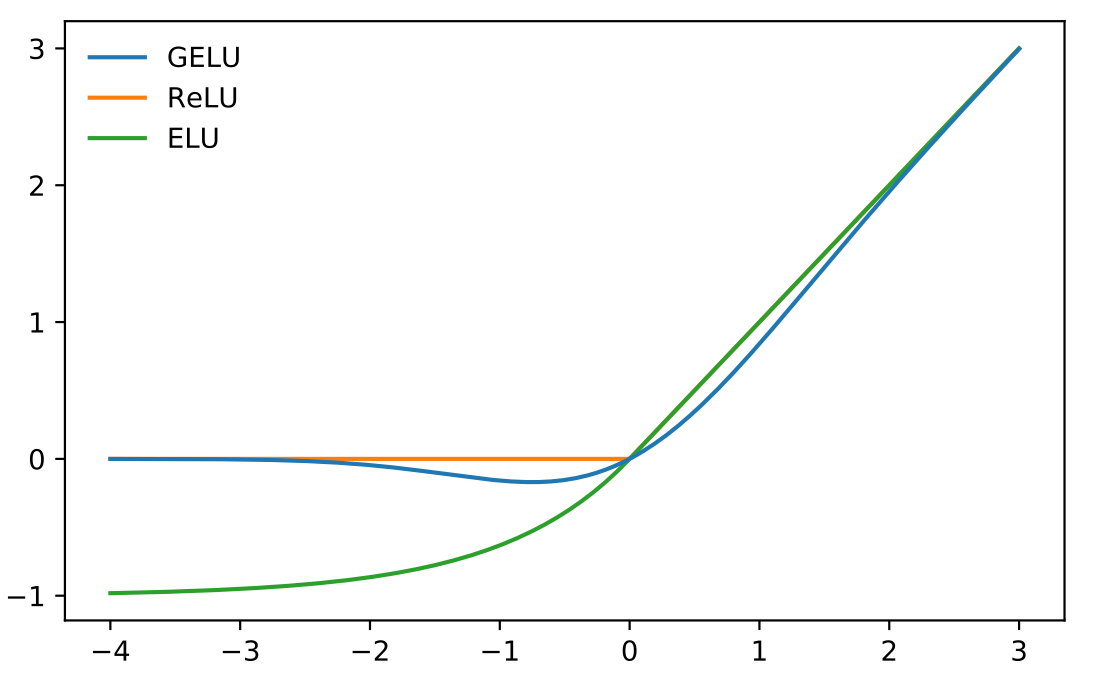
重点看负输入:ReLU 直接输出零,GELU 先落到零以下,在输入很负时又趋近零;α = 1 的 ELU 则趋近 −1。蓝线是标准 GELU。
门控 FFN 让一条分支决定另一条放行多少
普通 Transformer FFN 先用 把一个 token 的向量投到更宽的中间层,过激活函数 ,再用 投回原宽度:
门控线性单元(GLU)把两条投影相乘: 给出内容, 给出 0 到 1 之间的放行比例, 表示逐元素相乘。简化写法为
在 Transformer 中,常见变体可写为
这里 算出门分支, 算出值分支,两者逐元素相乘后由 投回原宽度。ReGLU 则把门分支换成 ReLU。
看 SwiGLU 在一个 token 上做了什么。设中间只有两个通道,某个 token 的门分支 ,值分支 。过 SiLU 后门约为 ,因为 ,。逐元素相乘得 :第一个通道被放大,第二个通道几乎关掉。
换一个 token,设它的门分支是 ,值分支仍是 。门变成约 ,乘积约为 :这回第一个通道关上,第二个通道打开。
门的值由输入算出来,所以同一个通道可以对这个 token 打开、对那个 token 关上。普通 FFN 里,一个通道放行多少和输出多少是同一个数:过 ReLU 后,它要么原样输出自己那一格 ,要么输出零。门控 FFN 把这两件事拆给两条投影,一条决定放多少,一条决定放什么,输出是两个随输入变化的量的乘积。
门控层有 、、 三个主要投影,普通 FFN 只有输入、输出两个;中间宽度不变的话,参数和计算都会增加。所以等参数比较要缩小门控层的中间宽度。
不含偏置、输入和输出宽度均为 、中间宽度为 的普通 FFN 有 个权重;门控 FFN 中间宽度为 时有 个权重;令二者相等得 。这是 GLU Variants Improve Transformer 中的局部参数量比较。
例如 时取 。门和值分支各把 6 维映射到 8 维,逐元素相乘后仍为 8 维,再投影回 6 维。普通 FFN 是 ,门控 FFN 是 ,两者都是 144 个权重。
下载模型时,这个中间宽度 写在 Hugging Face 的 config.json 里,名字叫 intermediate_size。Qwen3-8B 的配置写着 hidden_size: 4096、intermediate_size: 12288、hidden_act: "silu",权重索引里每层 FFN 有 gate_proj、up_proj、down_proj 三个矩阵,也就是这里的 、、。所以每层 FFN 有 亿个权重。按 倒推,这和中间宽度 18432 的普通 FFN 一样多。
现代架构里的实例
- BERT 原始架构使用 GELU;
- PaLM 报告采用 SwiGLU;
- Llama 3 架构报告也采用 SwiGLU,并把它与 RMSNorm、RoPE、GQA 等一起作为完整 block 的一部分;
- ConvNeXt 展示了现代 ConvNet 也可采用 GELU,平滑激活不只用在 Transformer 里。
换激活要在同等预算下比较
激活函数没有一个在所有任务上都更好的排名。论文里的更高平均分,和上面那些模型选了 GELU 或 SwiGLU,都只在各自的规模、模态和硬件上成立。收益还和初始化、归一化、宽度、数据和 fused kernel 缠在一起;架构里多项改动一起变时,也不能全部记在激活头上。
所以换激活时,先固定数据切分、优化器、步数和随机种子。再报告中间宽度、总参数和峰值内存。 只是不计偏置的权重账,两种 FFN 参数相等,实测延迟仍可能差很多。所以还要在目标 dtype 和硬件上测端到端吞吐:缺少 fused kernel 的新激活会变慢,量化以后也会因为数值范围变了而退化。
训练中如果大量单元恒为零或梯度接近零,先查 ReLU 失活和 Sigmoid/Tanh 饱和。最后留一个稳定的 ReLU 基线,它能看出门控的收益是不是只来自参数变多。