卷积神经网络
卷积神经网络(CNN)针对网格状数据(如图像)内置了两个核心假设:
- 局部性:邻近值先发生交互,远处值要经过更多层才能影响当前位置;
- 参数共享:同一个检测器(卷积核)在图像的不同位置复用。
这两个假设大幅削减了参数量,并赋予模型平移等变性:输入图像平移后,输出的特征图也会随之平移。注意,等变(Equivariance)不等于不变(Invariance)。池化、聚合、数据增强或任务设计可能带来一定的平移容忍度,但单纯的卷积操作本身不会让输出对平移保持不变。
互相关层
深度学习框架中所谓的“卷积”操作,底层实现的通常是互相关(Cross-Correlation)。对于输入 和卷积核 ,计算公式如下:
卷积核遍历所有输入通道 ,生成一个输出通道 。多个卷积核并行工作,从而生成多张特征图。
在一维情况下,若卷积核宽度为 、两侧填充为 、步幅为 ,输出长度为:
高度和宽度的计算逻辑相同,独立进行。空洞卷积(Dilation)通过在卷积核元素间插入间隔来扩大感受野,从而改变有效卷积核大小。
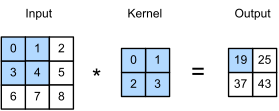 查看清晰大图
高亮窗口在每个位置复用同一组核参数。左上角输出为 0×0 + 1×1 + 3×2 + 4×3 = 19,窗口滑动后得到其余输出。这个例子只有一个通道,步幅为 1,且不加填充。
手算卷积核与输出形状
输入 ,核为 ,偏置为零,无填充、步幅为一,互相关输出为 :每个位置计算相邻值之差。数学卷积会翻转核,在同样只取有效窗口的约定下输出 。
普通稠密二维卷积层的输入若为 [B, 3, 32, 32],有 16 个形状为 [3, 3, 3](输入通道、高、宽)的核,填充为一、步幅为二,输出就是 [B, 16, 16, 16]。含偏置共 个参数,与图像宽高无关。某个共享权重的梯度,要把所有使用它的空间位置和批次样本的贡献加起来。
空洞率为 时,把输出长度公式中的 换成 。上面的互相关公式默认步幅和空洞率均为一,且索引有效;填充负责补充边界值。填充与步幅的教材讨论说明了边界处理的影响。在无限网格上,步幅为一的卷积具有严格平移等变性;有限填充会在边缘破坏这一性质,步幅为二时一般只对与采样网格对齐的平移保持等变。池化也不保证对任意平移不变。
核心组件
- 填充(Padding):处理边界像素,常用于保持特征图的空间尺寸不变。
- 步幅(Stride):控制卷积核移动的步长,实现下采样。
- 池化(Pooling):对局部邻域进行统计汇总(如取最大值或均值),不包含可学习的空间权重。
- 卷积:在每个空间位置独立地混合通道信息,可调整通道数;增加非线性还需配合激活函数。
- 堆叠层:逐层扩大感受野,将局部特征组合成更高层的语义表示。
局限与边界
- 归纳偏置的有效性:局部性和平移结构并非所有数据都具备,需视具体任务而定。
- 下采样风险:池化等操作可能丢失微小目标或精确位置信息。
- 感受野误区:感受野大不代表模型能有效利用所有相关上下文。
- 鲁棒性验证:在随机裁剪下表现好,不等于能抵抗真实的分布漂移。
- 数据主导性:数据集构造和增强策略对性能的影响,可能超过架构上的改动。
如果输入数据不具备明显的空间结构,建议优先使用小型 MLP 或线性模型作为基线。关于更多实现细节与练习,参考 Dive into Deep Learning: Convolutional Neural Networks。
CNN Explainer 可以让你跟随一张示例图像穿过小型卷积网络。先查看一次卷积及其激活图,再比较池化保留了什么,把本文的局部卷积计算与整网的空间尺寸、通道变化联系起来。