数据划分与泄漏
2008 年的 KDD Cup 比赛要从乳腺 X 光数据里找出癌症。Kaufman 等人 2011 年的论文回顾这场比赛时写道:大多数参赛者没理会的病人编号,本身就有极强、出人意料的预测力。数据由多个临床研究、机构或设备来源拼成,每个来源分到一段连续的编号,合并时又没有隐去来源,于是编号透露了病人来自哪里,而有的来源患癌比例高。
编号里的信号来自数据拼合的方式,不来自乳腺影像本身;真正筛查新病人时,不会有这样一段按来源排好的编号,比赛里的高分也就不作数。这就是数据泄漏(Data Leakage):训练、特征工程、模型选择或评估环节使用了在真实预测场景中不可得的信息,导致评估结果虚高。
删掉编号也不一定就干净了。Kaufman 等人指出,如果不同编号段对应不同地点、不同设备的医院,数据里还会留下别的痕迹:比如患癌比例高的那家,图像灰度也偏高,模型不看编号,照样能从其余数据认出来源,分数仍然偏乐观。
这类错误在科研里也不少见。Kapoor 和 Narayanan 2022 年调查了采用机器学习方法的研究领域,在 17 个领域里找到已被指出的泄漏错误,涉及 329 篇论文,有的结论被严重高估。
防泄漏的办法,是先说清预测那一刻能拿到哪些信息,再让切分和每一步预处理都守住这条边界。文末用一个反复改提示词的例子,把下面的规则用到大模型评测上。
定义信息边界
在动手切分数据前,必须明确以下元数据:
unit             预测对象(如:患者、订单、设备)
prediction_time  必须做出预测的时间点
horizon          预测目标的时间跨度(如:未来30天)
available_info   预测时刻真实可用且合规的信息集合
label_time       标签生成、成熟及可能修订的时间
split_key        禁止跨集合的实体、群体或时间维度
信息的合法性是相对于部署时的信息集 而言的。数据库里存在某个字段,不代表它在预测时刻 已经生成,也不代表业务规则允许模型使用它。
泄漏类型与对策
注意: 强相关特征(Proxy)不一定非法,判断标准是:该信息在预测时刻是否真实存在且被允许使用。部署时合法可用的 Proxy 特征,可能只是捷径、偏见或脆弱的相关性,这属于模型鲁棒性问题,而非严格意义上的泄漏。对此应通过子群体分析、干预测试和分布偏移检测来评估,而不是简单地将所有强相关特征视为泄漏。
切分策略应模拟真实使用场景
不同的部署问题需要不同的切分逻辑:
提示: 分层抽样(Stratification)仅保证标签比例一致,它不能防止同一实体、时间邻近或重复样本跨越训练/测试边界。
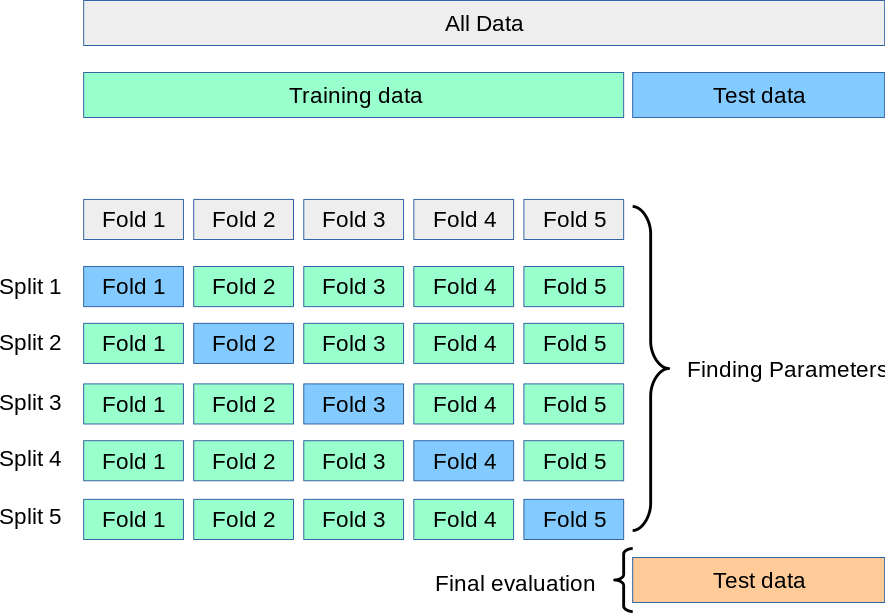 查看清晰大图
先看右侧:测试集从一开始就单独留出。左侧每一行用一个蓝色折做验证,其余绿色折用于拟合;预处理也要在每轮的训练折内重新拟合。测试集不参与选模型,只用于最后评估。图中用五折演示这个过程,实际切几折、按什么分组,由上一节的部署问题决定。
Pipeline 不变量
设训练索引为 ,验证索引为 。任何从数据中学习参数的变换 必须满足:
这涵盖了标准化、缺失值填充、词表构建、PCA、特征选择、目标编码(Target Encoding)、过采样及学习式数据增强。
- 交叉验证(CV): 每一折内部都必须重新拟合所有变换。
- 嵌套交叉验证(Nested CV): 外层循环用于评估泛化性能,内层循环用于超参数或特征选择。
- 常见错误: 先在全量数据上做特征选择,再划分交叉验证折,依然构成泄漏。
一个只用训练数据拟合的变换
scikit-learn 泄漏指南遵循同一规则:在训练数据上学习预处理参数,然后原样应用。假设训练特征值为 2 和 4,验证值为 100。训练集均值为 3,所以验证值中心化后为 97。若全局中心化,均值会变成 ,验证数据便改变了训练样本的表示。
train = [("A", 2.0), ("B", 4.0)]
valid = [("C", 100.0)]
assert {g for g, _ in train}.isdisjoint(g for g, _ in valid)
center = sum(x for _, x in train) / len(train)
assert [x - center for _, x in train] == [-1.0, 1.0]
assert [x - center for _, x in valid] == [97.0]
这个示例测试的是新实体:A、B 在训练集,C 只在验证集。如果要预测的是已知患者的下一次就诊,就可以合法使用他当时已有的历史记录;患者不重叠的测试回答的是另一个问题:模型对没见过的患者表现如何。若目标是未来的新患者,应先定一个时间截点:训练只用截点之前、标签已经成熟的记录,测试只用截点之后、从未进入训练集的患者。这样做会把截点前就来过的老患者排除在测试之外,测试人群因此变了,报告里要写明排除了多少人。
流水线能防止跨折拟合错误,却不能消除训练集内部的所有目标泄漏。目标编码可能把某行自身的标签写入该行特征;训练编码应采用折外计算或合适的时序计算。重采样只作用于训练数据,不要改变验证集和测试集的类别比例。
实战案例:反复改提示词,测试集悄悄变成了验证集
场景: 设想你在给一个只回答自家产品手册的问答助手调系统提示词。手里有 30 道写好标准答案的题,每改一版提示词就把 30 道全跑一遍,挑分数最高的那版上线。
错误设计:
- 每一版提示词都照着这 30 道题的分数来改。改过二十轮以后,这 30 道题就成了验证集,分数涨的那部分里有一截是对这 30 道题本身的拟合。
- few-shot 示例从这 30 道题里挑,等于把考题和答案写进了提示词。
- 为了凑题量,先让模型把每道题改写成五种问法,再随机切出测试集,于是同一道题的改写同时落进调参集和测试集。
- 检索增强的题是按手册片段出的。同一份文档的片段一部分出了调参题,一部分出了测试题,两边的问题共用同样的上下文和措辞。
稳健设计:
- 先切再扩: 先按原始题目分组(检索增强的题按源文档分组)切出调参集和测试集,再在调参集里做改写和扩充。
- 示例只从调参集取: few-shot 示例和提示里的样例回答只来自调参集。
- 调参只看调参集: 每一版提示词都只在调参集上比较,测试集锁起来不看。
- 测试集只跑一次: 选定最终版本后跑一次,按题型报告结果。之后还要再改提示词,就换一批新题当测试集。
- 固定运行配置: 模型 ID、温度和评分方式写进运行卡片,测试前后保持不变。
换成新题以后分数如果明显下降,说明旧分数里有一截来自对那 30 道题的拟合。这和 KDD Cup 2008 里的病人编号是同一类问题:分数里混进了真实使用时拿不到的信息。
泄漏探针与负对照
为了主动发现泄漏,建议执行以下检查:
- 时间审计: 为每个特征记录事件发生时间、入库时间、修订时间。
- 单特征探针: 单独训练可疑特征,若性能异常高,需追溯其数据血缘。
- ID 探针: 移除或打乱实体标识符及高基数代理特征。KDD Cup 2008 的病人编号就是这一条要抓的东西。
- 重复审计: 检查精确重复及近重复样本。
- 标签置乱(Permutation): 若完整流水线在随机打乱标签后仍显著高于随机基线,可能存在代码缺陷或泄漏。
- 边界断言: 代码层面断言同一组样本不跨集合、前向评估时训练时间早于测试时间、变换器未在测试集上拟合。
- 全新保留集: 对于被反复查看过的基准测试集,另取一批全新的保留数据。
局限: 标签置乱无法发现所有泄漏。它只能抓到流水线里会跟着标签重新计算的泄漏。如果泄漏特征是用真实标签预先算好、存在表里的,标签一打乱它就对不上了,置乱后的分数照样回到随机水平,检验显示正常,泄漏却还在。所以必须结合数据血缘分析。
概念辨析
- 过拟合(Overfitting): 模型学习了训练样本中的噪声,即使流水线合法也可能发生。训练准确率高本身不等于泄漏:过拟合的模型,训练准确率同样很高。
- 泄漏(Leakage): 开发流程越过了信息边界。
- 分布偏移(Distribution Shift): 部署时的数据分布与评估时不同。
- 混杂(Confounding): 共同原因扭曲了因果解释。
这四者可以同时存在:修好泄漏以后,过拟合和分布偏移照样可能还在。
发布前检查清单
prediction_time: explicit
label_horizon_and_maturity: explicit
unit_and_group_key: explicit
split_algorithm_and_seed: versioned
all_learned_transforms_fit_on_train_only: true
test_used_for_selection: false
duplicate_and_overlap_audit: complete
feature_availability_lineage: reviewed
known_residual_risks: listed