精读 Attention Is All You Need:原始 Transformer 论文
2017 年,Vaswani 等八位作者(当时大多在 Google Brain 和 Google Research)发表了 Attention Is All You Need,提出 Transformer。论文做的是机器翻译,模型是编码器—解码器结构;今天的大语言模型大多只沿用了其中的解码器。带着这个背景读原文会顺很多:作者要回答的是“翻译模型能不能完全不用循环和卷积”,而不是“怎样搭一个聊天模型”。
下文按论文的章节顺序展开,章节、表格和公式编号都对应 arXiv 第 7 版。注意力本身的数值例子见注意力机制;RMSNorm、RoPE、GQA、SwiGLU 等现代组件见 Transformer:从原始架构到现代组件,这里不再重复。
2017 年的问题:循环让训练只能排队
第 1 节先交代当时的主流:LSTM、GRU 这类循环网络在语言建模和机器翻译上领先。循环模型沿着序列位置一步步算,第 个隐藏状态 由 和第 个输入得到。作者指出,这种固有的顺序性让同一个训练样本内部无法并行;序列越长,问题越突出,因为显存又限制了能放进一个批次的样本数。分解技巧和条件计算提高了效率,但顺序计算这一根本约束还在。
注意力当时已经是翻译模型的常用部件,它不管两个位置相距多远都能直接建立依赖,可几乎总是和循环网络配合使用。论文的提议是把循环整个去掉,只靠注意力在输入和输出之间建立全局依赖。
第 2 节把 Transformer 和另一条减少顺序计算的路线放在一起比较。Extended Neural GPU、ByteNet 和 ConvS2S 用卷积并行计算所有位置的隐藏表示,但要把任意两个位置的信号联系起来,所需的操作数会随距离增长:ConvS2S 线性增长,ByteNet 对数增长,远距离依赖因此更难学。Transformer 把这个数降到常数。作者也承认代价:对注意力加权的位置取平均,会降低“有效分辨率”,这正是多头注意力要弥补的。
所以这篇论文同时盯着两件事:训练时能并行多少,以及远处两个位置之间的信号要走多长的路。第 4 节的表 1 会把这两点写成复杂度。
论文定义的架构
第 3 节沿用当时序列转换模型的通用框架。编码器把输入符号序列 映射成连续表示 ;解码器根据 一次生成一个输出符号,得到 。每一步都是自回归的:已经生成的符号作为额外输入,用来生成下一个。
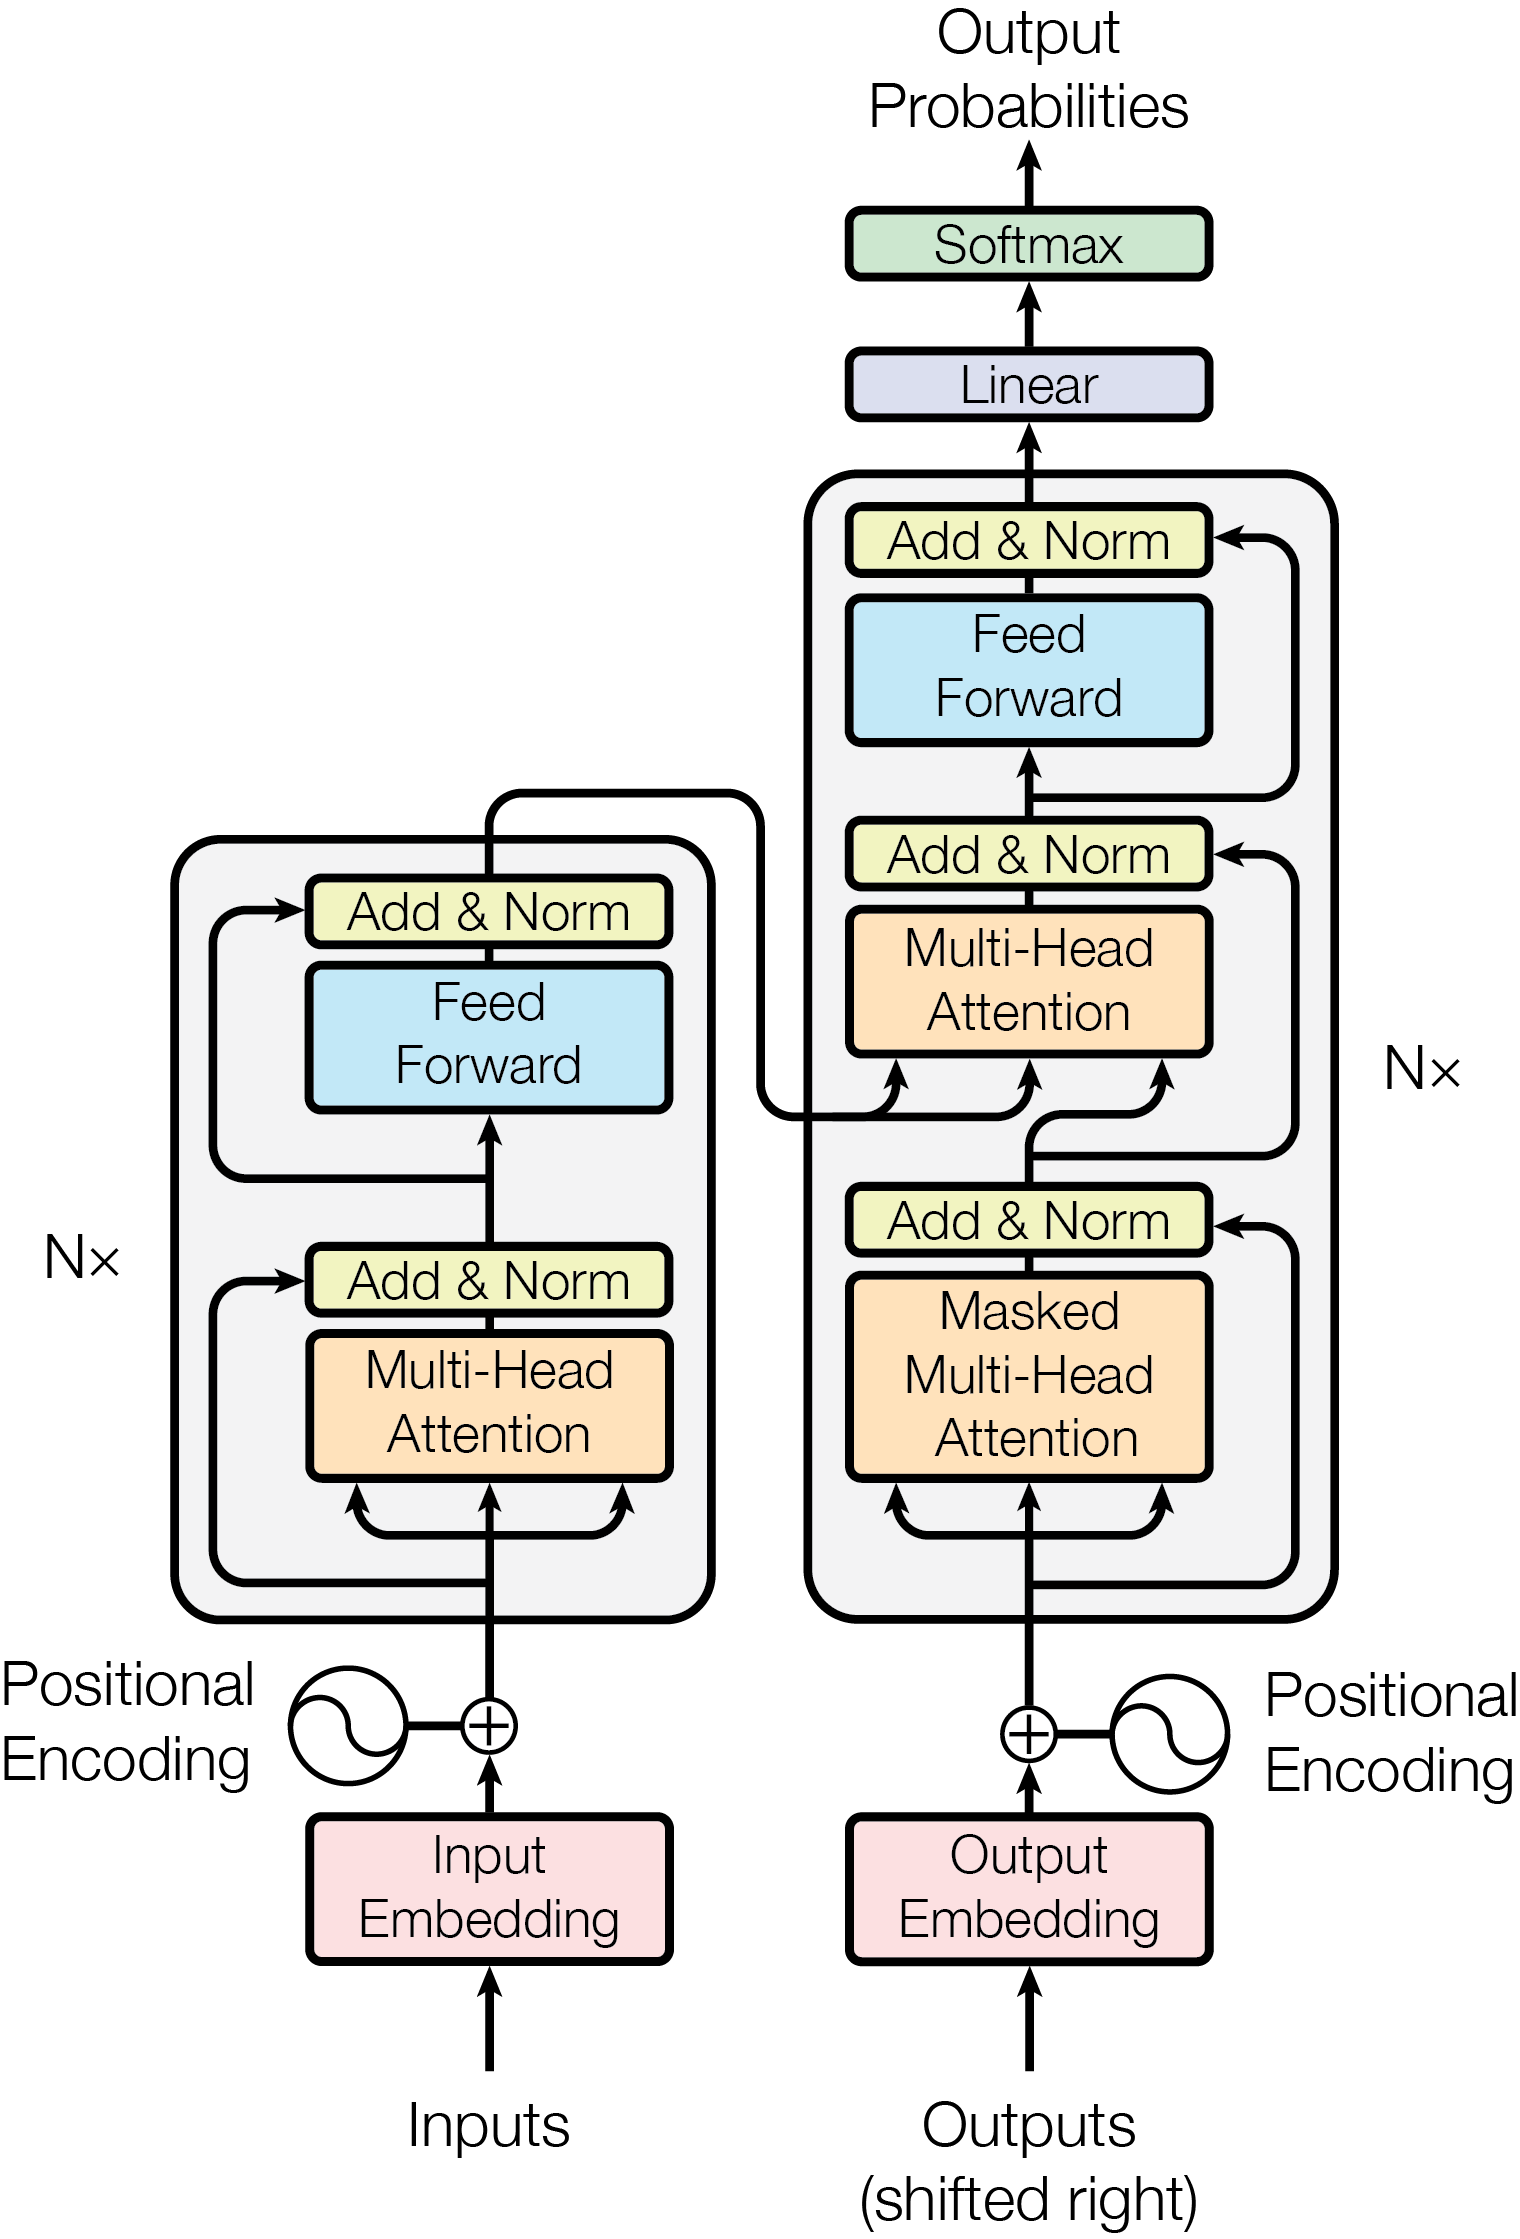 查看清晰大图
左半边是编码器,右半边是解码器,旁边的 N× 表示同样的层堆叠 次。每个子层旁边绕过去的箭头是残差连接,“Add & Norm”表示先相加、再做层归一化。解码器中间那个注意力子层的两路输入来自编码器输出,第三路来自解码器自身。
第 3.1 节给出两个堆栈的构成。编码器由 个相同的层组成,每层两个子层:多头自注意力,以及逐位置的全连接前馈网络。解码器同样是 层,在这两个子层之外再插入第三个子层,对编码器堆栈的输出做多头注意力。
每个子层外面都包一个残差连接,随后做层归一化,也就是子层的输出为
归一化放在残差相加之后,这种顺序后来被称为 Post-Norm。为了让残差能直接相加,模型里所有子层和嵌入层的输出维度都是 。
解码器的自注意力加了掩码,不让一个位置看到它后面的位置。再加上输出嵌入整体右移一位,位置 的预测就只能依赖位置小于 的已知输出。比如要训练模型输出 [A, B, EOS],解码器的输入是 [BOS, A, B]:预测 B 的那个位置只能看到 BOS 和 A。
注意力在模型里的三种用法
第 3.2.3 节列出了多头注意力的三处用法。三者的计算完全相同,区别只在 query、key、value 取自哪里,以及能看到哪些位置:
第三种就是常说的交叉注意力,它沿用了此前序列到序列模型中典型的编码器—解码器注意力。解码器自注意力的掩码在缩放点积注意力内部实现:softmax 之前,把所有非法连接对应的值设为 ,它们的权重就恰好为零。
缩放点积注意力:点积为什么要缩放
第 3.2 节对注意力的定义很朴素:把一个 query 和一组 key–value 对映射成输出,输出是 value 的加权和,每个 value 的权重由 query 与对应 key 的相容性函数算出。第 3.2.1 节选用的相容性函数是点积。把多个 query 打包成矩阵 ,key 和 value 打包成 、,就得到论文的公式 (1):
其中 是 query 和 key 的维度,value 的维度记为 。当时最常用的两种注意力是加性注意力和点积注意力,后者与上式只差一个缩放因子 。两者理论复杂度相近,但点积可以直接调用高度优化的矩阵乘法,实际上快得多,也更省内存。
为什么要缩放?论文引用的实验显示, 较小时两种注意力表现相近, 较大时,加性注意力胜过不缩放的点积注意力。作者猜测, 大时点积的绝对值会变大,把 softmax 推到梯度极小的区域。脚注给了理由:假设 和 的各分量是独立的随机变量,均值为 0、方差为 1,那么 的均值为 0,方差为 。除以 ,方差就回到 1。
按论文的配置 ,点积的标准差约为 8。设想两个 key 的未缩放分数分别是 8 和 0,softmax 给前者的权重约为 0.9997,几乎是独热分布,这时 softmax 对分数的导数 只剩约 0.0003;除以 8 后分数变成 1 和 0,权重约为 0.73 和 0.27,导数约为 0.20。这只是手算示意。论文把“梯度变小”写成一种猜测,没有为它单独做实验。
下图用一个七个词的短句演示同样的计算。为了能手算,图里的向量只有 2 维,所以分数除以的是 ,论文里则是 。打开因果 mask,就能看到解码器自注意力怎样把后面的词屏蔽掉;切到“两个头”,可以先看一眼下一节的多头拼接。
先选一个提问的词(query),再一步步加上计算的各个部分。
每一行是一个 query,每一列是一个 key。每行单独做一次 softmax,合计 100%。点某一行,就把那个词设为 query。
q(它) = [2.2, 0]
| Key | k | q·k/√2 | 权重 |
|---|---|---|---|
| 那只 | [0.2, 0] | 0.31 | 4.0% |
| 猫 | [2, 0.4] | 3.11 | 66% |
| 睡了 | [0.3, 1.6] | 0.47 | 4.7% |
| 因为 | [0, 0.2] | 0.00 | 2.9% |
| 它 | [1, 0.3] | 1.56 | 14% |
| 很 | [0.1, 0.5] | 0.16 | 3.4% |
| 累 | [0.4, 1.4] | 0.62 | 5.5% |
头 1:看意思 · 加权求和
输出 o1 = Σ w·v = [2.67, 1.16]
头 1:看意思 · 所有查询
这些向量是手工挑的,为了让两种模式一眼可见。训练出来的模型里,头很少这么干净。
多头注意力:8 个 64 维的头
第 3.2.2 节没有直接用 维的 query、key、value 做一次注意力,而是用 组不同的学习投影,把它们分别投影到 、、 维,在每组投影上并行做注意力,再把 个 维输出拼接起来,最后投影一次:
投影矩阵的形状是 、、。论文取 ,每个头 。
用一个 10 个 token 的句子走一遍形状:输入是 ,每个头把它投影成 的 Q、K、V,算出 的权重,输出 ;8 个头拼起来回到 ,再乘 的 。因为每个头的维度缩小了,总计算量和一次全维度的单头注意力相近。按这些形状算,一个多头注意力子层有 4 个 的权重矩阵,共 1,048,576 个权重。
作者给出的理由是,多头注意力让模型能在同一时间、从不同的表示子空间关注不同位置的信息;只有一个头时,加权平均会把这些信息抹平。表 3 的 (A) 组检验了这一点,结果见下文。
其余三个组件
逐位置前馈网络
第 3.3 节:编码器和解码器的每一层除了注意力子层,还有一个全连接前馈网络,对每个位置单独、相同地作用。它由两个线性变换和中间的 ReLU 组成,即公式 (2):
同一层里各位置共用参数,不同层的参数不同;论文说它也可以看成两个核大小为 1 的卷积。输入和输出是 维,中间层 维。按这个尺寸, 和 共有 个权重,约为一个注意力子层投影权重的两倍。标题说“只需要注意力”,可在编码器的每一层里,FFN 的权重是注意力的两倍;解码器多一个注意力子层,两者才大致持平。注意力负责在位置之间搬运信息,FFN 则在每个位置上单独加工。
嵌入与权重共享
第 3.4 节用学习得到的嵌入把输入 token 和输出 token 转成 维向量,用常规的线性变换加 softmax 把解码器输出变成下一个 token 的概率。论文在两个嵌入层和 softmax 前的线性变换之间共享同一个权重矩阵,并在嵌入层里把这些权重乘以 (约 22.6)。论文没有解释这一缩放的理由。
源语言和目标语言共用一张嵌入表,前提是两边用同一个词表。英德实验正是这样:第 5.1 节说明句子用字节对编码(BPE)切分,源语言和目标语言共享约 37000 个 token 的词表。分词与词表的一般做法见 Tokenization 与模型内部的文本表示。
正弦位置编码
模型里既没有循环也没有卷积,要利用词序,就得另外注入 token 的相对或绝对位置信息。第 3.5 节在编码器和解码器堆栈底部,把“位置编码”加到输入嵌入上。位置编码也是 维,所以两者可以直接相加。论文用的是不同频率的正弦和余弦:
是位置, 是维度编号。位置编码的每个维度都对应一条正弦曲线,偶数维用正弦、奇数维用余弦,同一对维度频率相同;波长从 到 成等比数列。拿位置 1 来说,最前面一对维度是 和 ;最后一对维度()的分母约为 9647,正弦值只有约 0.0001。靠前的维度随位置变化很快,靠后的维度变化很慢,合起来就能区分很多位置。
作者选这个函数,是因为他们推测模型能借此轻松学会按相对位置关注:对任意固定的偏移 , 都能写成 的线性函数。对单个频率 来说,这就是三角函数的和角公式:从 走到 ,只需乘一个只取决于 的 旋转矩阵。
论文也试过学习得到的位置嵌入,结果与正弦版本几乎相同(表 3 第 (E) 行)。最后选正弦版本,是因为它“可能”让模型外推到比训练时更长的序列。这是作者的预期,论文没有给出外推实验。
为什么用自注意力:读懂表 1
第 4 节把自注意力层和循环层、卷积层放在同一个任务里比较:把一个变长序列 映射为等长序列 ,其中 。比较三项指标:每层的总计算复杂度;能并行的计算量,用所需的最少顺序操作数衡量;以及网络中长程依赖之间的路径长度。前向和反向信号要走的路径越短,长程依赖就越容易学。
表 1 中, 是序列长度, 是表示维度, 是卷积核大小, 是受限自注意力的邻域大小:
先看后两列。自注意力层用常数次顺序操作就把所有位置连起来;循环层要 次,第 50 个位置必须等前 49 个状态依次算完,第 1 个词的信号也要经过 49 次状态更新才能到达第 50 个词。在自注意力里,同一层就能让这两个位置直接相连。
再看复杂度。当序列长度 小于表示维度 时,自注意力层比循环层快。作者指出,当时最好的翻译模型用词片(word-piece)或字节对表示句子,通常满足这个条件。代入 算一下: 时,,,自注意力少一个数量级; 时,前者变成 ,反而约是后者的 4 倍。表里的 说的是层内可以并行,并不代表自注意力便宜。对很长的序列,作者提出可以只关注以输出位置为中心、大小为 的邻域,代价是最大路径长度增到 ,并把这留作以后的工作。
卷积那一行需要一点解释。核宽 的单个卷积层连不通所有位置对:连续卷积核需要堆叠 层,扩张卷积需要 层,最长路径因此变长。卷积层一般比循环层贵 倍;可分离卷积把复杂度降到 ,但即使 ,它的复杂度也正好等于一个自注意力层加一个逐位置前馈层,也就是 Transformer 自己采用的组合。
作者还提到一个附带的好处:自注意力可能更好解释。附录的可视化里,不同的头似乎学会了不同的任务,有些行为看上去与句子的句法和语义结构有关,例如第 5 层的多个头把 “making” 和远处的 “more difficult” 连起来。注意力权重能证明多少东西,要另外检验,见注意力机制中“注意力权重能解释什么”一节。
训练配置
第 5 节交代训练细节。表 2 里的训练时间和成本,都是由这里的硬件与步数算出来的。
数据、硬件与时长
第 5.1 节:英德用标准的 WMT 2014 数据集,约 450 万个句对,BPE 共享词表约 37000 个 token。英法用大得多的 WMT 2014 英法数据集,3600 万个句子,词片词表 32000 个。句对按近似长度分批,每个批次约含 25000 个源 token 和 25000 个目标 token。
第 5.2 节:所有模型都在一台装有 8 块 NVIDIA P100 的机器上训练。基础模型每步约 0.4 秒,共训练 100,000 步,约 12 小时;大模型每步 1.0 秒,训练 300,000 步,约 3.5 天。
优化器与学习率预热
第 5.3 节用 Adam,参数为 、、。学习率按公式 (3) 随训练步数 变化, 是预热步数:
前 步学习率线性上升,之后按步数的平方根倒数下降。论文取 。代入 ,学习率在第 4000 步达到峰值 ,到第 100,000 步降到约 。
正则化
第 5.4 节写了残差 dropout 和标签平滑。残差 dropout 是指每个子层的输出在与输入相加、归一化之前先做 dropout;编码器和解码器里嵌入与位置编码之和也做 dropout。基础模型的比率 。标签平滑取 ,训练时把一部分目标概率从正确答案分给其他 token。论文的说法是,这会让困惑度变差,因为模型学得更“不确定”,但准确率和 BLEU 会提高。表 3 的 (D) 组可以看到这一点。
结果
机器翻译:表 2
第 6.1 节在 newstest2014 上报告 BLEU。表 2 的数字如下,训练成本单位是浮点运算次数(FLOPs),空格表示原表没有给出:
英德任务上,大模型比此前最好的结果(包括集成模型)高出 2.0 BLEU 以上,达到 28.4;基础模型也超过了此前所有已发表的模型和集成。英法任务上,大模型超过了此前所有单模型,训练成本不到此前最佳模型的四分之一。英法大模型用的 dropout 是 0.1,而不是大模型默认的 0.3。英法的分数有一处出入:摘要和表 2 写的是 41.8,第 6.1 节正文写的是 41.0。
成本这一列是估算,不是实测。论文用训练时间 × GPU 数量 × 每块 GPU 的持续单精度算力来估计,P100 取 9.5 TFLOPS。基础模型 12 小时、8 块 GPU,算出来约 ;大模型 3.5 天,约 ,与表中一致。原表中两个 Transformer 的成本只有一个数,横跨英德和英法两栏。
解码设置也在这一节:基础模型取最后 5 个检查点(每 10 分钟保存一次)的平均,大模型取最后 20 个;束搜索的束宽为 4,长度惩罚 ;最大输出长度设为输入长度加 50,能提前结束就提前结束。
模型变体:表 3
第 6.2 节在基础模型上逐项改动,评估都在英德开发集 newstest2013 上进行,使用束搜索但不做检查点平均。困惑度(PPL)按词片计算,不能和按词计算的困惑度比较。所以这里的基础模型 BLEU 是 25.8,与表 2 测试集上的 27.3 不能直接对比。表 3 中没写出的参数都与基础模型相同:
几组结果各说明一件事:
- (A) 头数:计算量保持不变,只改头数和每个头的维度。单头比最好的设置差 0.9 BLEU,头太多质量也会下降。
- (B) key 的维度:减小 会损害质量。作者据此推测,判断相容性并不容易,比点积更复杂的相容性函数也许有好处。
- (C) 规模:模型越大越好,符合预期。
- (D) 正则化:dropout 对避免过拟合很有帮助,去掉后 BLEU 掉到 24.6。去掉标签平滑后困惑度反而更低(4.67),BLEU 却从 25.8 降到 25.3,与 §5.4 的说法一致。
- (E) 位置编码:学习的位置嵌入与正弦编码的结果几乎相同。
英语成分句法分析:表 4
为了检验 Transformer 能否推广到翻译以外的任务,第 6.3 节做了英语成分句法分析。这个任务的输出受强结构约束,而且明显长于输入;此前 RNN 序列到序列模型在小数据条件下没能达到最好水平。
作者训练了一个 4 层、 的 Transformer。一种设置只用宾州树库的《华尔街日报》(WSJ)部分,约 4 万个训练句,词表 16K;另一种是半监督设置,加入约 1700 万句的高置信度语料和 BerkeleyParser 语料,词表 32K。他们只在第 22 节开发集上做了少量实验,选择 dropout(注意力和残差)、学习率和束宽,其余参数沿用英德基础翻译模型。推理时最大输出长度增加到输入长度加 300,两种设置都用束宽 21、。
表 4 报告 WSJ 第 23 节上的 F1:
论文的结论是,尽管没有针对任务调参,模型的结果好于此前除循环神经网络文法(RNNG,即 Dyer 等 2016)以外的所有模型。逐行看:只用 WSJ 时,91.3 低于 RNNG 的 91.7;半监督设置下 92.7 是同组最高;多任务(93.0)和生成式 RNNG(93.3)更高,但训练方式不同。与 RNN 序列到序列模型不同,Transformer 只用 4 万句 WSJ 训练时就超过了 BerkeleyParser(Petrov 等 2006,90.4)。
哪些留了下来,哪些变了
论文的核心计算基本原样留了下来:缩放点积注意力的公式、多头的拼接与输出投影、残差连接、逐位置前馈层,以及训练时所有位置并行计算的做法。变化主要发生在这些部件的组合方式上:
- 拓扑:许多大语言模型只保留解码器堆栈,没有编码器和交叉注意力。三种结构的可见范围与输出头见 Encoder、Decoder 与 Encoder–Decoder,逐个生成 token 的规则见自回归生成与解码。
- 归一化的位置:Xiong 等人(2020)分析了原论文的 Post-LN 结构:初始化时靠近输出层的参数梯度很大,学习率一大训练就不稳定,他们用这一点解释了为什么需要学习率预热;把层归一化移到残差分支内部(Pre-LN)后,去掉预热也能得到可比的结果。现代模型常用 Pre-Norm 和 RMSNorm,见 Transformer 笔记中关于 block 的部分。
- 位置信息:正弦编码之后出现了学习的绝对位置、相对位置偏置和 RoPE。RoPE 用旋转矩阵编码绝对位置,同时让自注意力的计算里显式带上相对位置。各方法作用在哪里,见 Transformer 笔记的位置编码对比表。
- 注意力头与缓存:逐 token 生成时,旧位置的 K/V 要缓存下来。多查询注意力(MQA)和分组查询注意力(GQA)让多个 query 头共享较少的 K/V 头,缩小缓存,见注意力变体与 KV 缓存压缩。
- FFN:ReLU 常换成 GELU,或 SwiGLU 这类门控结构,见激活函数与门控 FFN。
- 序列长度:表 1 里“ 小于 ”的前提在长上下文中不再成立, 项成了主要成本。FlashAttention 等内核降低了显存峰值,但精确注意力的计算量仍是平方级,形状与显存的具体估算见 Transformer 笔记。
作者在结论里写下了三项计划:把 Transformer 用到文本以外的输入输出模态;研究局部的受限注意力,以便高效处理图像、音频和视频这类大规模输入输出;让生成过程不那么依赖顺序。训练和评估代码当时发布在 tensor2tensor。