多模态模型:对齐、融合与视觉问答
多模态模型把文本、图像、音频或视频中的信息放进同一个任务,但“支持图片”并没有说明它能做什么。用一句话搜索照片,需要比较图文相似度;读取截图并回答问题,需要把视觉证据接入语言生成;生成图片又是另一种输出目标,见扩散模型。选模型之前,先明确输入、输出和需要保留的细节。
图像怎样进入序列模型
Vision Transformer(ViT)的一种基本做法是把图像分成固定大小的 patch,把每块像素展平后映射成向量,再处理这组向量。图像并不一定先被转成文字。
用一个刻意简化的例子:图像大小是 224×224,patch 大小是 16×16,则得到 个 patch。RGB patch 展平后有 个数,再经投影得到模型宽度为 的向量。忽略分类 token 后,视觉特征形状可写为 [batch,196,d_v]。这里的 768 来自像素数量,并不规定隐藏宽度必须是 768。
位置编码保留空间顺序,预处理则决定图像如何缩放、裁切、归一化。真实系统还可能使用多块高分辨率裁切、动态分辨率或压缩器,所以不能把“每张图 196 个 token”当作统一收费或显存估计。视觉 patch 也通常是连续向量,不要求对应文本词表中的某个整数 ID。
服务商按像素和时长计视觉 token
截至 2026-10-29,Anthropic 和 Google 都公开了算法。Claude 把图像切成 28×28 像素的块,每块算一个视觉 token,所以一张图要 个 token(Anthropic 视觉文档)。每个模型还有分辨率上限:Claude 4.7 及之后的模型长边 2,576 像素、最多 4,784 个视觉 token;其他模型长边 1,568 像素、最多 1,568 个。超过任一上限的图会先按比例缩小。
一张 1000×1000 的图在两档都是 1,296 个 token。一张 1920×1080 的截图在高分辨率档不缩小,算 2,691 个;在标准档先缩到 1456×819,算 1,560 个。文档也写明,同一张图在高分辨率模型上最多可能用到约三倍的视觉 token。
Gemini 的计数说明写的是:两边都不超过 384 像素的图算 258 个 token;更大的图切成 768×768 的块,每块 258 个。音频每秒 32 个 token,一分钟是 1,920 个。视频在同一页有两种写法:要点列表写每秒 263 个 token(静态处理);按处理模式列的表格写静态处理默认约每秒 100 个(低分辨率)或约 300 个(高分辨率),每秒采样 1 帧。估算视频时,用 countTokens 数实际文件。
所以发截图前先裁剪。只需要 1920×1080 截图里一个 600×400 的报错框时,裁剪后按 Claude 的公式是 个 token,约是整张截图在高分辨率档的八分之一。裁剪后的小图也低于两档上限,不会被缩小,框里的小字保持原来的清晰度。
对齐:让图文可以比较
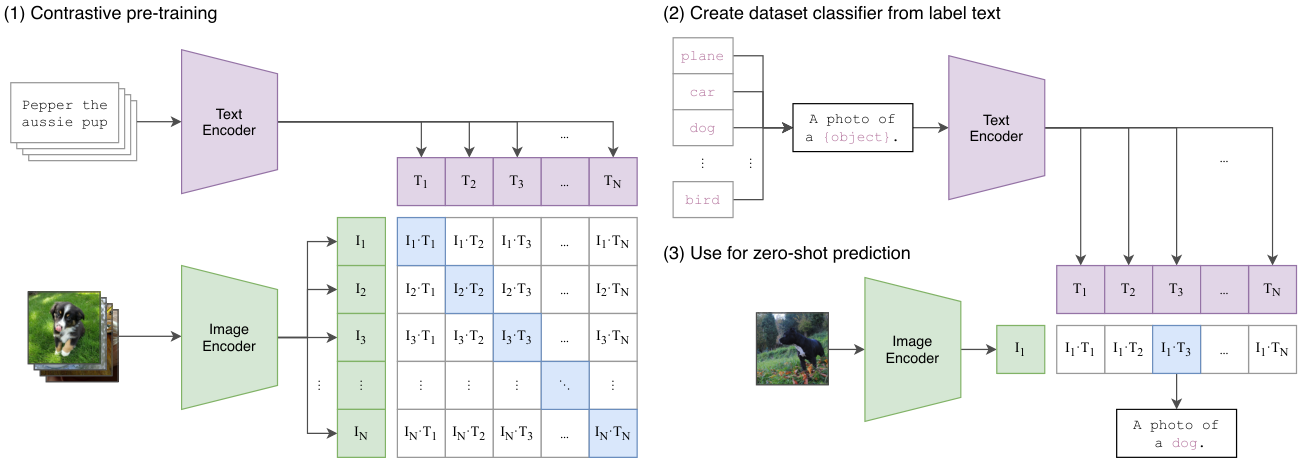
CLIP用图像编码器和文本编码器分别产生向量,通过成对图文的对比学习,让匹配对更相似。两边不需要先生成一段说明文字。这种设计适合图文检索和基于文本候选的比较。
假设一个教学批量包含三张图和三条正确配对的说明。分别得到 [3,d] 的归一化向量,矩阵乘法产生 [3,3] 的相似度表,正确配对位于对角线。训练希望每行和每列的正确配对得分更高。如果批量中另一个说明实际上也适合某张图,却被当作负例,就会产生训练噪声。
推理时可以比较一张图与“红色汽车”“蓝色汽车”“自行车”的文本向量。把分数 softmax 后,概率仍然依赖这组候选;删掉一个选项或增加相近描述,分布会变化。它不是开放世界里“图中确实有红车”的通用真实性概率。阈值需要在实际分布上评估。
 查看清晰大图
左侧是训练:两个编码器分别产生图像和文本向量,对角线上高亮的是原本配对的样本,训练要提高它们的相似度。右侧是预测:把类别名写成文字描述,再用图像向量逐一比较。最后选出的狗的描述来自候选标签,并不是模型自由生成的图片说明。
融合:把视觉证据接给语言模型
要回答“截图里第二行报错是什么”,只得到一个整图相似度通常不够。LLaVA 的原始设计连接预训练视觉编码器与语言模型,用可训练投影将视觉特征映射到语言模型的表示宽度,并通过视觉指令数据训练回答。
在简化形状里,视觉特征 [batch,N,d_v] 乘以连接矩阵 [d_v,d_l],变成语言模型的宽度 ;形状对上只是能计算,语言模型要经过训练才会用这些向量。其他模型用重采样器或 cross-attention 来连接。
生成回答这一步仍受解码与停止条件影响。
最容易丢掉的信息
图像缩小以后,小字可能已经消失,而服务商会自动缩小超过上限的图;裁切会去掉边缘;把大量视觉位置压成少量向量,可能牺牲细粒度关系。此时输出更长、更流畅,不能恢复不存在的输入证据。
“识别大致场景”也不等于“可靠计数、读取坐标、理解左右关系”。如果训练集中某类场景经常与某对象共现,模型可能依赖语言先验补出对象。处理表格截图时,正确读出几个单元格仍不足以证明行列对应正确。
视频则多一层时间采样问题:每隔几秒取一帧,可能遗漏很短的事件,也可能把先后顺序误判成静态共现。音频转成文字后,语调、重叠说话和非语音声音可能损失。需要这些信息的任务,应评估原始模态处理链,而不是只测转写文本的答案。
用成对变化检查是否依赖证据
可以构造一个公开、可控的小测试集:同一张简单图中只改变颜色、数量、左右位置或一段文字。问题保持不变,检查答案是否跟着目标变化;再遮住关键区域,看模型是否仍给出同样肯定的答案。这里描述的是实验设计,不是已测得的模型成绩。
把错误拆到具体环节:预处理删掉细节,视觉表示未保留信息,连接后未被语言模型使用,或解码输出错误。对 OCR 任务记录字符错误和布局关系;对计数记录绝对误差;对问答记录正确率及无证据时的表现。用同一分辨率、裁切规则、问题和输出预算比较模型,另记延迟与视觉 token 数。
做图文搜索时,先看对齐模型与检索流程;做截图问答时,评估可读取细节和证据依赖;做多模态 Agent 时,还要把动作验证与视觉判断分开。会描述一个按钮,不等于能稳定定位它或确认点击后的状态。