梯度的定义
对于采用欧氏坐标的可微二元函数 f(x,y),梯度 ∇f 定义为偏导数组成的向量:
∇f=(∂x∂f,∂y∂f)
以 f(x,y)=x2+y2 为例,其梯度为 ∇f=(2x,2y)。这个向量指向函数局部增长最快的方向,其模长即为该方向上的最大变化率。在常规点上,梯度垂直于经过该点的等值线,而非与等值线相切。
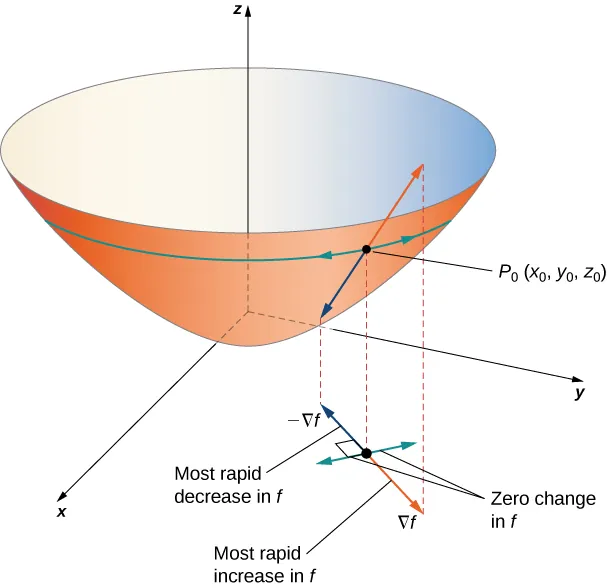 查看清晰大图
先看下方平面中的箭头:梯度位于输入坐标 (x, y) 中。橙色指向局部上升最快的方向,蓝色指向下降最快的方向,绿色沿等高线切向。上方曲面展示对应的高度变化;梯度本身不是贴在曲面上的三维箭头。
特定点处的梯度
计算 f(x,y)=x2+y2 在点 (2,3) 处的梯度,只需将坐标代入公式:
∇f=(2⋅2,2⋅3)=(4,6)
结果 (4,6) 表示从点 (2,3) 出发,函数值增长最快的方向向量。
负梯度为何能在局部下降
设 f 在内部点 q 可微,u 是欧氏范数下的单位向量。方向导数为
Duf(q)=t→0limtf(q+tu)−f(q)=∇f(q)Tu.
柯西–施瓦茨不等式给出 −∥∇f(q)∥2≤Duf(q)≤∥∇f(q)∥2。梯度非零时,u=−∇f(q)/∥∇f(q)∥2 取得下界。这是欧氏单位方向中的最陡下降方向,不能保证长步也下降,更不能忽略坐标尺度的影响。具体地,
f(q−α∇f(q))=f(q)−α∥∇f(q)∥22+o(α),
所以足够小的正步长能降低函数值。上例梯度为 (4,6),最陡单位方向是 (−2,−3)/13,变化率为 −213。沿常规等值线对不变的函数值求导,可得切向量 v 满足 ∇f(q)Tv=0。
Hessian 与方向曲率
对二阶连续可微函数,Hessian 矩阵收集所有二阶偏导数,Hij(q)=∂2f(q)/∂xi∂xj。混合偏导相等,因此矩阵对称。二阶局部展开为
f(q+v)=f(q)+∇f(q)Tv+21vTH(q)v+o(∥v∥22).
二次型 vTHv 描述沿位移方向的曲率。对实对称矩阵,若任意非零 v 都使它为正,矩阵就正定;若都非负,则为半正定。这分别等价于全部特征值为正或非负。不定矩阵则既有正曲率方向,也有负曲率方向。矩阵定义和二阶凸性判据见 Boyd 与 Vandenberghe 的附录 A 及第 3.1.4 节。
对 x2−y2,H=diag(2,−2),沿 x 轴曲率为正,沿 y 轴为负。实对称 2×2 矩阵正定,当且仅当 H11>0 且 detH>0;下文回归算例就用这个判据。Hessian 为零时无法据此分类:x4+y4、−x4−y4 和 x4−y4 在原点的 Hessian 都为零,却分别给出极小点、极大点和鞍点。凸优化中的全局保证,依赖 Hessian 在整个开凸域上半正定,而不是只在一个点半正定。
驻点的梯度为零;局部极小点优于附近可行点;全局最小点优于整个可行集中的点。这些概念不能混用:x2−y2 在原点有驻点,但它是鞍点;在 [0,1] 上最小化 x,最优解是边界点 0,导数却为 1。对二阶连续可微函数,驻点处 Hessian 正定可保证严格局部极小,不定则说明是鞍点;奇异的半正定 Hessian 还需进一步分析。
优化中的应用
可微函数在定义域内部的局部极值点处,导数必须为零,但反过来并不成立。对于 f(x)=x2,解 f′(x)=2x=0 得到候选点 x=0;还要利用 x2≥0,才能确认它是全局最小点。边界点和不可导点需要另外检查。
对于 f(x,y)=x2+y2 等多元函数,优化过程旨在寻找梯度为零的点,即 ∇f=0。这意味着所有偏导数 ∂x∂f 和 ∂y∂f 均为零。解方程组:
∂x∂f=2x∂y∂f=2y=0=0
得到最小值位置 (0,0)。这一方法可推广至任意维度的函数,但需注意:梯度为零仅标识出驻点候选。该点可能是极小值、极大值或鞍点,因此仍需二阶导数测试或其他论证来最终确认。
二维桑拿房中的优化
将桑拿房视为二维空间,允许在 5x5 的房间内任意移动,目标是根据温度分布找到最冷的点。
-
温度函数:给定位置 (x,y),温度由函数 T(x,y) 表示,在三维图中体现为高度。红色区域代表高温(高值),蓝色区域代表低温(低值)。
-
目标:在闭正方形 [0,5]2 上最小化 T(x,y)。全局最小点不一定在内部,也不要求其他每一点的温度都严格更高。
-
数学方法:计算偏导数 ∂x∂T 和 ∂y∂T,令其为零,并求解 x 和 y 以找到潜在的最小值点。
-
示例函数:T(x,y)=85−901x2(x−6)y2(y−6)。
-
偏导数:
∂x∂T=−901x(3x−12)y2(y−6)
∂y∂T=−901x2(x−6)y(3y−12)
-
寻找最小值:求解 ∂x∂T=0 和 ∂y∂T=0 只给出内部候选点,还需检查四条边及角点。下文的完整求解包含了边界。
桑拿房的定义域取 [0,5]2。令 h(t)=t2(6−t),则 T=85−h(x)h(y)/90。在 [0,5] 上,h≥0,且 h′(t)=3t(4−t):先增至 h(4)=32,再递减。因此唯一的全局最冷点是 (4,4),温度 T=3313/45≈73.6222。x=0 或 y=0 的边上温度为 85;坐标为 5 的边上最低温度是 85−25⋅32/90≈76.1111。这样才把边界也检查完,而不只是求驻点。
线性回归优化
线性回归是机器学习的基石模型,其优化过程同样依赖于多维微积分,核心在于为数据集寻找最佳拟合直线。
- 问题描述:已知若干电力线的坐标,任务是将它们连接到主干光纤线,并使总成本最小。在此示意模型中,成本与竖直残差的平方成正比,而非到直线的最短距离平方。
- 数学建模:光纤线方程为 y=mx+b,其中 m 为斜率,b 为截距。优化目标是最小化总成本函数 E(m,b),该函数依赖于 m 和 b。
- 成本函数:取示例数据 (1,2),(2,5),(3,3)。竖直残差平方和为 E(m,b)=(m+b−2)2+(2m+b−5)2+(3m+b−3)2,展开得 14m2+3b2+38+12mb−42m−20b。
- 偏导数与优化:
- ∂m∂E=28m+12b−42
- ∂b∂E=6b+12m−20
- 求解:令 ∂m∂E=0 和 ∂b∂E=0,解出 m 和 b 即可得到使成本最小的最优直线参数。
- 结果:最优值为 m=21 和 b=37,最小成本为 4.167。
回归二次式的 Hessian 为 (2812126),顺序主子式为 28 和 24,均为正,所以它正定。(1/2,7/3) 是唯一全局最小点,Emin=25/6≈4.1667。这里的距离平方指竖直残差 yi−(mxi+b) 的平方;若用到直线的垂直距离,其平方还要除以 1+m2,优化问题就不同了。统计建模部分见线性回归。
梯度下降:一种高效的优化方法
不便直接求解驻点方程时,可以用梯度下降迭代寻找候选解。它不保证比直接求解更快,函数值下降也不等于已经证明收敛或全局最优。上文从可微性说明局部下降的原因;单变量梯度下降给出了保护定义域的实现。