自动微分
PyTorch Autograd 深度解析 - YouTube 2.5 自动微分 —《动手学深度学习》
JAX 中的自动微分
JAX 是一个面向高性能数值计算和科学计算的库,充分利用现代硬件(如 GPU/TPU)的算力。它在 NumPy 的基础上扩展了自动微分(Autodiff)能力,能够高效计算梯度。梯度是优化问题和机器学习算法的核心,JAX 通过函数变换(Transformations)机制来实现这一目标。
自动微分(Autodiff)
自动微分沿程序的计算过程,把基本运算的求导规则用链式法则组合起来。它不必像符号微分那样构造化简后的公式,也不通过附近函数值的差分估计导数。它求的是所实现计算的导数,仍受浮点误差与可用求导规则限制。不连续点、整数决策、不支持的运算或不存在的导数,不会因为使用自动微分就变得可导。高阶导数需要足够的可微性,计算成本也可能很高。学习雅可比积前,可先复习导数和线性映射的矩阵形状。
前向与反向模式
对 ,雅可比矩阵 的元素为 ,形状是 。前向模式将输入方向 传播为 ;反向模式将输出权重 传播为 。以基向量为种子可得到单列或单行,但种子不限于某一个坐标方向。
转置来自多元链式法则,不是 JAX 特有的约定。设 , 是标量损失。每个输入都可能通过多个输出影响损失,因此
反向模式中的 就是 。求和也解释了为什么不同路径传回的贡献必须累加:这是把标量链式法则应用到所有中间坐标。
因此,完整雅可比矩阵大致需要 次前向传播或 次反向传播。前向模式适合输入少、输出多的情况;反向模式适合输入多、输出少的情况,尤其是标量损失。反向传播以反向模式为基础,但反向计算时需要保留或重算中间值。这是计算量与内存之间的权衡,不是普遍的速度排名。
微分图(Differentiation Graph)
微分图是函数计算过程的图形化表示。它记录了从输入到输出的所有运算步骤、中间变量及其依赖关系。
自动微分算法利用这张图来高效地应用链式法则:
- 在前向模式中,沿着图的方向传播导数。
- 在反向模式中,逆着图的方向累积梯度。
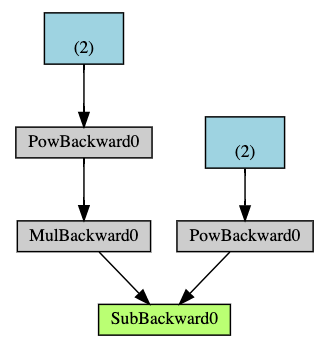 查看清晰大图
这张 PyTorch 官方图逐元素计算 Q = 3a³ − b²。向下看是前向计算,反向追踪则是梯度传播。PowBackward0 等标签是保存的反向函数名;“(2)”表示输入张量的形状。下方 JAX 代码计算另一个函数,但同样通过组合基本运算的求导规则得到结果。
JAX 如何实现 Autodiff
JAX 同时支持前向和反向模式,能够高效计算梯度(Gradient)、雅可比矩阵(Jacobian)和海森矩阵(Hessian)。主要接口如下:
-
jax.grad:- 计算函数的梯度。
- 底层使用反向模式。
- 适用于输入维度远大于输出维度的场景(如神经网络损失函数)。
-
jax.jvp(Jacobian-Vector Product):- 计算雅可比向量积。
- 这是前向模式的基本操作。
- 用于计算 ,其中 是雅可比矩阵, 是向量。
-
jax.vjp(Vector-Jacobian Product):- 计算向量雅可比积。
- 这是反向模式的基本操作。
- 用于计算 ,其中 是向量, 是雅可比矩阵。
使用示例
下面展示如何使用 JAX 计算函数的梯度:
import jax
import jax.numpy as jnp

def f(x):
    return jnp.sin(x) * jnp.cos(x)

# 获取 f 的梯度函数
grad_f = jax.grad(f)

# 计算 f 在 x = 1.0 处的梯度
print(grad_f(1.0))
上述代码计算了函数 在 处的导数。
手算一个共享输入的计算过程
令 、、。在 处,前向种子 给出 、,因此 ,即 。
反向模式从 开始。加法传回 ;乘法向 贡献 ,向 贡献 ;正弦再向 贡献 。同一输入收到的贡献必须相加,所以 。 通过两条路径影响输出,因此覆盖已有梯度会丢失一部分结果。
前面的 JAX 算例应得到 。jax.grad 要求标量输出(形状为 (),而非长度为一的向量),通常对浮点输入求导。向量输出则应按所需的积或矩阵选择 jax.jvp、jax.vjp、jax.jacfwd 或 jax.jacrev。对于 在零点这样的折点,实现采用的规则不能证明经典导数存在。