凸优化
找到一个比附近点更好的解,通常还不能断定它在所有可行解中最好。凸优化研究的是一类局部最优也能保证全局最优的问题。可以按以下顺序学习:
- 凸集与凸函数;
- 标准问题形式及其变换;
- 最优性条件;
- 拉格朗日对偶与约束最优性;
- 一阶与二阶求解方法;
- 在统计学与机器学习中的应用。
完整课程与证明可参考 Stanford EE364A 和 Boyd、Vandenberghe 的教材 《Convex Optimization》。
够用的基本概念
这张地图说明全局保证依赖哪些假设;对偶与算法的完整推导见 Boyd 与 Vandenberghe 教材第 2–5、9 章。
 查看清晰大图
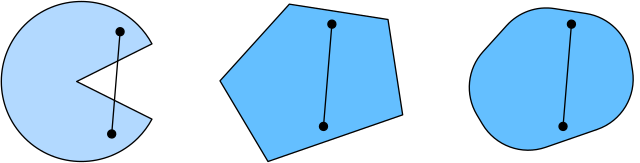
判断时要看整条线段。左图两个端点都在集合内,连线却穿过了缺口,这一个反例就足以说明它不是凸集。右侧两个集合中,任意两点的连线都留在集合内;只画出一条符合条件的线段,还不足以证明凸性。
若任意 、 都满足 ,即连接两点的线段不离开集合,就称 为凸集。定义在凸域上的函数若满足
就称为凸函数。图像位于弦的下方。若两点不同时,对 都是严格不等式,则函数严格凸;这保证最小点至多一个,不保证存在。例如 在 上严格凸,却只有下确界零,没有最小点。
可微凸函数满足支撑平面不等式:
因此无约束驻点就是全局最小点。更一般地,对凸集 中的可行点 ,一阶条件 对所有 成立,是最优性的充要条件。 在 上的最优解 满足它,尽管 。凸问题的每个局部极小点都是全局最小点:若存在更好的可行点,沿连接它的线段,任意靠近当前点的位置都能改善目标,与局部极小矛盾。
标准凸问题最小化凸目标,约束由凸不等式 和仿射等式 组成。仅目标凸、可行集非凸还不够。例如在 上最小化 ,孤立点 是局部极小点,却不是全局最小点。
收益率、分散投资与组合风险把这一形式用于只做多的均值—方差问题,并算出预期收益怎样改变最优权重。
对开凸域上的二阶连续可微函数,凸性等价于 Hessian 半正定。梯度与曲率说明从二阶偏导和二次型出发,定义了 Hessian 与正定性。最小二乘的 ;设计矩阵列满秩时正定,解唯一。凸性不能让任意梯度步长都收敛,仍需考虑光滑性和步长。
对偶用在哪里
拉格朗日函数为 ,其中 。取 得到原问题最小值的下界,再最大化这个下界就是对偶问题。原问题的可行目标值与对偶下界之差可以衡量最优性差距,迭代变化很小则不能。
Karush–Kuhn–Tucker 条件包括原问题可行、对偶可行、拉格朗日函数的驻点条件,以及互补松弛 。在可微凸问题中,满足这些条件足以保证全局最优。它们成为必要条件、对偶间隙为零,还需要适当的正则性条件,例如 Slater 条件:在定义域相对内部存在满足等式约束、且严格满足不等式约束的点。不能把这些保证无条件套到任意约束问题或神经网络上。