Différentiation automatique
PyTorch Autograd Explained - In-depth Tutorial - YouTube 2.5. Automatic Differentiation — Dive into Deep Learning documentation
Différentiation automatique avec JAX
JAX est une bibliothèque de calcul numérique et scientifique haute performance qui exploite le matériel moderne, notamment les GPU et les TPU. Elle étend NumPy avec la différentiation automatique et calcule efficacement les gradients par des transformations de fonctions. Ces gradients jouent un rôle central dans l’optimisation et les algorithmes d’apprentissage automatique.
Différentiation automatique (autodiff)
La différentiation automatique évalue les dérivées en composant les règles des opérations élémentaires du programme par la règle de la chaîne. Contrairement au calcul symbolique, elle n'a pas besoin de construire une formule simplifiée ; contrairement aux différences finies, elle n'estime pas la dérivée à partir de valeurs voisines. Elle dérive le calcul implémenté, avec les erreurs d'arrondi et les règles disponibles. Une discontinuité, une décision portant sur des entiers, une opération non prise en charge ou une dérivée inexistante ne deviennent pas dérivables grâce à l'autodiff. Les dérivées supérieures exigent une différentiabilité suffisante et peuvent coûter cher. Revoyez les dérivées et les dimensions des applications linéaires avant les produits jacobiens.
Autodiff en mode avant et inverse
Pour , le jacobien a pour coefficients et pour taille . Le mode avant propage une direction d'entrée vers . Le mode inverse propage des poids de sortie vers . Initialiser avec des vecteurs de base permet d’obtenir des colonnes ou des lignes individuelles ; aucun des deux modes n’impose une initialisation limitée à une seule coordonnée.
La transposée vient de la règle de chaîne multivariée, pas d’une convention propre à JAX. Soit et une perte scalaire . Chaque entrée peut agir sur la perte par chaque sortie, d’où
Le mode inverse prend donc . La somme explique aussi pourquoi les contributions de chemins distincts s’accumulent : la règle de chaîne scalaire s’applique à toutes les coordonnées intermédiaires.
Un jacobien complet demande donc environ parcours avant ou parcours inverses. Le mode avant convient à peu d'entrées et beaucoup de sorties ; le mode inverse à beaucoup d'entrées et peu de sorties, surtout une perte scalaire. Il fonde la rétropropagation, mais doit conserver ou recalculer les intermédiaires pour le parcours arrière. Ce sont des compromis entre travail et mémoire, pas un classement universel de vitesse.
Graphe de différentiation
Un graphe de différentiation est une représentation graphique du calcul d’une fonction. Il consigne toutes les opérations, de l’entrée à la sortie, ainsi que les variables intermédiaires et leurs dépendances.
La différentiation automatique utilise ce graphe pour appliquer la règle de la chaîne efficacement et précisément :
- En mode avant, les dérivées se propagent dans le sens du graphe.
- En mode inverse, les gradients s’accumulent en sens opposé.
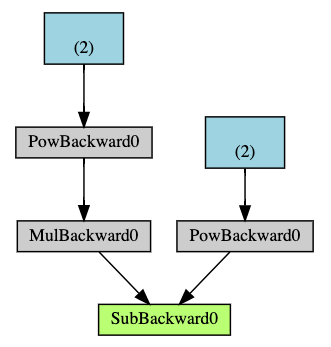 Voir l’image en grand
Cet exemple PyTorch calcule Q = 3a³ − b² élément par élément. Suivez le graphe vers le bas pour le calcul, vers le haut pour la propagation des gradients. PowBackward0 désigne une fonction de rétropropagation enregistrée ; « (2) » indique les dimensions du tenseur d’entrée. Le code JAX ci-dessous traite une autre fonction avec le même principe de composition des dérivées.
Comment JAX implémente l’autodiff
JAX prend en charge les modes avant et inverse pour calculer efficacement les gradients, les jacobiens et les hessiens. Ses principales interfaces sont :
-
jax.grad:- Calcule le gradient d’une fonction.
- Utilise le mode inverse.
- Convient aux cas où la dimension d’entrée dépasse largement celle de sortie, comme la perte scalaire d’un réseau de neurones.
-
jax.jvp(produit jacobien-vecteur) :- Calcule un produit jacobien-vecteur.
- Constitue l’opération élémentaire du mode avant.
- Calcule , où est le jacobien et un vecteur.
-
jax.vjp(produit vecteur-jacobien) :- Calcule un produit vecteur-jacobien.
- Constitue l’opération élémentaire du mode inverse.
- Calcule , où est un vecteur et le jacobien.
Exemple d’utilisation
Voici comment calculer avec JAX le gradient d’une fonction :
import jax
import jax.numpy as jnp

def f(x):
    return jnp.sin(x) * jnp.cos(x)

# Obtenir la fonction gradient de f
grad_f = jax.grad(f)

# Calculer le gradient de f en x = 1.0
print(grad_f(1.0))
Ce code calcule la dérivée de au point .
Suivre une entrée partagée
Posons , et . En , l’initialisation en mode avant donne et , donc . C'est .
En mode inverse, on initialise . L'addition transmet . La multiplication apporte à et à ; le sinus apporte à . Il faut additionner les contributions à une même entrée : . Les deux chemins passant par expliquent pourquoi écraser son gradient serait incorrect.
Dans l'exemple JAX précédent, la dérivée attendue est . jax.grad exige une sortie scalaire (forme (), pas un vecteur de longueur un) et dérive habituellement des entrées flottantes. Pour des sorties vectorielles, choisissez jax.jvp, jax.vjp, jax.jacfwd ou jax.jacrev selon le produit ou la matrice recherchés. En un point anguleux, comme zéro pour , la règle choisie par une implémentation ne prouve pas l'existence d'une dérivée classique.