注意力变体与 KV 缓存压缩
模型逐字生成时,每出一个新 token,都要回看此前所有 token 的 Key 和 Value;滑动窗口等注意力变体则只回看一段范围。把这些 Key 和 Value 存下来,就是 KV 缓存。缓存省掉了重复计算,代价是内存随序列长度和同时解码的序列数(Batch Size)线性增长:下文那个 32 层的例子里,一条 4096 个 token 的序列要 512 MiB 缓存,上下文拉到 128K(4096 的 32 倍),就是 16 GiB。
上下文很长、或者同时解码的序列很多时,每一步读缓存的流量会追上甚至超过读权重的流量;短上下文、单条序列时,每步读的主要还是权重。
省缓存有三条路:让多个 Query 头共用一组 Key/Value(减少 KV 头),把每个 token 存的东西压窄(压缩缓存宽度),或者少存几个 token、用更低精度存(减少缓存 Token 的数量或精度)。前两条要在训练时定下,第三条直接改现成模型的缓存。
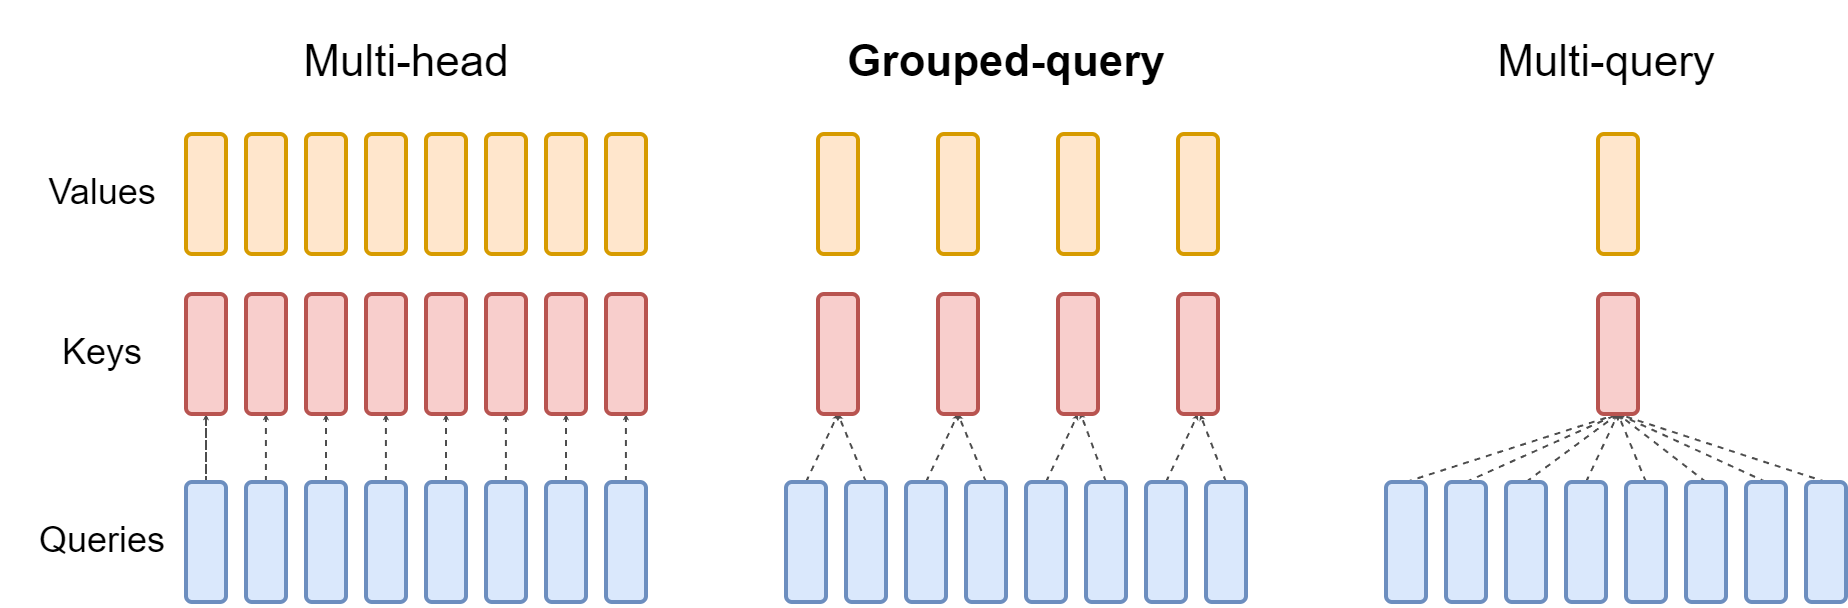 查看清晰大图
从底部蓝色查询头往上看:中间每两个查询头共享一组键值头,右侧所有查询头共享一组。查询头数量没有减少;其他维度不变时,缓存节省来自需要保存的键和值变少。
MHA 与 GQA
缓存有多大,取决于每层要为几个 KV 头存 Key 和 Value。假设模型有 层,序列长度 ,Query 头数 ,KV 头数 ,头维度 ,每个缓存元素占用 字节。三种注意力的区别只在 :
- 多头注意力 (MHA):通常 ,即每个 Query 头对应独立的 KV 头。
- 多查询注意力 (MQA):所有 Query 头共享同一个 KV 头。
- 分组查询注意力 (GQA):介于两者之间,多个 Query 头共享一个 KV 头。
忽略分配器和元数据开销,单条序列的 KV 缓存大小约为:
用白话说:每层、每个 token,要为每个 KV 头存一条 维的 Key 和一条 维的 Value,系数 2 就对应 Key 和 Value 这两部分;再乘上层数、token 数和每个数的字节数。
举一个假设配置:、、、、,每个元素两字节。按上面的顺序一步步算:
换成 MHA,32 个 Query 头各配一个 KV 头, 从 8 变成 32,缓存变成 4 倍,需 2 GiB。也就是说,其他参数不变时,从 MHA 切换到 GQA,缓存按 的比例下降,这里是 ,只剩四分之一。缓存还随并发数线性增长:四条等长的 GQA 序列同样需要 2 GiB,尚未计额外开销。这些数只算缓存,模型权重另占一份内存。
GQA 是训练阶段的架构选择,不是可以无损套用到任意权重的开关。GQA 论文给出的改法是:把现成多头模型的键值头分组合并,再用原预训练约 5% 的算力继续训练。这样改出的 GQA 模型,质量接近多头注意力,速度接近 MQA。
每生成一个 token,每一层的每个 K/V 头都要多存一个 key 和一个 value。先选 query 头如何共享 K/V 头,再逐步看解码过程。
32 个 query 头 → 8 个 K/V 头
第 12 个 token解码第 12 个 token:先追加一行(所有层合计 128 KiB),新 query 再读取全部 12 行:这条序列读 1.5 MiB。
一行 = 2(K 和 V)× 32 层 × 8 个 K/V 头 × 128 × 2 B = 128 KiB
放到真实的上下文长度
- KV 缓存
- 512 MiB
- 4,096 × 1 × 128 KiB
- 每个解码步读取
- 512 MiB
- 每条序列、每生成一个 token
- 相对 MHA
- 25%
- 8 / 32 个 K/V 头
1 条并发序列时,GQA 的缓存从 122,071 个 token 的上下文起超过这些权重(14.9 GiB)。
模型形状取自本文的假设算例:32 层、32 个 query 头、头维度 128。80 亿参数的权重线是假设的规模。未计入分配器开销和激活值。
什么条件下可以精确复用?
缓存能原样复用,前提是新 token 到来时,旧 token 的 Key 和 Value 不变。因果模型满足这一点:追加 token 不会改变前面 token 的表示,每层只需为新位置计算。所以开头相同的两次请求可以共用这段缓存,运行时里的前缀缓存就是这么来的。分词后的前缀、权重(含适配器)和位置编号只要有一处不同,或者改动了前面某个 token,从那里往后的缓存就全部作废。
树形推测解码把状态管理扩展到候选分支:需要隔离各分支,并沿接受路径保留一致的 KV 与压缩状态。
多头潜在注意力 (MLA)
GQA 靠少存几组头省缓存;DeepSeek-V2 引入的多头潜在注意力 (MLA) 换了个办法:不再缓存完整的每头 Key/Value 张量,而是让模型学一个低维的潜在表示(Latent Representation),每个 token 只存这个短向量,用时再投影出各头的 Key 和 Value。由于旋转位置编码(RoPE)依赖位置信息,无法简单折叠进固定投影,因此用于 RoPE 的 Key 部分保持独立,单独存一小段。
简化的缓存宽度对比如下:
其中 为压缩后的潜在宽度, 为解耦的旋转 Key 宽度。换句话说,MHA/GQA 每层每 token 存的数随 KV 头数增长,MLA 只存一个潜在向量加一段位置 Key,存多少和头数无关。
代入 DeepSeek-V2 论文给的配置:60 层,128 个注意力头,每头 128 维,潜在宽度 ,旋转 Key 宽度 。下表按每个数 2 字节换算:
MLA 每 token 存的数约为同形状 MHA 的五十七分之一()。576 甚至少于上一节那个 8 个 KV 头的 GQA 每层要存的 2,048 个数;论文的说法是,MLA 的缓存只相当于 2.25 组的 GQA()。
MLA 和 GQA 一样要在训练时定下:压缩和还原用的投影是训练出来的,论文报告的效果属于按这种架构训练的模型。
跑模型时能调的是长度、精度和前缀缓存
注意力结构是训练时定下的,跑模型的人改不了。能改的是公式里另外两个数:缓存保留多少个 token(),每个数占几个字节();还有一项是相同的开头要不要再算一遍。
拿上面那个 GQA 例子算:每个 token 128 KiB,32K 上下文就是 4 GiB;换成 q8_0 约 2 GiB,q4_0 约 1 GiB。整台机器的预算怎样分给权重和缓存,见单卡部署。
现有缓存的压缩策略
还有一类研究方法不改训练好的架构,直接删缓存里的 token。SnapKV 用提示末尾一个观察窗口的注意力给前面的位置打分,只留高分的 Key/Value。PyramidKV 按各层注意力分布的差异,给不同层分不同的缓存预算。它们省下的内存来自少存 token,代价是可能删掉小而关键的片段。
关键测量指标
针对具体部署,需记录以下数据:
- 确切模型、注意力架构及缓存数据类型;
- Prompt 长度、生成长度及并发序列数;
- GPU 峰值内存及主机内存占用;
- Prefill 时间、首 Token 延迟 (TTFT) 及解码吞吐量;
- 需要跨位置获取信息的长上下文任务成功率;
- 缓存剔除、量化或卸载至 CPU 后的行为表现。
内存适配性和答案质量保留情况要分别测试:宣称支持长上下文的模型在现有硬件上可能装不下,而节省缓存的方法虽然能装进内存,却可能让任务失败。