模型量化:精度、体积与速度
量化用更少的比特近似模型中的数值。它最直接的收益是减少存储和传输的数据量;是否更快、损失多少任务质量,还取决于模型、量化方法、算子和硬件。先有显存预算,再讨论把哪部分压小,比只看文件名里的“4-bit”更有用。
从一个数到一组低比特整数
以对称均匀量化为例,选择缩放系数 s,把权重 w 转成有限范围的整数 q = round(w / s),解码时近似为 s × q。超出整数范围的值会被截断。非对称量化还会引入零点,使整数区间对应偏离零中心的实数区间。
下面用四个虚构权重演示对称 4-bit 的一个简化约定:使用 -7 到 7,保留一个编码不用。真实格式可以使用不同布局。
weights = [-1.0, -0.2, 0.3, 1.0]
scale = max(abs(w) for w in weights) / 7
quantized = [max(-7, min(7, round(w / scale))) for w in weights]
restored = [round(q * scale, 3) for q in quantized]
print(quantized)  # [-7, -1, 2, 7]
print(restored)   # [-1.0, -0.143, 0.286, 1.0]
这次近似改变了中间两个权重。如果一整层共用缩放系数,一个很大的离群值会让普通小权重可用的精度变粗。按通道或按较小分组设置缩放系数,可以贴近各组数值范围,却需要额外元数据,也会改变内核实现成本。
“4-bit 模型”没有说完哪些数被压缩
Transformers 的量化概览列出多种方法及后端支持。比较时至少分清以下对象:
权重是 4-bit 时,激活和缓存仍可能是 16-bit;计算也可能先局部反量化再使用浮点算子。W4A16 表示权重 4-bit、激活 16-bit,不表示整个进程每个数都是 4-bit。文件容器、量化算法和执行内核同样是不同层:能下载一个格式,不代表所选运行时和设备能高效执行它。
容量算例要把边界写清
假设一个虚构稠密模型恰有 80 亿个权重。只算裸权重,16-bit 为 8 × 10^9 × 2 = 16 GB,4-bit 为 8 × 10^9 × 0.5 = 4 GB。这里用十进制 GB;换成 GiB 会得到不同数字。
实际文件还包含缩放系数、零点、未量化张量与元数据。运行内存另外需要 KV 缓存、临时缓冲、运行时和并发请求空间。因此“4 GB 权重”不能推出“4 GB 显存足够跑任意上下文”。对于混合专家模型,也要区分每 token 激活多少参数与常驻或调入多少权重;少量激活参数不会自动减少全部模型的存储。
PTQ、QAT 与校准数据
训练后量化(PTQ)在已有权重上做近似;量化感知训练(QAT)让训练过程考虑量化影响。简单四舍五入可以作为理解起点,但成熟方法会利用权重和激活分布减少关键误差。GPTQ使用近似二阶信息进行训练后权重量化;AWQ利用激活统计识别并保护重要权重通道。
这里的校准数据用于观察量化范围或近似误差,与概率校准中拟合输出概率的含义不同。代码、长上下文、多语任务的激活分布可能不同。使用不具代表性的校准文本,会使一个总体基准看似良好的格式在目标任务上退步。
LoRA 是参数高效适配,蒸馏是让学生学习教师行为,都不等同于数值量化;可以组合使用,具体训练关系见迁移学习、LoRA 与蒸馏。
 查看清晰大图
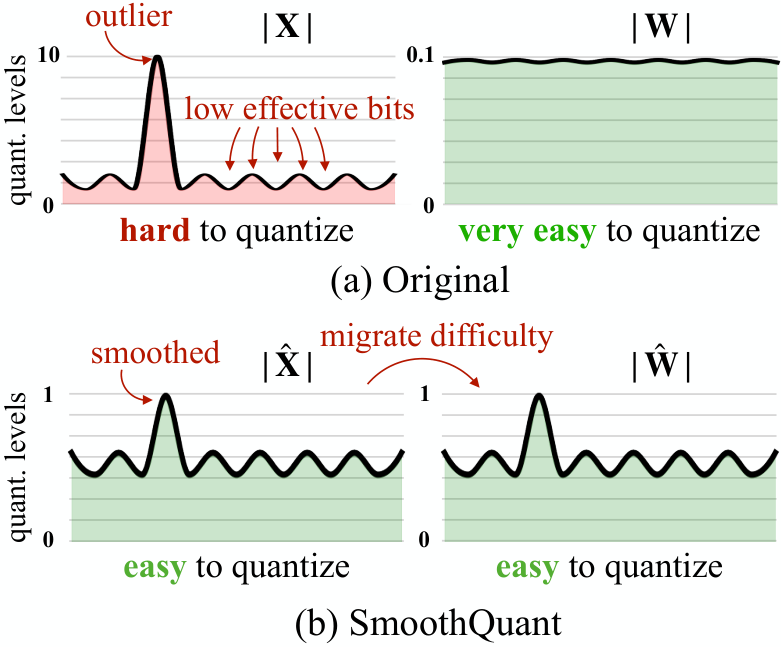
上图的激活异常值撑大量化范围,让大多数数值只能分到少数几个量化等级。SmoothQuant 按通道缩放激活,并在权重中做补偿,保持量化前的乘积不变,同时重新分配量化难度。读图时要同时看纵轴刻度与曲线形状。这里展示权重与激活共同量化的思路,与上文只量化权重的 AWQ 不同。
为何更小不一定更快
如果瓶颈在读取权重,减少数据搬运可能有利;如果低比特内核不适配硬件、反量化开销大,或者算子走了慢速回退路径,收益就可能消失。长提示词的 prefill、逐 token 的 decode、不同批量大小也有不同瓶颈,不能用一个速度数字概括。
比较两个量化版本时,固定原始模型、运行时、硬件、提示词与输出预算,记录峰值内存、首字延迟、生成速度,以及目标任务的正确率和失败样例。尤其检查长文本、稀有术语、结构化输出和工具参数,不要只比较困惑度或几句聊天。若较低精度导致频繁重试,单次推理节省可能被端到端成本抵消。测量口径见推理性能。