概率校准、决策阈值与弃权
一个模型连续十次给出 0.99,不能据此判断它可靠。先要知道这个数在预测什么事件,再看大量同类预测中事件实际发生的比例。分类准确、概率校准和是否应该执行动作,是相互关联但不同的三个问题。
概率需要一个明确事件
假设虚构的分类器预测“这条客服消息需要人工处理”,输出 p = 0.8。良好校准意味着:在与部署环境相近的数据里,那些被赋予约 0.8 概率的消息中,约 80% 确实需要人工处理。它没有保证当前这条消息一定正确,也不是说模型理解了 80% 的内容。scikit-learn 的校准文档用这种分组频率说明概率含义。
多分类中,最高类别概率经常被称作 confidence;另一些系统用分布熵、候选间差距或单独的头输出 confidence。必须先看定义。一个把所有概率集中到错误选项上的模型,也能有很高的“信心”。Jev 与 Laya的选择概率需要放回各自接口与目标任务理解,不能仅凭字段名赋予统一含义。
 查看清晰大图
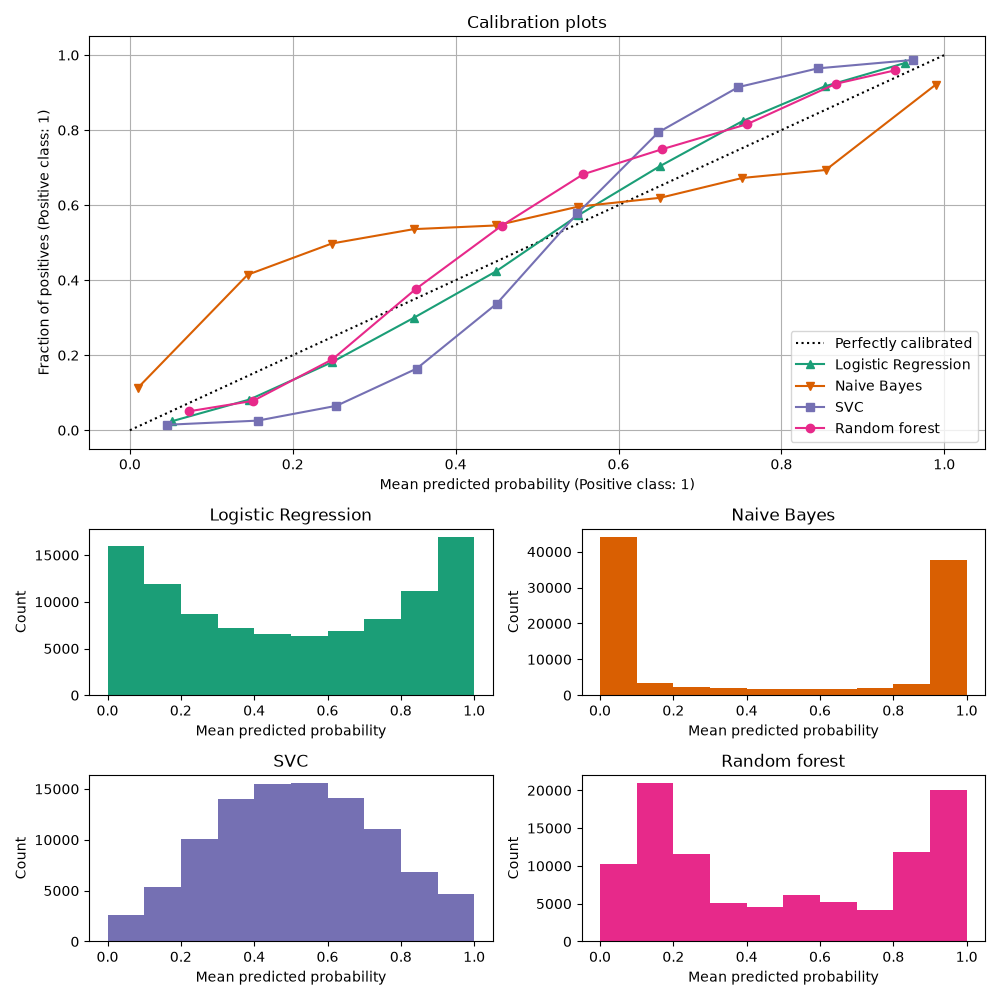
上图的对角线对应完美校准。固定预测概率后,曲线落在对角线下方,表示实际正例比例低于预测值。下方各图说明预测集中在哪些概率区间。这是一个示例数据集上的结果,不是分类器的普遍排名。
准确率高也可能过度自信
考虑 100 个独立标注的例子:模型每次都给所选类别 0.9 的概率,最终只对了 70 次。准确率是 70%,而预测信心平均为 90%。如果把所有信心调整为 0.7,所选类别可以完全不变,准确率仍是 70%,但这一组的频率对应关系改善了。
反过来,一个永远输出数据集正例比例的模型,可能在整体上校准,却不会区分个体。因而既要看排序与分类能力,也要看概率是否符合频率。Guo 等人的研究讨论了神经网络的过度自信,并研究用温度缩放校准输出。
对 logits 使用正温度 T,把 softmax(z) 改为 softmax(z / T)。同一个正温度保留各类别的大小顺序,却改变分布的尖锐程度。温度要在校准数据上拟合,不是凭感觉把“太自信”统一调低。该方法也无法修复候选缺失、标签错误或模型根本没有学会的任务。
数据必须分工
训练集用于学习模型;校准集用于拟合概率映射;验证数据可用于选择阈值和弃权策略;最后的测试集只评估已经确定的整套方案。数据少时可以交叉验证,但仍需保证用来评价某个预测的标签没有参与生成该预测的拟合或选择过程。
同一客户的近重复消息、同一文档切出的段落,不能随机散入各集合后当作独立样本。对未来时间的部署问题,应考虑按时间划分;如果部署时正例比例变化,即使排序能力不变,原有概率与阈值也可能失效。
可靠性图把预测分箱,对比平均概率与真实频率,并同时显示每箱样本数。ECE 将分箱差异汇总,但会随分箱方案和样本数量变化。Brier score 与对数损失评价整套概率预测,不能单独证明校准改善。下面的虚构二分类例子只计算 Brier score:
probabilities = [0.9, 0.8, 0.7, 0.1]
labels = [1, 1, 0, 0]
brier = sum((p - y) ** 2 for p, y in zip(probabilities, labels)) / len(labels)
print(round(brier, 4))  # 0.1375
第三条过度肯定的错误贡献了 0.49,占四条总平方误差的大部分。这个小例子说明损失如何计算,不足以估计真实系统的校准。
阈值来自后果,不来自默认的 0.5
设执行一个动作却不该执行的损失为 9,漏掉本应执行的动作损失为 1,其余正确情况损失为 0。若 p 是“应该执行”的可信概率,则执行的期望损失为 9(1-p),不执行为 p。前者更小时才执行,得到阈值 p > 0.9。
这是简化的二元成本模型。若延迟、人工审查或多个动作也有成本,应把它们一起纳入比较。概率决定预期结果,成本决定愿意承担什么后果,权限决定动作是否允许;三者不能互相替代。
弃权后要同时报告覆盖率
可以让系统在信息不足时交给人工或继续检索。例如只自动处理超过阈值的请求。但报告“自动处理准确率 99%”时,还应报告自动覆盖了多少请求。覆盖 1% 的简单请求与覆盖 90% 的请求,系统价值不同。
逐步提高阈值,画出覆盖率与已接受请求错误率的关系,还要分别看语言、长度和任务类型。高 confidence 的分布外错误仍可能通过阈值;弃权规则不能替代输入范围判断。部署后若样本分布改变,需重新收集有代表性的标注,再评价整套决策策略,而不只是机械提高阈值。