混合专家 MoE:稀疏计算、路由与部署成本
混合专家(Mixture of Experts,MoE)让模型保存多组参数,但只为每个输入激活其中一部分。在常见的稀疏 Transformer 中,被替换的是某些层的 FFN:一个路由器为每个 token 选择少数几个专家,专家计算后再合并输出。这样可以增加总参数容量,而不同比例增加每个 token 的 FFN 计算。
这与让多个聊天 Agent 开会不同。这里的专家通常是同一神经网络中的子网络,由共同的训练目标学习;名称中的“专家”也不保证它们分别掌握数学、法律或编程。阅读前可先了解激活函数与门控 FFN。
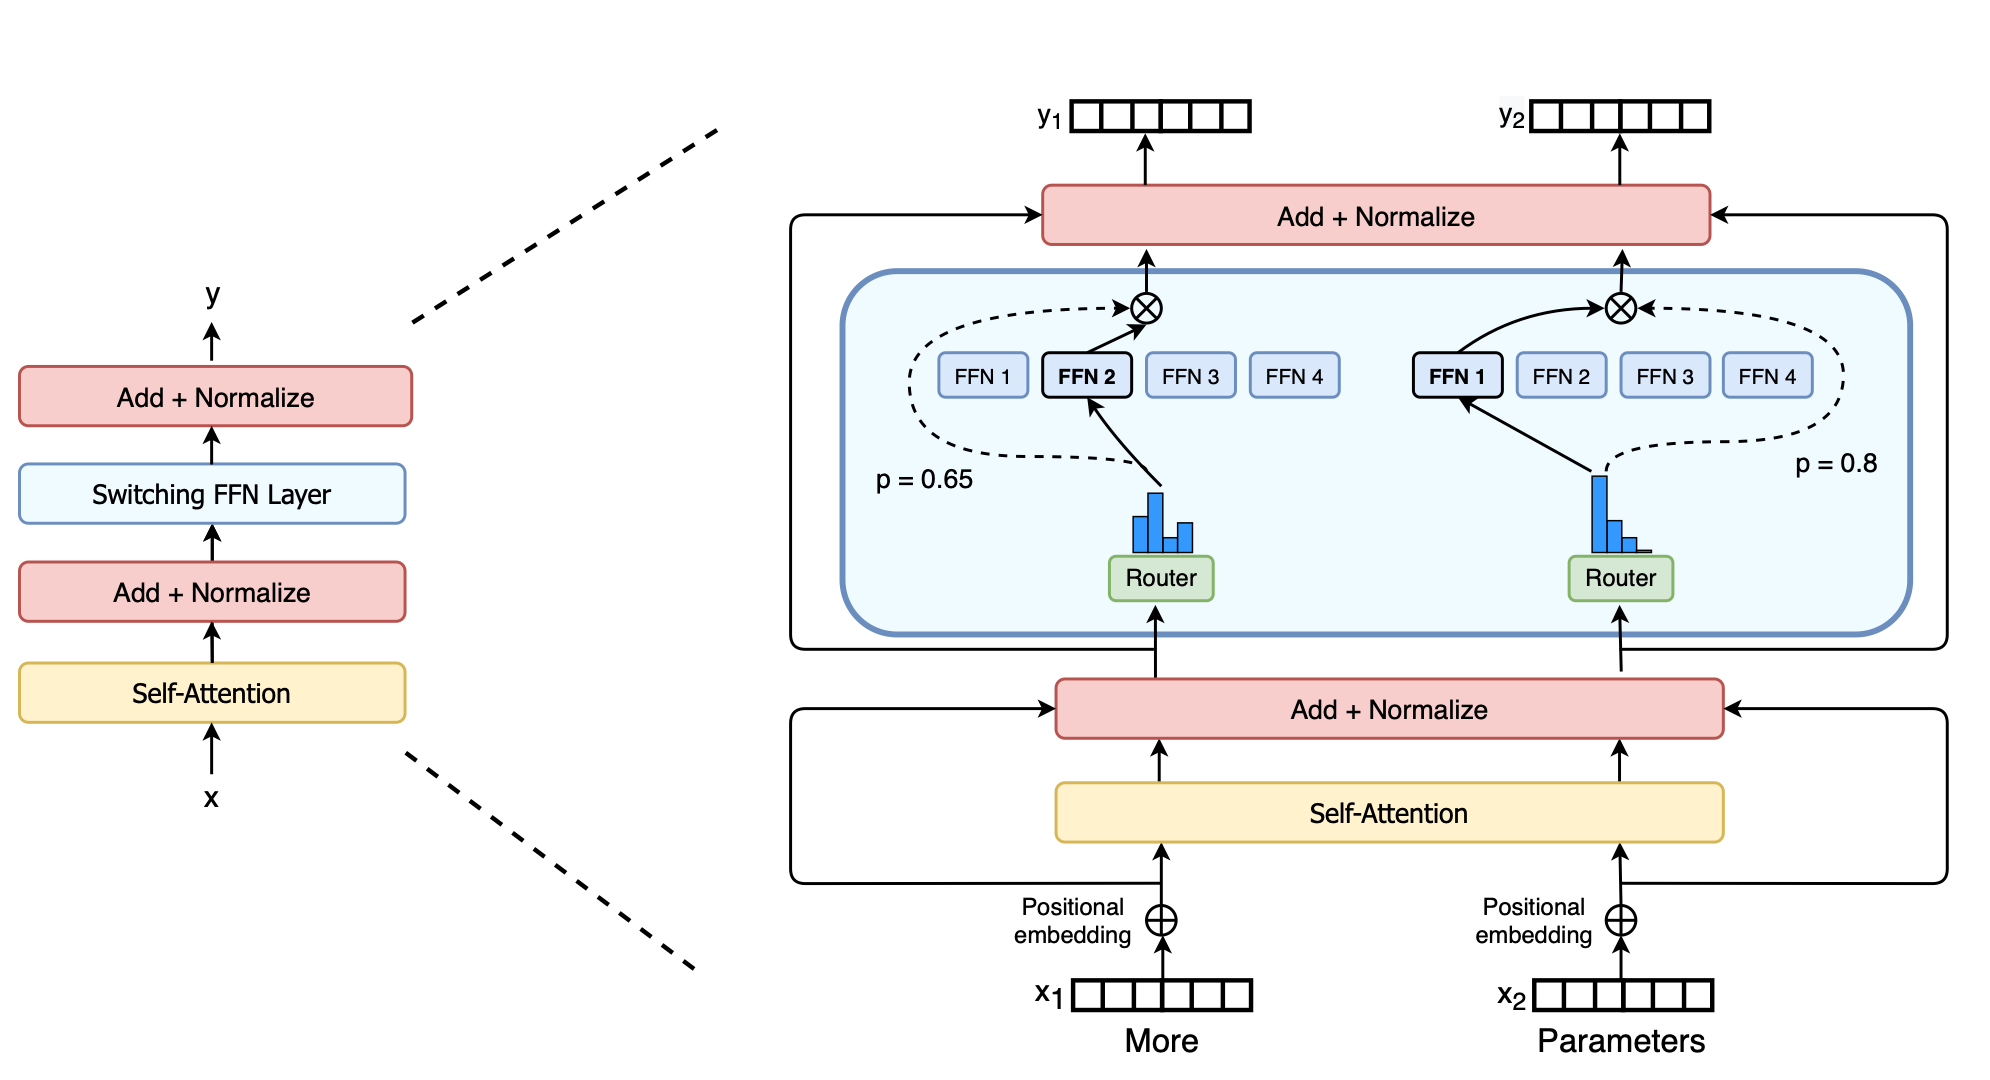 查看清晰大图
右侧展开的蓝色块展示两个 token 的路径:路由器各选一个 FFN,再用门控值缩放该专家的输出。这是 Switch 的 top-1 路由;下文一般形式中的 top-k 可以让同一个 token 激活多个专家。
一个 token 怎样经过 MoE 层
经典稀疏门控 MoE 论文用可训练门控选择部分专家。用一种简化的 token-choice top-k 形式表示:
是宽度为 的 token 表示,路由矩阵 为 [d,E],E 是专家数量; 表示第 i 个专家网络, 是对应权重。不同实现对路由分数、归一化、共享专家和偏置的处理不同,这个公式只展示“选择—计算—合并”的基本路径。
以四个专家、每次选两个为例,假设路由概率是 [0.50,0.30,0.15,0.05]。若采用对入选专家重新归一化的约定,前两个权重变成 0.625 和 0.375。再假设两个专家分别输出 [2,0] 与 [0,4],混合结果就是 [1.25,1.50]。这些数字是教学算例,不是某个模型的实际路由。
每个 token 可以选择不同专家,而且同一个 token 在不同层可以走不同路径。其前后通常仍有共享的注意力、归一化和残差。路由选择的是网络内部计算,不是直接选择一个用户可读答案。
参数多,不代表每步全部计算
Switch Transformer展示了每个 token 选择一个专家的设计;Mixtral报告了每层从八个专家中选择两个的实例。它们说明 k 和专家总数是架构选择,不应把某个模型的比例当成 MoE 定义。
构造一个只计算该层 FFN 的例子:假设每个专家有 10M 参数,共八个,top-2 路由。专家部分总共存有 80M 参数,而一个 token 使用其中两组,涉及约 20M。模型其他共享参数必须另算;批量里的不同 token 可能合起来用到全部八组。
即使一次只计算两个专家,其他专家也得保存在某处。全部常驻显存会占用总权重空间;放到 CPU 或磁盘可减少显存需求,却引入搬运延迟。KV Cache 主要由注意力结构、序列长度和批量决定,不能把专家数量直接乘进或除出缓存公式。
路由为什么需要负载管理
如果大部分 token 都选择同一个专家,其他专家闲置,热门专家拥塞,训练也可能越发偏向已有优势的专家。负载均衡的目标是避免算力和学习机会过度集中,而不是要求每个专家得到完全相同的任务。
Switch 的一种实现给每个专家设置容量。假设一批 100 个 token、四个专家、top-1、容量因子 1.2,则按论文形式,每个专家约有 个槽位。若分配为 [55,20,15,10],第一个专家多出 25 个 token;总槽位虽然有 120,闲置槽位也不能自动消除该专家的拥塞。Switch 中溢出的 token 跳过该层专家计算,经残差继续;论文的容量与均衡部分说明了这一实现。其他实现可以采用不同调度或不丢 token,不能据此断言所有 MoE 都会丢弃溢出计算。
辅助均衡损失会鼓励更均匀的分配,但系数过强也可能干扰任务目标。路由稳定性、数值精度和分布变化都值得检查:训练时均匀不代表生产长文本或某一种语言仍然均匀。
多卡通信可能吃掉算术收益
专家并行把不同专家放到不同设备。token 需要发送到被选中的专家,再把输出送回合并。这类数据交换常涉及 all-to-all;成本取决于互连、token 数量、批量形状与调度。减少 FFN 运算并没有消除传输。
单条低批量请求中,专家矩阵乘法可能太小,硬件利用率不足;大批量可增加每个专家的工作量,却也增加路由、缓冲和通信负担。两个激活参数相近的模型,若总权重、注意力结构或实现不同,延迟仍可能相差很大。部署判断需要结合量化和推理性能。
怎样读 MoE 的性能结果
先记录总参数、每 token 激活参数、专家数、top-k 和是否含共享专家,再记录硬件、权重精度、并行方式、输入长度、输出长度和并发。速度至少分开看首 token 延迟、后续生成速度与总体吞吐;任务质量必须使用同一测试集。
如果能获取路由统计,再观察每层专家负载、溢出或重路由比例、通信耗时和不同输入类别的变化。某些专家常接收代码 token,是可观察的路由偏好;要把它称为“代码专家”,还需要受控干预或消融证明其作用,不能只凭名字或几条示例。
MoE 提供的是容量与计算之间的一种设计空间。是否适合本地部署,要同时满足总权重存储、专家计算支持、缓存预算和真实任务延迟;只看到“激活参数很小”还不足以判断机器能否顺畅运行。