推理性能:加载、首字延迟、解码与吞吐
“每秒生成多少 token”只能描述推理体验的一部分。一个系统可能生成很快,却在读取长提示词、排队或加载模型时让用户等很久。比较运行时之前,先固定问题:是一个人在本机交互,还是多人同时请求;关心第一句话出现,还是整批任务尽快完成。
一次请求有几段时间
模型未驻留时,先经历文件读取、内存分配、设备传输及可能的编译或内核准备。收到文本后还要进行 tokenization。Prefill 处理已有的输入 token 并构建后续生成需要的状态;decode 在普通自回归生成中依次追加输出 token。服务端排队、网络与客户端缓冲还会增加用户感受到的等待。
vLLM 的服务基准接口分别提供首 token、每输出 token、token 间隔和端到端延迟等口径,并支持百分位数。使用其他工具也应明确相同的起止点,尤其注明是否包含客户端排队。
一个时间线算例
假设请求在 0 秒发出,0.8 秒收到首 token,2.8 秒收到第 101 个也是最后一个 token。忽略额外收尾时,TTFT 为 0.8 秒,首 token 后的平均间隔是 (2.8 - 0.8) / (101 - 1) = 0.02 秒,相当于这段 decode 每秒 50 token。若把输出数除以整个请求时间,则约为 36.1 token/s。这两个数字各有定义,不能混着比较。
这个例子是人为时间线,没有代表任何设备实测。真实流式接口可能把多个 token 放在一个数据块里;按数据块计数会高估或低估速度。应使用模型 tokenizer 对完整输出计数,或采用服务端可靠的 token 用量,并保留测量口径。
为什么批处理会改变结果
把多个请求合在一起,可以提高权重读取和计算资源的利用率,却也可能让单个请求等待组批。连续批处理允许完成的请求离开、新请求加入,不必让所有序列等到最长序列结束。即便总吞吐提升,每位用户的 token 间隔也可能变长。
并发还会增加 KV 缓存需求。PagedAttention 论文针对动态变化的缓存使用分页式管理,减少碎片和重复,从而支持更有效的服务调度。它改善的是特定内存管理问题,并不会消除权重、缓存容量或算力上限。
长提示词与短输出任务主要关心输入处理和 TTFT;短提示词与长输出任务更能暴露 decode 成本。小批量 decode 经常受权重搬运限制,较大 prefill 更可能充分利用矩阵计算,但具体瓶颈仍要结合设备和内核测量。降精度、增加批量与缩短上下文各自改变不同成本,不能互相替代。
 查看清晰大图
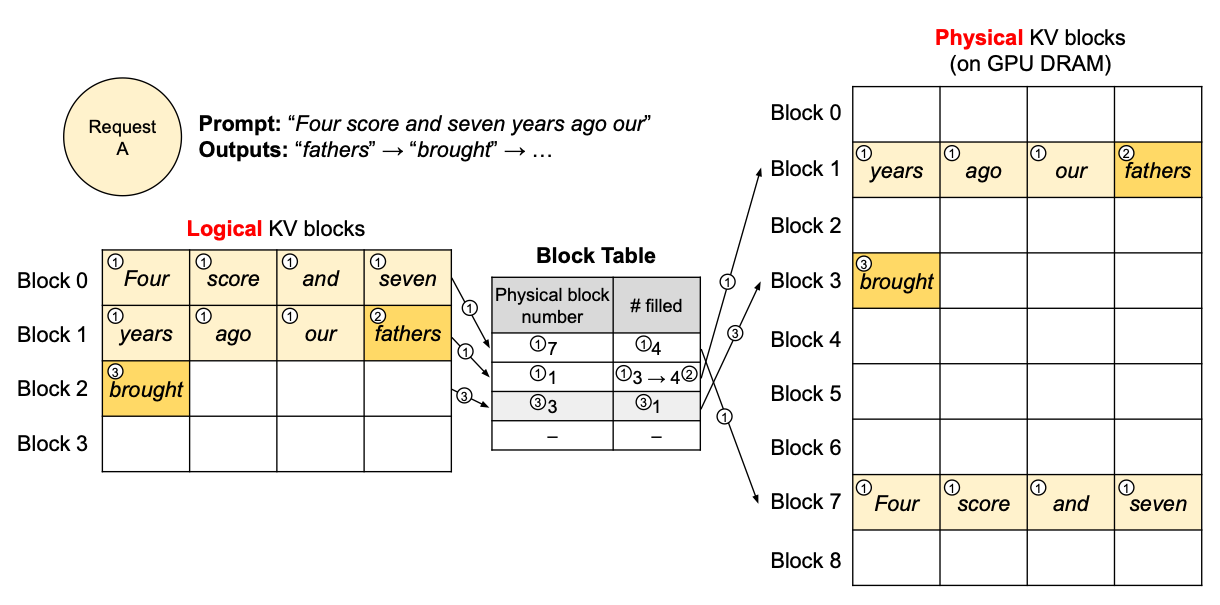
顺着中间块表看:逻辑块 0、1、2 分别对应物理块 7、1、3。token 的逻辑顺序保持不变,缓存却可以分散存放;末块填满后,再申请新块。图中每块四个 token 是示例设置。分页改善的是内存分配,并没有压缩每个 token 的 KV 向量。
缓存命中需要单独报告
模型驻留、内核预热和前缀缓存是不同的“热”。模型已经载入,不代表本次提示词有缓存;重复完全相同的系统提示又可能让第二次明显更快。对比运行时应分别测试冷启动、驻留但无前缀命中、预期业务下有前缀命中的情况。
缓存只能在相应输入和模型配置一致时复用。把每次请求都变成同一个提示词,会测出理想重复访问速度,无法代表不断变化的真实任务。修改模型、适配器或上下文后,也要避免把旧缓存当作有效证据。
测量要保留失败与尾部等待
先固定模型版本、量化、设备、运行时、输入长度分布、输出上限和并发。使用目标任务中的短长请求组合,预热与正式测量分开;记录中位数与高百分位延迟,并保留超时、失败、实际输出长度和峰值内存。只保留成功且很短的输出会让系统显得更快。
负载继续增加时,排队可能迅速增长。若客户端总要等上一个请求完成才发下一个,会自动降低施压速度,掩盖过载。因此需要根据目标场景选择固定并发或固定到达速率,并写清选择。少量请求的 p99 不稳定,应连同样本数理解。
最后把推理速度放回任务:回答是否正确、工具调用能否完成、是否需要重试。高 token/s 不能抵消错误工作造成的总耗时。具体运行时的兼容性见运行时选型,本地任务成败的评价见模型与 Agent 评测。