Quantification des modèles : précision numérique, taille et vitesse
La quantification approxime des valeurs numériques avec moins de bits. Son gain direct est de réduire les données à stocker et à déplacer. Vitesse et qualité dépendent du modèle, de la méthode, des noyaux de calcul et du matériel. Partir d'un budget mémoire, puis identifier les éléments à comprimer, est plus utile que le seul libellé « 4-bit ».
Approximer un groupe de valeurs
Dans une quantification uniforme symétrique, on choisit une échelle s, on encode le poids par q = round(w / s) dans un intervalle entier fini, puis on le reconstruit par s × q. Les valeurs hors plage sont écrêtées. La variante asymétrique ajoute un point zéro pour représenter une plage non centrée sur zéro.
Cet exemple fictif utilise une convention symétrique simplifiée sur 4 bits, de -7 à 7, avec un code inutilisé. Les formats réels peuvent différer.
weights = [-1.0, -0.2, 0.3, 1.0]
scale = max(abs(w) for w in weights) / 7
quantized = [max(-7, min(7, round(w / scale))) for w in weights]
restored = [round(q * scale, 3) for q in quantized]
print(quantized)  # [-7, -1, 2, 7]
print(restored)   # [-1.0, -0.143, 0.286, 1.0]
Les deux poids centraux changent. Une seule échelle pour toute une couche peut laisser une valeur extrême réduire la précision des petits poids ordinaires. Des échelles par canal ou par petit groupe épousent mieux les plages locales, mais ajoutent des métadonnées et modifient le coût des noyaux.
Quelles valeurs sont quantifiées ?
La présentation de Transformers détaille méthodes et compatibilités. Il faut distinguer trois objets :
Des poids sur 4 bits peuvent coexister avec des activations et un cache sur 16 bits. Le calcul peut déquantifier localement les poids avant une opération flottante. W4A16 signifie poids sur 4 bits et activations sur 16 bits, pas que tout le processus utilise quatre bits. Conteneur de fichier, algorithme et noyau d'exécution sont également distincts : télécharger un format ne garantit pas son efficacité sur le moteur et le matériel choisis.
Estimer la capacité avec ses frais annexes
Un modèle dense fictif de exactement 8 milliards de poids demande 8 × 10^9 × 2 = 16 GB pour ses poids bruts sur 16 bits, et 8 × 10^9 × 0.5 = 4 GB sur 4 bits. Il s'agit ici de GB décimaux, pas de GiB.
Le fichier contient aussi échelles, points zéro, tenseurs non quantifiés et métadonnées. L'exécution ajoute cache KV, tampons temporaires, moteur et requêtes simultanées. Quatre gigaoctets de poids ne garantissent donc pas une exécution dans quatre gigaoctets de VRAM avec n'importe quel contexte. Pour un mélange d'experts, distinguer paramètres activés par token et poids stockés ou chargés : l'activation parcimonieuse ne supprime pas le stockage du modèle complet.
PTQ, QAT et données de calibration
La quantification après entraînement, ou PTQ, approxime des poids existants. L'entraînement conscient de la quantification, ou QAT, tient compte de ses effets durant l'apprentissage. L'arrondi explique le principe ; des méthodes plus élaborées réduisent les erreurs importantes grâce aux distributions de poids et d'activations. GPTQ emploie une approximation du second ordre ; AWQ utilise les statistiques d'activation pour protéger les canaux de poids importants.
La calibration estime ici plages ou erreurs d'approximation ; elle diffère de la calibration des probabilités. Code, longs contextes et langues peuvent produire des distributions différentes. Un texte de calibration peu représentatif peut donner de bons résultats généraux tout en pénalisant la tâche visée.
LoRA adapte un petit ensemble de paramètres ; la distillation transmet le comportement d'un enseignant à un élève. Ces techniques ne sont pas une quantification numérique, même si elles se combinent. Voir transfert, LoRA et distillation.
 Voir l’image en grand
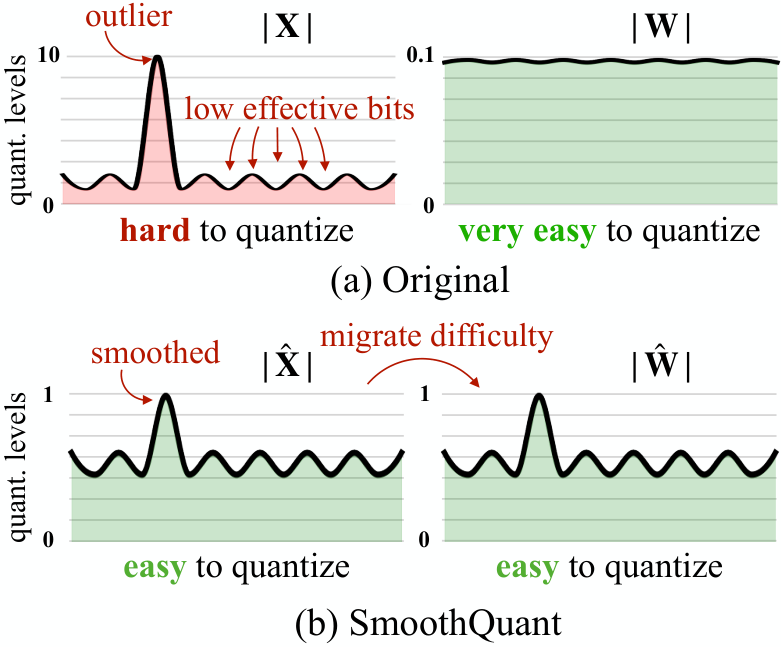
En haut, une activation extrême laisse peu de niveaux aux autres valeurs. SmoothQuant redimensionne les canaux d’activation et compense dans les poids, préservant le produit avant quantification tout en répartissant la difficulté. Comparez aussi les échelles verticales. Cette approche quantifie poids et activations, contrairement à AWQ présenté plus haut.
Plus petit ne signifie pas toujours plus rapide
Moins de trafic mémoire peut aider lorsqu'il constitue le goulot d'étranglement. Des noyaux incompatibles, la déquantification ou des opérations de repli lentes peuvent annuler le gain. Préremplissage d'un long prompt, décodage token par token et tailles de lot différentes ont des contraintes différentes.
Comparer les formats à modèle initial, moteur, matériel, prompts et budget de sortie constants. Mesurer pic mémoire, délai du premier token, débit de génération, exactitude et échecs concrets. Inclure longs textes, termes rares, sorties structurées et arguments d'outils, plutôt que seulement perplexité ou conversation. Des tentatives répétées dues à une précision trop basse peuvent absorber l'économie par inférence. La performance d'inférence précise les frontières de mesure.