Embedding、Reranker 与分类器:相似、相关和决策
“本地跑一个 BERT”还没有说明它能做什么。同一个编码器家族可以接上不同输出层,按不同训练目标学习。得到一个向量、给问题和文档打分、在几个动作中做选择,是三种不同的接口。部署位置不会改变这个区别。
先看模型接收什么、交付什么
Sentence-BERT用训练过的句子表示支持相似度比较。关键不在于原始 BERT 是否能产生隐藏状态,而在于这些表示是否经过训练,让距离适合目标任务。直接平均任意模型的 token 向量,并不能自动获得优秀的检索模型。
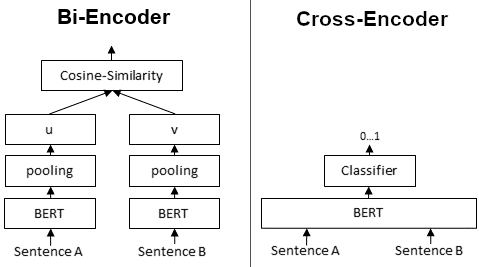
双编码器分别处理问题和文档,因此库中文档不需要随每个新问题重新前向计算。交叉编码器一起处理问题与候选,让二者的 token 在同一次计算中相互影响;检索后重排示例说明了这种成本分工。具体分数可能是 logit,也可能经过 sigmoid 等变换;名字叫“score”不表示数值已校准成真实概率。
 查看清晰大图
沿箭头从下往上看:左边先分别得到两个可复用的向量,再计算余弦相似度;右边把句子对一起送入 BERT,更换候选就要重新计算这一对。这解释了为什么检索可以预先索引文档向量,而重排通常只处理召回后的少量候选。图中的 0–1 输出来自所画的评分头,并不代表概率已经校准。
一个问题可以需要三者共同参与
假设正在给一个虚构的资料助手设计流程。用户问“如何离线识别会议录音?”向量搜索先找出与语音、离线推理相关的 50 篇笔记;重排模型把明确说明设备要求和离线限制的 5 篇提到前面;最后分类器根据任务状态决定“直接回答”“继续检索”或“需要澄清”。这些数量只用来说明候选范围逐步缩小。
三个阶段的标签不同:embedding 学习相似关系,reranker 学习问题与片段的相关性,动作分类器学习什么时候该做什么。一个笔记可能与问题高度相关,却因为版本过期不应被用作依据;一个动作可能容易预测,却因为没有权限不能执行。相关性评分不能替代版本判断,动作概率不能替代工具授权。
相似度为何不能直接当概率
下面只演示单位向量点积,不加载模型;向量是人为构造的。
from math import sqrt

def unit(v):
    length = sqrt(sum(x * x for x in v))
    return [x / length for x in v]

query = unit([1, 1, 0])
documents = [[1, 0, 0], [0, 1, 0], [0, 0, 1]]
scores = [sum(a * b for a, b in zip(query, unit(d)))
          for d in documents]
print([round(s, 3) for s in scores])  # [0.707, 0.707, 0.0]
前两个文档同分,只说明在这套表示下夹角相同。它们可以一个给出正确步骤,另一个只提到相似话题。0.707 没有“回答正确率 70.7%”的含义。若强行对三个分数做 softmax,加入十个无关候选也会改变归一化后的数值;文档本身并没有因此改变。
若要据分数决定是否自动执行动作,需要在目标任务上建立标签、测量错误成本,并检查概率校准。排序好、分类准确和概率可信是可以分别变化的性质。
固定标签与候选决策还有一层区别
传统固定标签分类器常把一个隐藏表示映射到预先确定的标签集合。例如“账单/技术/其他”三个输出维度,在训练期间已有明确含义。增加第四类通常要重新训练或适配输出层。
另一类模型把候选描述作为输入,在本次给出的选项中评分。它能接收新选项,不代表能理解任意新任务。候选措辞、相似选项、否定问句和“没有正确选项”都会影响行为。Jev 与 Laya讨论的正是这种结构化决策能力及其边界。选择数量可以变化,也不等于适合直接给数百个工具全量打分;先召回再选择往往更容易测清错误来自哪一层。
怎样公平比较本地模型
比较时先固定用途。做检索就用带相关文档标注的问题,比较召回与排序;做动作选择就用带允许动作和结果的任务状态,比较错误动作、弃权率及延迟。不要拿 embedding 的向量生成速度与需要逐对评分的 reranker 延迟直接排名。
同样要固定语言、输入长度、候选数、硬件、精度、批量和冷热启动条件。模型下载体积小,不保证长文本或大量候选时仍然快。先找清接口,再读检索流程和推理性能,就能把“本地 BERT”拆成可比较的具体任务。
在 Embedding Projector 中选一个内置数据集,点选样本、查看邻居,再切换投影方法。用它区分向量空间中的邻近关系和二维、三维画面的布局;附近的标签可以帮助理解表示,但不是校准后的相关性分数。