Regrouper les données
groupby partitionne les lignes selon une ou plusieurs clés, applique une opération à chaque partition,
puis combine les résultats. Décidez d'abord de la forme de sortie voulue.
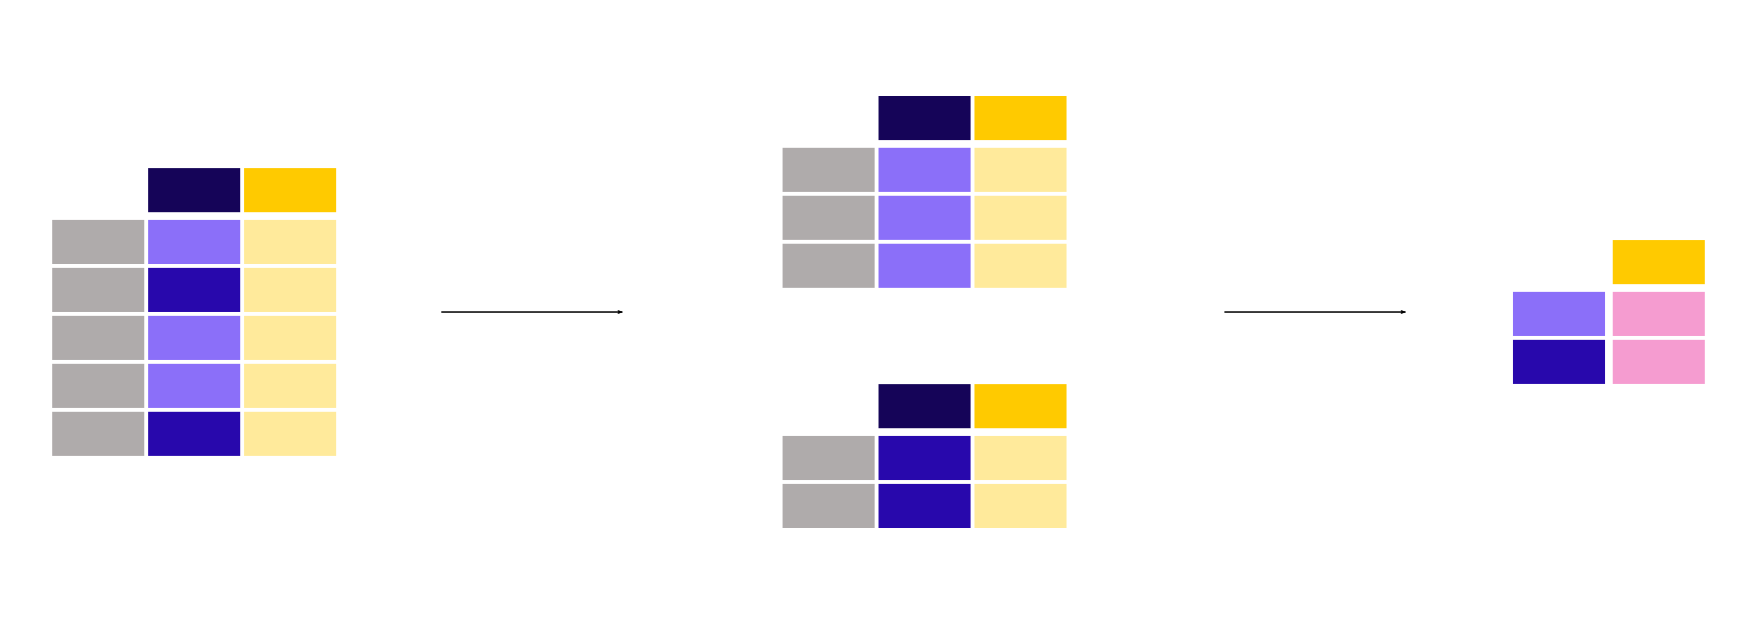 Voir l’image en grand
Lisez de gauche à droite : la colonne de regroupement répartit les lignes en deux groupes, puis les valeurs sont résumées dans chaque groupe. Le tableau final contient une ligne par groupe. C’est la forme d’une agrégation ; transform restitue au contraire des valeurs alignées sur les lignes d’origine.
Choisir selon la forme
import pandas as pd

sales = pd.DataFrame({
    "region": ["east", "east", "west", None], "product": ["A", "A", "B", "A"],
    "amount": [10.0, 30.0, 0.0, 5.0], "order_id": [1, 2, 3, 4],
})
summary = (
    sales.groupby(["region", "product"], as_index=False, dropna=False, observed=True)
         .agg(revenue=("amount", "sum"), orders=("order_id", "nunique"))
)

totals = sales.groupby("region", dropna=False, observed=True)["amount"].transform("sum")
sales["region_share"] = sales["amount"].div(totals.where(totals.ne(0)))
Une agrégation nommée indique à la fois la colonne source et le nom de sortie. Les opérations de groupe intégrées sont généralement plus claires et rapides que les fonctions de rappel Python.
Décisions essentielles
dropna=Trueexclut par défaut les clés de groupe manquantes ; choisissez explicitement si l'absence forme un groupe significatif.observeddétermine si les catégories inutilisées apparaissent lorsque les clés de regroupement sont catégorielles ; précisez-le si la forme doit rester stable entre versions.sort=Falsepeut éviter un tri inutile lorsque l'ordre des groupes n'importe pas.as_index=Falseconserve les clés comme colonnes, ce qui simplifie souvent la suite.
Sortie MultiIndex
Un regroupement sur plusieurs clés peut produire un MultiIndex. Conservez-le si la sélection hiérarchique
est utile ; sinon, revenez à une table plate avec as_index=False ou reset_index().
Limite de apply
Réservez GroupBy.apply aux algorithmes réellement structurés par groupe qui ne peuvent être exprimés
par agrégation, transformation, filtrage, fenêtrage ou jointure. Ne modifiez pas l'objet groupe dans la fonction
et testez explicitement le comportement de l'index.
Ramener les totaux aux lignes
Ici, summary comporte trois lignes : east/A donne un revenu de 40 et deux commandes distinctes ; west/B donne 0 et une commande ; le groupe région manquante/A donne 5 et une commande. transform("sum") rediffuse les totaux [40, 40, 0, 5] sur les lignes avec leur index initial. Les parts valent [0.25, 0.75, NaN, 1.0] : le groupe de total nul n’a pas de part définie.
Dans l’API de regroupement, size compte les lignes, count les valeurs présentes par colonne sélectionnée, et nunique les valeurs distinctes non manquantes par défaut. Ces questions diffèrent. Une somme ignore les valeurs manquantes et peut donner zéro pour un groupe entièrement manquant ; utilisez sum(min_count=1) pour conserver l’inconnu. filter(lambda g: len(g) >= 2) garderait les deux lignes east, sans les résumer.