机器学习中的对数损失
机器学习的核心往往归结为优化问题:最小化或最大化某个目标函数,即损失函数。其中,平方损失(Square Loss)和对数损失(Log Loss)最为常见。本文通过一个抛硬币的概率模型,拆解对数损失的数学本质,解释为什么我们要用对数来优化似然函数。
抛硬币场景的数学推导
场景设定
假设抛掷一枚硬币 10 次,目标是恰好出现 7 次正面(Heads)和 3 次反面(Tails)。现有三枚硬币,它们正面朝上的概率 各不相同(反面概率为 )。我们需要判断哪枚硬币最有可能达成这一特定结果。
概率计算
对于某一个固定顺序的序列(例如:正正正正正正反反反正),其概率为:
如果只关心正面出现的总次数,而不关心具体顺序,则需考虑所有可能的排列组合,概率为:
由于二项式系数 是常数,与 无关,因此上述两个表达式在同一个 值处取得最大值。在正面概率分别为 0.7、0.5 和 0.3 的三枚硬币中, 的硬币给出的概率最大。
基于微积分的优化
目标函数构建
为了推广这一结论,我们将正面概率 视为变量。目标是找到使似然函数(Likelihood Function)最大化的 值:
求导求解
最大化 的标准做法是对其关于 求导,令导数为零,解出 :
解此方程可得 为最优解,这与前面的直观分析一致。
对数变换与简化
对数的计算优势
直接对乘积形式 求导虽然可行,但处理起来较为繁琐。引入对数尺度 后,利用对数性质将乘积转化为求和,能显著简化求导过程。
推导过程
定义 为 的对数:
对 求导并令其为零:
解得最优概率仍为 。
对数损失在机器学习中的应用
在机器学习的分类任务中,对数损失(Log Loss)定义为 的相反数:
这个损失评价预测概率,而非分类正确率。训练通过最小化它来拟合概率。
为什么对数损失要使用对数?
计算简化
-
求和 vs 求积: 对求和式求导远比对乘积式求导简单。随着因子数量增加,乘积法则(Product Rule)的复杂度会急剧上升。取对数将乘积转化为求和,使得求导变得容易。
-
避免数值下溢: 多个概率值(均小于 1)相乘,结果可能极小,导致浮点数计算不稳定(下溢)。直接累加各个概率的对数,就不必先计算可能下溢的乘积。
数学公式对比
-
无对数时的复杂导数:项数越多,乘积求导越困难。
-
有对数时的简单导数:对数求导将问题分解为独立项的导数之和。
结语
对数损失是评估机器学习分类模型的关键函数。抛硬币例子说明对数能简化推导;数值是否稳定仍取决于具体计算方式,尤其要注意概率端点。
从似然到可用的二分类损失
假设各次抛掷独立,且服从同一个参数为 的伯努利分布。观察到七次正面、三次反面后,同一公式就是未知参数 的似然,而不是“ 为真”的概率。在 上,自然对数严格递增,所以保留最大点。负对数似然 满足
两端的损失都趋于无穷大,因此 是唯一全局最小点,损失约为 ,每次抛掷平均约为 。若观测全是正面, 上的最优解就变为边界 ;只找内部导数为零的点会漏掉它。
对标签 和可以各不相同的预测概率 ,二元交叉熵为
当 时,预测 和 在阈值 下都判对,但损失分别约为 和 。对数损失衡量概率质量,不是硬分类的正确比例。自信地预测错误概率 时,损失达到 。
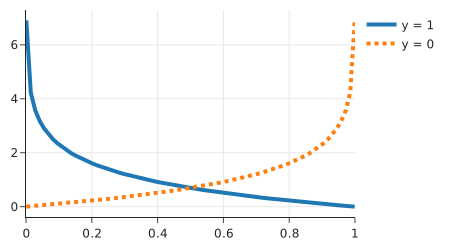 查看清晰大图
横轴是预测为类别 1 的概率 p,纵轴是用自然对数计算的损失。真实标签为 1 时看实线,为 0 时看虚线。越靠近自信但错误的概率端点,损失越大且没有上界;硬分类的对错计数却只记一次错误。
端点约定 来自极限,不能直接照搬为浮点乘法。给实际发生的类别赋零概率,会产生无穷损失。应直接累加对数;概率乘积已经下溢后再取对数,无法恢复信息。对严格位于 内的概率,log1p(-p) 能在 接近零时准确计算 。截断概率可避免无穷值,但会改变目标函数。
对二元标签和有限 logit ,可用代数等价的稳定形式:
Python 写法是 max(z, 0.0) - y*z + log1p(exp(-abs(z)))。当 时,它给出约 ,不会溢出。因此,对数要配合适当实现才能改善数值稳定性;随意取对数,或用 减去已经舍入的 sigmoid 概率,都不自动安全。逻辑单元的推导说明了 logit 梯度为何简化为 。