树模型、随机森林与梯度提升
线性模型用固定系数把各特征的贡献相加;决策树则把输入空间不断分区,沿着阈值判断走到叶节点,再使用叶节点的预测。这种结构容易表达条件规则,例如“只有请求带附件时,长度才是重要判断依据”。
scikit-learn 的树模型文档介绍了贪心分裂和不受约束的树容易过拟合的问题。贪心意味着每一步选眼前改善最大的分裂,并不穷举所有可能的后续树。
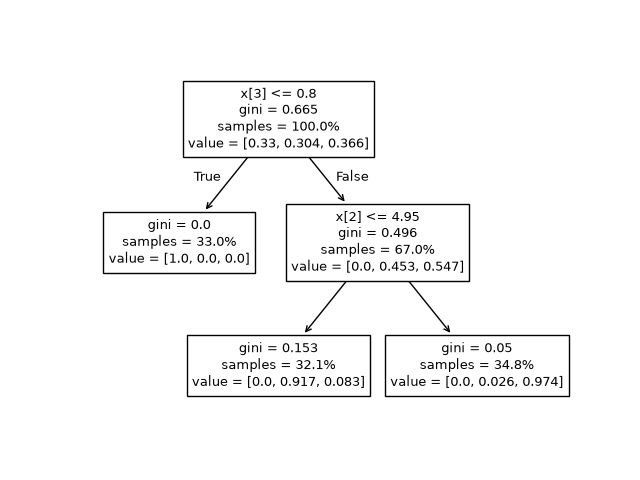 查看清晰大图
从顶部开始,满足阈值条件就向左,否则向右。图中 samples 是到达该节点的样本占全部训练样本的百分比,value 是节点内部各类别的比例;叶节点选择占比最大的类别作为预测。左侧纯叶节点的 Gini 为 0。这张 Iris 示例图有三个类别,下方手算例子则用两个类别。
算一次分裂
构造四个样本,数值特征 ,标签 。父节点两类各占一半,Gini 不纯度为:
在 处分裂,两边各只剩一种类别,子节点加权不纯度为零,改善量为 。若在 处分裂,左边一个样本是纯的,右边三例的类别比例为 。加权不纯度为 ,改善只有 。
from collections import Counter

def gini(labels):
    n = len(labels)
    return 1 - sum((count / n) ** 2 for count in Counter(labels).values())

x, y = [1, 2, 3, 4], [0, 0, 1, 1]
for threshold in (1.5, 2.5, 3.5):
    left = [label for value, label in zip(x, y) if value <= threshold]
    right = [label for value, label in zip(x, y) if value > threshold]
    score = (len(left) * gini(left) + len(right) * gini(right)) / len(y)
    print(threshold, round(gini(y) - score, 6))
这个例子的最优训练分裂很明显,却没有证明阈值会泛化。一直分下去的树可以把噪声样本各自隔离,训练纯度很好,留出预测很差。最小叶节点样本数、最大深度和剪枝都在限制这种行为。
树偏好怎样的输入关系
普通的轴对齐决策树每次只检查一个特征,连续分支可以表达交互。不过,斜向边界可能需要许多小矩形才能逼近,线性分类器却能用一个系数向量表达。因此,树与线性模型偏好的几何结构不同,不能简单按“强弱”排列。
对单个数值特征作单调缩放,通常不改变候选分裂的顺序,数值精度和实现细节除外。所以标准化不像距离聚类那样关键。但把无序类别随便编成整数,会引入本不存在的大小关系,应使用具体估计器支持的类别处理或合适编码。
回归树的叶节点通常输出均值。对于训练范围之外的输入,它仍会落入已有叶节点,而不会延伸一条斜线。这适合某些有界决策,却不擅长外推物理趋势。训练误差小,不代表输入翻倍时输出也会合理变化。
随机森林为什么要让树不同
Bagging 在重采样的数据上分别拟合模型,再聚合预测。随机森林还会在分裂时随机限制候选特征,降低树之间的相关性。集成学习文档解释了它与顺序提升的差别。
一个方差计算能说明多样性的作用。假设 棵树的预测误差方差都是 ,任意两棵的相关系数为 ,平均误差的方差为:
100 棵树、 时,平均后的方差仍有 。不断增加几乎相同的树,去不掉共同误差。这里假定方差和相关性相同,是机制解释,不是对任意森林成绩的保证。
Boosting 逐步修正预测
梯度提升依次增加模型,每一轮让新树逼近降低当前损失的方向。平方误差下,这个方向就是残差;其他目标使用各自的负梯度,不能一律理解为原始预测误差。
取目标 ,从均值预测 开始,残差为 。一个分开前两例和后两例的单层树可以拟合残差。收缩率 时:
预测变成 ,均方误差从 降到 。再修正一半,预测为 ,均方误差降到 。这是构造样本上的手算训练结果。真实数据含噪声,继续追逐残差未必有利,因此要根据验证集提前停止。
树深决定一次修正能表达哪些交互,轮数和学习率共同决定模型走多远。保持轮数不变,只减小学习率,可能只是欠拟合;应一起评估,不能把某个设置当作普遍稳妥的选择。
怎样公平比较表格模型
面对结构化数据,先让简单基线、正则化线性模型和一种树集成使用相同划分,以及预测时真正可获得的特征。避免同一实体或未来观测泄漏到训练中,编码也只能在训练折上拟合。
类别不平衡时,准确率可能奖励忽略稀有类别。应看分类型错误和概率质量;调整决策阈值有时比继续加树有效。叶节点类别频率与集成平均值,在部署人群变化后不会自动保持校准,见概率校准。
特征重要性也不是因果证明。相关特征会互相替代,类似编号的字段可能利用数据集偶然规律。扰动检查和分组错误分析有助于判断规则实际依赖什么。线性基线的统计假设与正则化,见普通最小二乘。