Arbres de décision, forêts aléatoires et gradient boosting
Un modèle linéaire additionne des contributions à coefficients fixes. Un arbre partitionne l’espace d’entrée : on suit des tests de seuil jusqu’à une feuille, puis on utilise sa prédiction. Il exprime facilement des règles conditionnelles, par exemple une longueur de requête pertinente seulement en présence d’une pièce jointe.
Le guide des arbres de scikit-learn décrit les séparations gloutonnes et le surapprentissage des arbres non contraints. Une séparation gloutonne maximise l’amélioration immédiate, sans explorer tous les arbres futurs.
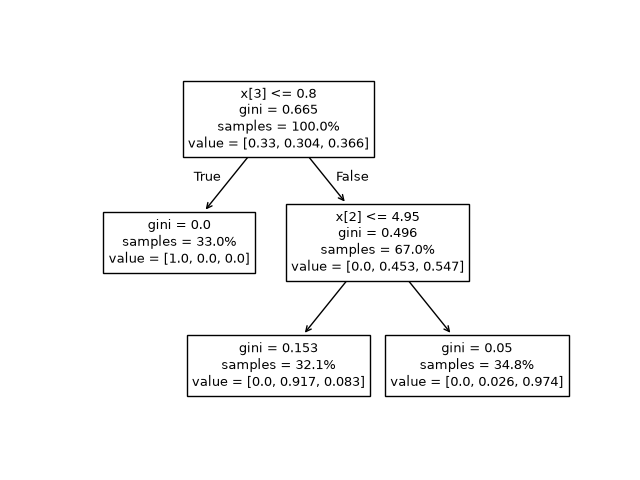 Voir l’image en grand
Partez du sommet : si le test est vrai, allez à gauche ; sinon, à droite. samples indique la part de tous les échantillons d’entraînement atteignant le nœud, et value les proportions de classes à l’intérieur de celui-ci. La feuille prédit la classe majoritaire. La feuille pure à gauche a un Gini nul. Cet exemple Iris comporte trois classes ; le calcul ci-dessous en utilise deux.
Calculer une séparation
Prenons quatre exemples fictifs, et . Le parent contient autant d’exemples de chaque classe. Son impureté de Gini vaut :
Un seuil de crée deux feuilles pures : impureté pondérée nulle, gain de . À , la feuille gauche contient un exemple pur et la droite trois exemples de proportions . L’impureté pondérée vaut , soit un gain de .
from collections import Counter

def gini(labels):
    n = len(labels)
    return 1 - sum((count / n) ** 2 for count in Counter(labels).values())

x, y = [1, 2, 3, 4], [0, 0, 1, 1]
for threshold in (1.5, 2.5, 3.5):
    left = [label for value, label in zip(x, y) if value <= threshold]
    right = [label for value, label in zip(x, y) if value > threshold]
    score = (len(left) * gini(left) + len(right) * gini(right)) / len(y)
    print(threshold, round(gini(y) - score, 6))
Le meilleur seuil d’entraînement ne prouve pas la généralisation. En poursuivant les séparations, on peut isoler chaque observation bruitée et obtenir une pureté parfaite avec de mauvaises prédictions nouvelles. Taille minimale des feuilles, profondeur et élagage limitent ce comportement.
La géométrie privilégiée par un arbre
Un arbre ordinaire aligné sur les axes teste une variable à la fois. Des branches successives expriment des interactions, mais une frontière diagonale peut nécessiter beaucoup de rectangles. Un classifieur linéaire représente parfois cette même diagonale avec un seul vecteur. Leurs préférences géométriques diffèrent.
Une transformation monotone d’une variable numérique préserve généralement l’ordre des seuils, sous réserve d’effets numériques et d’implémentation. La standardisation est donc moins centrale que pour un regroupement par distance. En revanche, coder arbitrairement des catégories non ordonnées avec des entiers introduit un ordre artificiel. Utiliser un encodage adapté ou le traitement catégoriel documenté.
Une feuille de régression prédit souvent une moyenne. Hors de la plage observée, l’entrée rejoint une feuille existante sans prolonger une pente. Cela convient à certaines décisions bornées, moins à l’extrapolation d’une tendance physique. Un bon ajustement ne prouve pas une extrapolation raisonnable.
Pourquoi diversifier les arbres d’une forêt
Le bagging entraîne sur des rééchantillonnages et agrège les prédictions. Une forêt aléatoire restreint aussi aléatoirement les variables candidates aux séparations afin de réduire la corrélation entre arbres. Le guide des ensembles distingue cette approche du boosting séquentiel.
Supposons erreurs de prédiction de variance et de corrélation commune . La variance de leur moyenne est :
Avec 100 arbres et , elle reste égale à . Ajouter des arbres presque identiques ne supprime pas leur erreur commune. Le calcul suppose variances et corrélations égales ; il explique le mécanisme sans garantir un résultat empirique.
Le boosting apprend des corrections
Le gradient boosting ajoute successivement des modèles qui approchent une direction réduisant la perte. Pour l’erreur quadratique, cette direction correspond aux résidus. D’autres objectifs utilisent leurs gradients négatifs, pas nécessairement les erreurs brutes.
Prenons les cibles et la prédiction initiale constante . Les résidus sont . Un arbre à une séparation peut les ajuster. Avec un taux :
Les prédictions deviennent et l’erreur quadratique moyenne passe de à . Une autre demi-correction donne et . Ce sont des calculs d’entraînement sur un exemple construit. Le bruit peut rendre la poursuite des corrections nuisible : d’où l’arrêt fondé sur la validation.
La profondeur règle les interactions exprimées par chaque correction ; nombre d’étapes et taux règlent ensemble l’amplitude totale. Réduire le taux sans ajouter d’étapes peut simplement sous-ajuster.
Comparer sur des données tabulaires
Comparer une référence simple, un modèle linéaire régularisé et un ensemble d’arbres sur la même partition et les mêmes informations disponibles à la prédiction. Éviter les fuites d’entités répétées ou d’observations futures. Ajuster les encodages uniquement sur les plis d’entraînement.
Avec des classes déséquilibrées, l’exactitude globale peut favoriser l’ignorance de la classe rare. Examiner erreurs par classe et qualité probabiliste ; changer le seuil peut aider davantage qu’ajouter des arbres. Fréquences dans les feuilles et moyennes d’ensemble ne restent pas automatiquement calibrées après un changement de population. Voir la calibration.
L’importance d’une variable n’établit pas une cause. Des variables corrélées se substituent ; des identifiants exploitent parfois des artefacts. Perturbations et erreurs par groupe aident à comprendre les dépendances du modèle. Les moindres carrés précisent les hypothèses du modèle linéaire de référence.