强化学习:奖励、价值与序列决策
监督学习的样本通常附带目标;强化学习中,Agent 先选动作,再观察后果并收到奖励。动作还会改变接下来遇到的情境,因此优化对象是一段过程,不能只看最近一步是否漂亮。
这一区别对工具型 Agent 很重要。少调用一次工具,可能节省当前时间,却把错误留到后面,花更多步骤补救。反过来,会调用工具也不代表用了强化学习:脚本流程或提示驱动的语言模型,都可以在不根据奖励更新策略的情况下行动。
 查看清晰大图
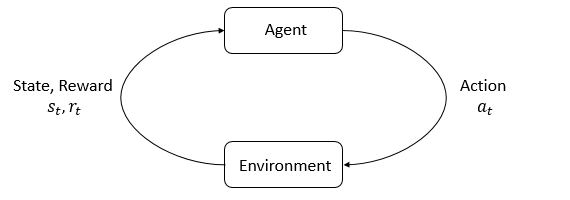
顺着环路看:智能体采取动作,环境发生变化,再返回状态和奖励,供下一步决策使用。动作会改变后续经历。图中写的是状态,实际任务可能只能观察到其中一部分;学习目标是整段过程的累计回报。
状态、动作、奖励和策略
马尔可夫决策过程描述状态、动作、转移概率和奖励。策略 决定给定状态下怎样选择动作。状态必须包含足够的信息,使下一状态和奖励的分布只取决于当前状态与动作,而不依赖未记录的历史。
对搜索文档的 Agent,状态可能包含问题、已找到的证据、剩余预算及尚未解决的矛盾。只保存最后一句用户输入,往往丢掉必要历史。部分可观测环境需要保留历史,或维护对隐藏状态的估计;把观察值命名为 state,并不能让马尔可夫假设自动成立。
从时刻 开始的折扣回报为:
折扣让更远的奖励权重更小;奖励有界时,也有助于无穷和收敛。有限回合如果任务合适,也可以使用不折扣的目标。 表示按某策略从状态出发的期望回报; 还固定了第一步动作。它们都不只是下一步奖励。
先检查,后获得收益
构造一个只有两个非终止状态的环境。在 start,选 quit 得到奖励 1 并结束;选 inspect 得到奖励 0,进入 ready;在 ready 选 finish 得到奖励 3 并结束。取 :
只看即时奖励会直接退出,但检查后的长期回报更高。如果检查本身要扣 2 分,其回报变为 ,退出反而符合当前目标。奖励和成本定义了问题,算法不会替人决定什么才叫成功。
Q-learning 把结果传回前面的选择
表格 Q-learning把一个状态—动作的估值,向“观察到的奖励加最佳后续估值”更新:
终止状态的后续价值为零。下面用固定顺序访问所有动作,展示价值如何往前传播。它没有实现探索策略,也不是神经网络强化学习跑分。
from math import isclose

q = {("start", "quit"): 0.0, ("start", "inspect"): 0.0,
     ("ready", "finish"): 0.0}
gamma, alpha = 0.9, 0.5
transitions = [
    ("start", "quit", 1.0, None),
    ("ready", "finish", 3.0, None),
    ("start", "inspect", 0.0, "ready"),
]
for _ in range(60):
    for state, action, reward, next_state in transitions:
        future = max((v for (s, a), v in q.items() if s == next_state), default=0.0)
        old = q[state, action]
        q[state, action] = old + alpha * (reward + gamma * future - old)
assert isclose(q["start", "inspect"], 2.7, abs_tol=1e-10)
assert q["start", "inspect"] > q["start", "quit"]
print({key: round(value, 3) for key, value in q.items()})
先观察到 finish 的奖励 3,后续更新再把价值传回 inspect。状态很多时,可以用神经网络近似价值,但简单表格例子的收敛表现,不能直接当成非线性函数近似的一般保证。
探索决定能获得哪些数据
如果 Agent 总是退出,就永远看不到检查后的奖励。探索让它尝试其他动作,避免策略被最早的判断困住。Epsilon-greedy 会偶尔随机选动作,不总采用最大估值;复杂环境还需要更仔细的探索方式。
动作会改变外部系统时,探索有实际代价。模拟器或回放环境可以提供训练条件,而不把真实用户当成任意试错对象。即使在模拟中,也要检查转移规则、奖励是否接近实际部署;策略可能很擅长利用模拟器漏洞。
离线强化学习只使用已有转移记录,覆盖范围就尤为重要。几乎全是 quit 的日志,很难说明 inspect 好不好。给没见过的动作很高估值,可能只是外推。行为克隆则直接用监督学习预测记录中的动作,可以模仿示范者,却不直接优化长期回报。
奖励是可以执行的目标定义
假设搜索助手每加一个引用就得一分,它可能堆积低质量引用;只奖励速度,它可能在查证前结束。这些例子说明代理指标可能偏离真实目的。应明确任务完成、证据质量和成本,再检查行为,不要只盯奖励曲线。
延迟奖励还带来归因困难:最终失败可能来自最早的搜索、错误中间假设,也可能来自最后表达。中间奖励能让学习更容易,但也会改变激励。应保留独立的最终任务成功指标,不能只把方便计算的训练信号加总后称作成功。
回合边界与评价
Gymnasium 的接口区分 terminated 和 truncated。任务真正终止时没有后续价值;若只是外部时间限制打断一个尚未结束的任务,计算目标时可能仍需估计后续价值。时间上限属于任务本身,还是采集程序的限制,决定了正确处理方式。
用留出的初始条件或任务评价策略,报告多次运行的变化,而不是只展示最好的一条轨迹。除了训练算力,还要计算环境交互次数和失败。与简单固定策略比较:这个小环境中若总选 inspect 就足够,学习一个策略不会比直接写规则带来部署优势。
语言模型中的奖励与偏好训练,见预训练与后训练。无论策略怎样获得,执行时都需要携带观察与动作的循环,见 Agent 循环。