Encoder、Decoder 与 Encoder–Decoder:信息怎样流动
比较 BERT、生成式语言模型和文本转换模型时,参数量只是一个维度。更先要问:一个位置能看见哪些输入?模型训练时预测什么?最后接了怎样的输出头?这三件事共同决定一个模型能否直接完成分类、检索或生成。
这里的 encoder 和 decoder 指 Transformer 家族中常见的组织方式。结构基础见 Transformer,输入编号与向量见 Tokenization。
从可见位置开始
假设输入有四个 token。标准双向 encoder 中,第 2 个位置可以读取第 1、2、3、4 个位置;标准 causal decoder 中,它只能读取第 1、2 个位置。这个约束通过注意力 mask 实现。
这是常见结构的比较,不是限制模型用途的定理。例如 decoder 可以接分类头;encoder 也可参与迭代填空生成;一些模型混用前缀 mask 或其他结构。判断具体产品时,应查模型定义,不能仅凭名字里的 BERT 或 GPT 推断全部行为。
 查看清晰大图
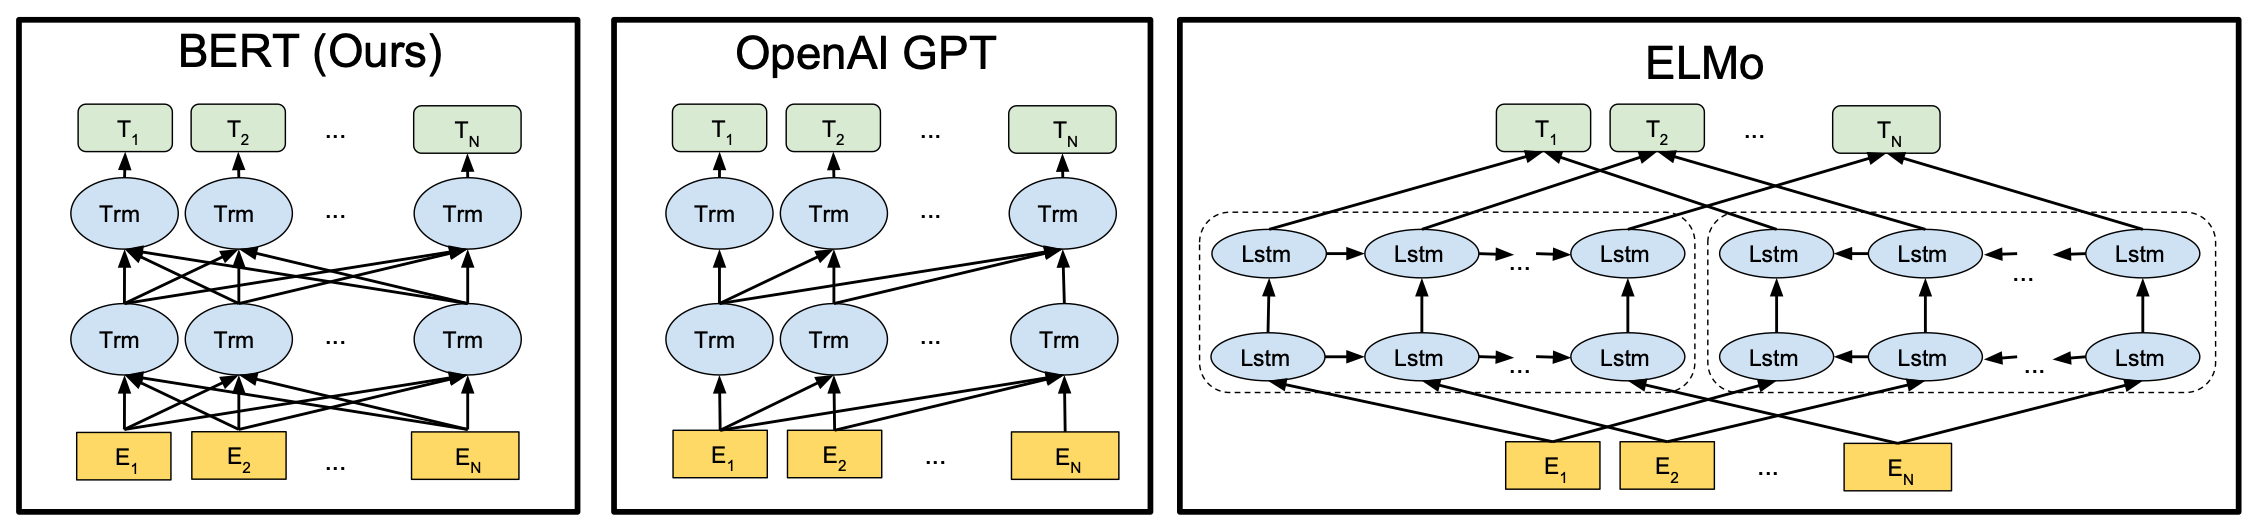
从底部黄色输入表示沿箭头往上看:BERT 在每层结合左右上下文,原版 GPT 只能看到当前位置及其之前的位置;ELMo 则拼接两个独立训练的单向 LSTM 表示。这张历史对照图解释上下文可见性,未包含 encoder–decoder 翻译架构。
Encoder 为什么适合“读完再判断”
BERT使用双向 Transformer 编码器,并通过遮盖词预测等目标预训练。隐藏某些输入后,模型借助左右文预测被遮盖内容,避免把预测目标原样看见。原始 BERT 还训练了下一句预测目标;这不是所有 encoder 的必备目标。
假设任务是把一条工单分到“账单、故障、其他”三类。输入经过 encoder 后得到 [batch,length,d]。选取约定的分类位置或池化表示,得到 [batch,d],再接一个线性分类头:
输出就是 [batch,3] 的类别分布,一次前向即可产生全部类别分数。这个例子说明的是结构:预训练 BERT 的任意隐藏向量并不会自动知道你的工单标签。分类头及必要的底座参数需要在匹配任务的数据上训练;概率还要经过校准与阈值选择。
换成 token 级头,可以给每个位置打实体标签;换成适合相似度的训练和池化,可以构造检索模型。即使底座相同,输出目标不同,模型也不能随便互换。这是比较本地 BERT 分类器、reranker 与 decision model 时,比“都是几亿参数”更有解释力的区分。
Decoder 为什么能逐步续写
因果语言模型用已经出现的 token 预测下一个 token。训练时将完整样本送进网络,并用 causal mask 阻止位置读取未来答案,因此许多位置的损失可以在一次前向中并行计算。推理时未来 token 尚不存在,通常要生成一个、追加一个,再继续计算。
对 BOS 我 喜欢 茶 EOS,训练可安排输入 BOS 我 喜欢 茶,对应目标 我 喜欢 茶 EOS。预测“茶”的位置可以读到 BOS 我 喜欢,但不能读到待预测的“茶”。不同库可能在模型内部移动 labels,使用时不能重复移位。
最后一个隐藏状态通过词表投影得到 [batch,V],每个值对应一个候选 token 的 logit。它不是一个完整答案的评分,也不等于“答案正确概率”。怎样从这一步形成文本见自回归生成与解码。
Encoder–decoder 把源序列与目标序列分开
原始 Transformer用于序列转换;T5把多种 NLP 任务写成文本到文本。假设源句长 5,目标已生成 3 个 token:encoder 先输出 [batch,5,d];decoder self-attention 在 3 个目标位置内按因果规则工作;cross-attention 的查询来自目标,键和值来自 5 个源表示。
因此,一张 cross-attention 分数图的末两维是 [3,5],不是 [3,3]。每个目标位置都可以读取完整源句,但不能读取未来目标。这解释了为什么“看得见完整输入”和“不能偷看未来答案”可以同时成立。
Encoder–decoder 的源表示可以供多个生成步骤重复使用。Decoder-only 则把指令、材料和输出放进一个序列,靠前缀来条件化生成。两种组织方式的参数分配、缓存和数据训练不同;不能仅从有几个模块推断谁在你的任务上更快或更准。
一个不需要训练的小检查
把四个输入位置编号为 0 到 3,手写两个可见矩阵:双向矩阵全为 1,因果矩阵只在列号不大于行号时为 1。现在将第 3 个 token 替换掉:在标准 encoder 里,较早位置的输出可以随之变化;在标准因果 decoder 里,较早位置不应因此变化。在真实模型测试时,应关闭 dropout,并保持位置、mask 和其他输入相同。
这个检查能发现 mask 错误,却不能证明训练效果。若一个分类系统在离线测试时能看到生产时拿不到的后续信息,即使模型结构没有问题,也发生了数据泄漏。
选型时从输出开始:固定少量标签先看分类器;候选对评分看 reranker;需要自由文本再看生成模型;有明确源到目标转换任务时考虑 encoder–decoder。然后比较任务数据、语言、长度、训练方式和实测成本。架构只是确定候选方案的起点,训练如何赋予能力见预训练与后训练。