Encoder, Decoder et Encoder–Decoder : circulation de l’information
Le nombre de paramètres ne suffit pas pour comparer BERT, un modèle génératif et un modèle de conversion de séquences. Il faut d’abord demander quelles positions sont visibles, ce que le modèle prédit pendant l’entraînement et quelle tête de sortie il possède. Ces choix déterminent son emploi immédiat pour la classification, la recherche ou la génération.
Encoder et decoder désignent ici des organisations courantes du Transformer. Voir les blocs Transformer pour les composants et la tokenisation pour les entrées.
Partir des positions visibles
Pour quatre tokens, la position 2 d’un encodeur bidirectionnel standard peut consulter les positions 1 à 4. Un décodeur causal standard lui donne accès uniquement aux positions 1 et 2. Le masque d’attention impose cette contrainte.
Ce sont des architectures courantes, pas des interdictions théoriques. Un décodeur peut recevoir une tête de classification ; un encodeur peut participer à une génération par remplissage itératif ; des modèles utilisent des masques de préfixe ou des structures hybrides. Le nom BERT ou GPT ne remplace pas la définition du modèle.
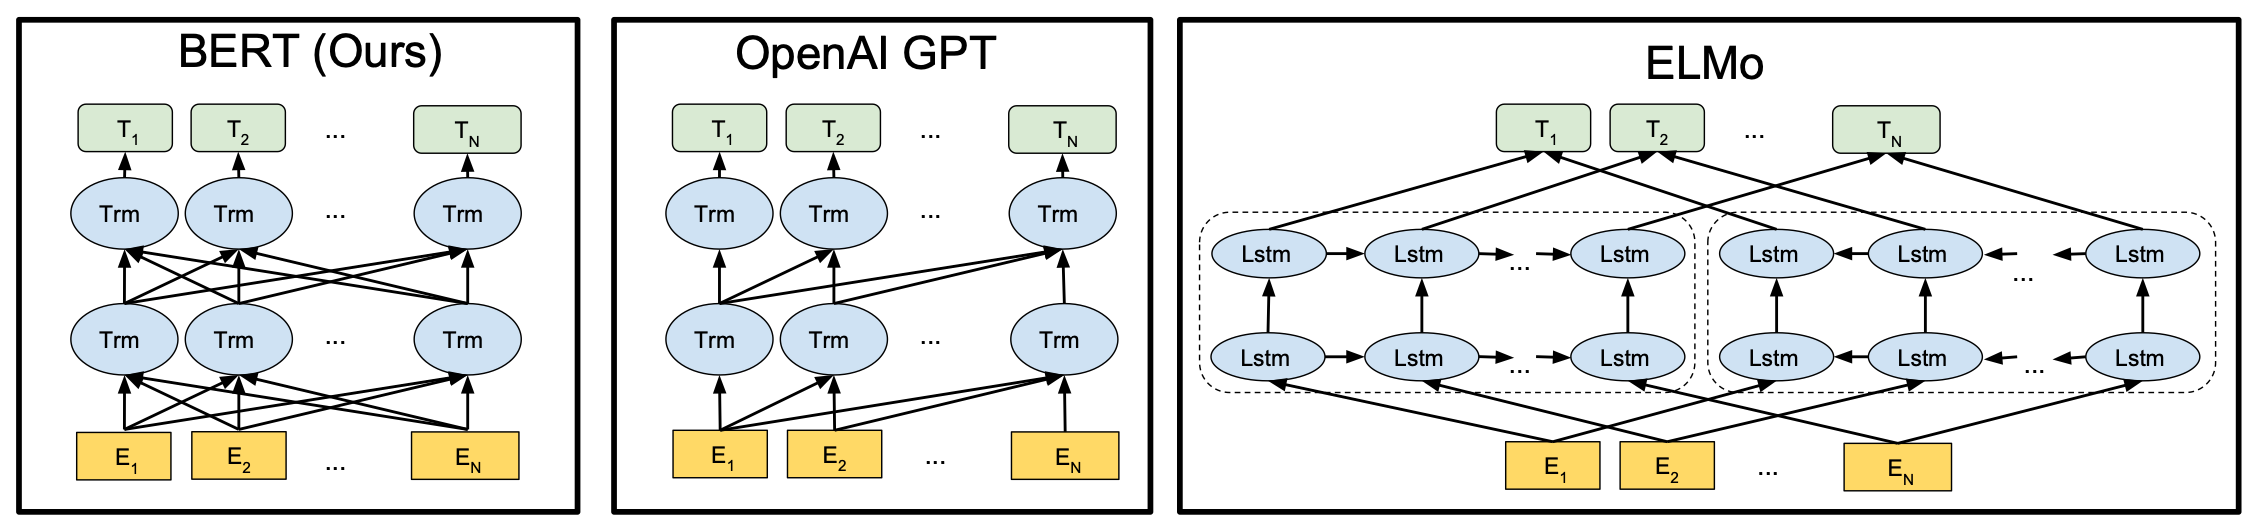 Voir l’image en grand
Suivez les flèches depuis les entrées jaunes. BERT combine les deux directions à chaque couche ; le GPT original voit sa position et les précédentes. ELMo réunit deux LSTM entraînés séparément. Cette comparaison historique illustre l’accès au contexte, sans représenter une architecture de traduction encodeur–décodeur.
L’encodeur lit avant de décider
BERT préentraîne un encodeur bidirectionnel, notamment en prédisant des tokens masqués. Le contenu caché peut être prédit à partir des deux côtés sans être directement visible. BERT utilisait aussi une prédiction de phrase suivante, objectif qui n’est pas obligatoire pour tous les encodeurs.
Pour classer un ticket en « facturation », « panne » ou « autre », l’encodeur produit [batch,length,d]. Une position dédiée ou une agrégation fournit [batch,d], puis une tête linéaire calcule :
La sortie [batch,3] contient tous les scores en une passe. Cet exemple illustre la structure : un vecteur BERT préentraîné arbitraire ne connaît pas spontanément les catégories de tickets. La tête et, si nécessaire, le modèle de base doivent apprendre sur des données adaptées ; les probabilités demandent une calibration et des seuils.
Une tête par token peut prédire des étiquettes d’entités. Un objectif de similarité et une agrégation adaptés peuvent produire des représentations de recherche. Un même modèle de base ne rend pas ces tâches interchangeables. Cette distinction explique mieux les classifieurs BERT locaux, rerankers et modèles de décision que leur simple taille.
Le décodeur prolonge une séquence
Un modèle causal prédit le token suivant à partir de ceux déjà présents. Pendant l’entraînement, l’exemple entier peut entrer dans le réseau ; un masque causal cache les réponses futures. Les pertes de nombreuses positions sont donc calculables en parallèle. En inférence, les tokens futurs n’existent pas encore : on produit normalement un token, on l’ajoute, puis on recommence.
Pour BOS je préfère thé EOS, une disposition utilise l’entrée BOS je préfère thé avec les cibles je préfère thé EOS. La position qui prédit « thé » peut lire BOS je préfère, mais pas la cible « thé ». Certaines bibliothèques décalent les étiquettes en interne ; il ne faut pas effectuer deux décalages.
La projection sur le vocabulaire transforme le dernier état en logits [batch,V], un par token candidat. Ce ne sont ni des scores de réponses entières ni des probabilités de vérité. La génération autorégressive explique la boucle de production.
Encoder–decoder sépare source et cible
Le Transformer original transforme des séquences ; T5 formule de nombreuses tâches NLP comme des transformations texte-vers-texte. Supposons une source de 5 tokens et un préfixe cible de 3 tokens. L’encodeur produit [batch,5,d]. L’auto-attention du décodeur reste causale sur les 3 positions cibles. L’attention croisée prend ses requêtes dans la cible, et ses clés et valeurs dans les 5 états sources.
Les deux dernières dimensions de ses scores sont donc [3,5], et non [3,3]. Chaque position cible peut consulter toute la source, sans voir la cible future. Lire toute l’entrée reste compatible avec l’interdiction de consulter la réponse future.
Les états sources peuvent être réutilisés à chaque étape. Un decoder-only place plutôt instructions, documents et sortie dans une seule séquence conditionnée par son préfixe. Répartition des paramètres, cache et entraînement diffèrent. Compter les modules ne suffit pas pour prévoir vitesse ou précision.
Vérifier la visibilité simplement
Numéroter quatre positions de 0 à 3. Écrire une matrice bidirectionnelle remplie de 1, puis une matrice causale avec 1 seulement lorsque l’indice de colonne ne dépasse pas celui de ligne. Remplacer le token 3 : les premières sorties d’un encodeur peuvent changer ; celles d’un décodeur causal standard ne devraient pas changer. Sur un modèle réel, désactiver dropout et conserver positions, masques et autres entrées.
Ce test détecte une erreur de masque, pas un entraînement réussi. Une classification évaluée avec des informations ultérieures indisponibles en production subit malgré tout une fuite de données.
Partir du résultat demandé : quelques étiquettes fixes orientent vers un classifieur ; des paires à noter vers un reranker ; du texte libre vers un générateur ; une conversion explicite de source en cible peut convenir à encoder–decoder. Comparer ensuite données, langues, longueurs, entraînement et coût mesuré. L’architecture délimite les candidats ; le préentraînement et post-entraînement expliquent l’acquisition des capacités.