Ingénierie du contexte pour les agents
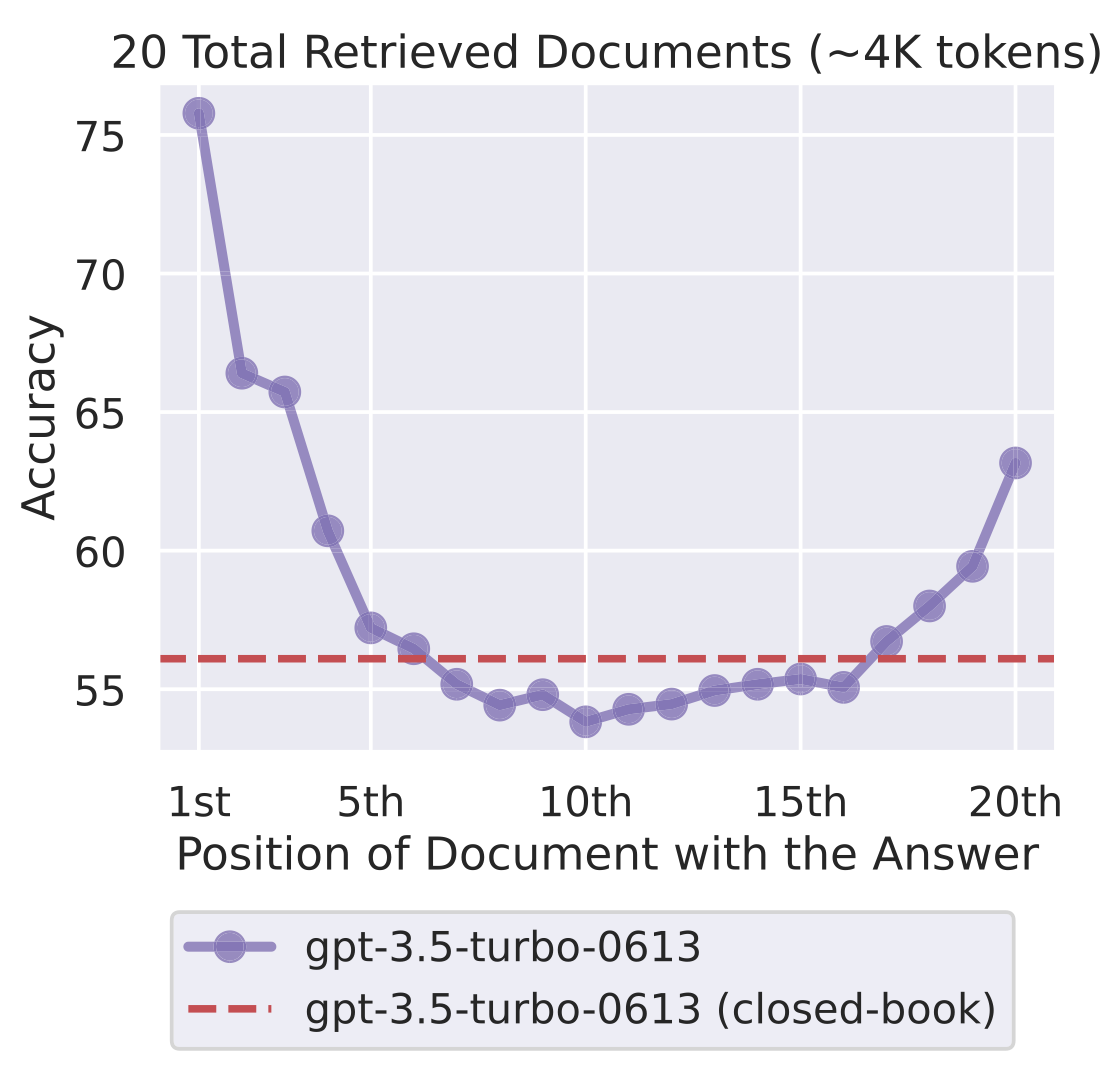
L’ingénierie du contexte consiste à choisir les instructions, fichiers et résultats récents nécessaires à la prochaine action d’un agent, tout en maintenant des documents durables plutôt qu’en comptant sur le seul prompt. La fenêtre de contexte limite la quantité d’informations que le modèle peut recevoir à la fois ; elle ne garantit pas qu’il les exploitera toutes correctement. Lost in the Middle montre, par exemple, que la qualité de récupération peut dépendre de la position de l’information dans une longue entrée. L’objectif est de fournir des éléments pertinents et à jour, pas de remplir la fenêtre.
Cette page traite de l’ensemble de travail d’une tâche : ce que le modèle doit voir maintenant et ce qui peut rester hors de sa fenêtre. Recherche documentaire : découpage, rappel, reclassement et citations couvre la découverte des candidats ; Mémoire des agents : conservation, révision et péremption, la conservation et la révision entre tâches.
 Voir l’image en grand
L’axe horizontal déplace le passage contenant la réponse parmi 20 documents, soit environ 4 000 tokens. L’axe vertical mesure la précision des réponses, pas le rappel du moteur de recherche. Dans cette expérience avec GPT-3.5-Turbo-0613, les positions centrales donnent de moins bons résultats que les extrémités ; les pointillés représentent les réponses sans documents. Ce résultat invite à tester la position des preuves avec le modèle utilisé, sans généraliser cette courbe historique à tous les modèles.
Exemple de paquet de tâche
Un paquet de tâche est une consigne compacte pour l’agent : ce que cette étape peut modifier, ce qui compte comme réussite, ce qui a déjà été tenté, quel code regarder et ce qui reste à trancher. Pour un analyseur qui échoue sur une séquence UTF-8 coupée, un paquet utile pourrait être :
contract:
  write_scope: [src/parser.py, tests/test_parser.py]
  success: targeted test and parser suite pass
state:
  attempted: boundary check after byte slicing
  result: still fails on a split multibyte code point
working_set:
  - parser function and two callers
  - three relevant tests
  - exact traceback
open_question: should truncation operate on bytes or Unicode code points?
Le dépôt entier, le journal de tests complet et toutes les hypothèses antérieures seraient plus volumineux, mais pas nécessairement plus utiles.
Ce qui doit figurer dans le contexte
Le contenu du contexte se répartit en cinq couches. Ce ne sont pas des étapes successives : elles coexistent et diffèrent par leur stabilité.
Les quatre premières couches peuvent entrer dans le prompt. L’état durable reste hors du prompt ; les éléments nécessaires y sont réintroduits au besoin. Une transcription est un historique d’interaction, pas la source de vérité du projet.
Sélectionner avant de compresser
Recherchez des symboles, sites d’appel, tests, définitions et preuves exactes avant de demander à un modèle de résumer quoi que ce soit. Un résumé ne peut pas retrouver un élément qui n’a jamais été récupéré, et des résumés répétés peuvent transformer discrètement une supposition en fait.
L’entrée que l’on peut placer vaut la limite du modèle, moins la place réservée à la sortie, moins ce qu’occupent les définitions d’outils et les schémas, moins une marge de sécurité :
Avec des chiffres : une fenêtre de 128K tokens, 8K réservés à la sortie, 6K pour les définitions d’outils et une marge de 4K donnent 128K − 8K − 6K − 4K = 110K, soit environ 110K tokens d’entrée.
Il n’existe pas de pourcentage universel pour les règles, les preuves et la sortie. C’est l’action suivante qui doit déterminer le paquet. Les modèles locaux doivent aussi compter avec le cache KV : les résultats intermédiaires que le modèle conserve pour chaque token déjà lu, qui occupent de plus en plus de mémoire à mesure que le contexte s’allonge. Les modèles locaux peuvent donc atteindre les limites du cache KV ou de mémoire avant que la limite de contexte annoncée ne devienne exploitable.
Comment garder l’ensemble de travail réduit
Le cache de prompt fonctionne au mieux lorsque les instructions et schémas réellement stables restent inchangés. Les économies exactes dépendent du fournisseur, du modèle, de la forme de la requête et de la politique de cache ; mesurez-les plutôt que de reprendre un pourcentage accrocheur.
Les sorties volumineuses doivent être stockées intégralement et représentées dans le contexte par un extrait utile et une référence à l’artefact. Ne conserver que le début et la fin est une option, non la garantie que la ligne importante subsiste.
Compresser sans blanchir l’incertitude
Un résumé doit conserver :
- la source ou l’artefact étayant une affirmation ;
- si l’énoncé a été observé, déduit ou seulement proposé ;
- les tentatives échouées qui évitent de les répéter ;
- les contradictions non résolues ;
- la prochaine décision, et non chaque tour de conversation.
Un état structuré est souvent plus facile à examiner qu’un récapitulatif rédigé, mais il n’est pas juste automatiquement. Mettez-le à jour de façon atomique lorsque c’est possible et comparez-le aux fichiers actuels lors de la reprise.
Tester une stratégie de contexte
Déplacez les mêmes preuves entre le début, le milieu et la fin. Ajoutez des documents non pertinents et contradictoires. Incluez un cas où la bonne réponse est « preuves insuffisantes ». Mesurez la réussite de la tâche, les contraintes manquées, l’attribution, la latence et l’usage de tokens.
Cinq échecs reviennent souvent dans ces tests. Dans l’exemple de l’analyseur UTF-8, ils se présentent ainsi :
Le remède consiste généralement à retirer le contenu non pertinent, à récupérer de meilleures preuves ou à sortir l’état durable du prompt.