信息论与熵
信息论为量化不确定性和通信极限提供了一套标准语言。建议按以下顺序构建这一知识分支:
- 自信息与熵;
- 联合熵与条件熵;
- 互信息与独立性;
- 交叉熵与 Kullback–Leibler 散度;
- 信源编码与压缩极限;
- 噪声信道与信道容量;
- 与概率建模及机器学习目标的关联。
下面的速查限定于有限离散分布,以及它们在编码和预测中的用途。先掌握概率、条件概率与期望。MIT OpenCourseWare 6.050J 则继续讲解上述通信与物理系统主题。
自信息与平均不确定性
概率为 的结果,其自信息为 比特。独立结果的概率相乘,对应的信息量相加。必然发生的结果携带零比特信息,概率为 的结果携带 3 比特。这衡量的是模型下的意外程度,不是真实性、用途或语义。
若随机变量 的概率为 ,熵就是自信息的期望:
若有 种可能结果,则 ,均匀分布取得最大值。公平硬币的熵为 1 比特;概率为 的偏置硬币,熵约为 比特。较少见结果的自信息是 2 比特,但熵要对两种结果加权平均。
条件熵与共享信息
联合熵衡量数对 的不确定性。条件熵则对观察 后 剩余的不确定性取平均:
互信息 非负,且仅在 独立时为零。平均而言,条件化不会增加熵,但某次特定观测可能增加不确定性。若 是公平硬币且 ,则 , 比特。若是两枚独立的公平硬币,则 ,。存在依赖关系本身不能证明因果关系。
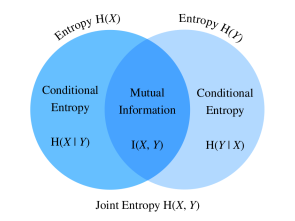 查看清晰大图
对两个有限离散变量,中间的重叠部分表示共享信息。平均而言,知道 X 后,Y 的不确定性减少了这部分,右侧剩余区域就是条件熵 H(Y | X)。区域展示的是熵的分解关系,不是取值集合的交集。原图的 I(X, Y) 与本文的 I(X; Y) 表示同一个量。
交叉熵与模型偏差
设 是真实分布, 是同一组结果上的预测分布。采用以 2 为底的对数,有:
的项贡献为零,求和时略去。若某处 而 ,交叉熵和 KL 散度均为无穷大。否则 KL 散度非负,只有两分布一致时才为零。它不是距离度量:通常不对称,也不满足三角不等式。
例如 、 时,交叉熵为 1 比特,KL 散度约为 比特。因为 固定,对 最小化交叉熵就等于最小化 KL 散度。在分类任务中,对观测标签求 的平均值,可估计期望对数损失;使用自然对数时,单位是纳特而非比特。训练损失低,并不能单独说明模型在新数据上的表现。
熵如何约束压缩?
对于已知的有限信源分布,最优二进制前缀码的平均码长 满足 。熵是平均下界,不承诺每个符号都能用小数位比特编码。对偏置硬币逐个符号使用二进制前缀码,仍需每个符号一比特。若符号独立同分布,对长度为 的块编码,可把每个符号相对熵的额外开销降至 比特以下。相关信源需要利用条件结构或熵率,单符号熵未必是最佳的每符号极限。
连续变量需要另行处理:微分熵依赖坐标,可以为负,因此不能直接解释为存储一个实数所需的比特数。讨论这类存储成本前,必须先指定精度。