Apprentissage par renforcement : récompenses, valeur et décisions séquentielles
En apprentissage supervisé, un exemple possède généralement une cible. En apprentissage par renforcement, l’agent choisit une action, observe ses conséquences et reçoit une récompense. L’action change parfois les situations futures : l’objectif doit donc évaluer une séquence, pas seulement le dernier choix.
Pour un agent utilisant des outils, économiser un appel peut provoquer une erreur coûteuse plus tard. Mais appeler un outil ne signifie pas utiliser le renforcement : un script ou un modèle guidé par une consigne peut agir sans mettre à jour sa politique à partir des récompenses.
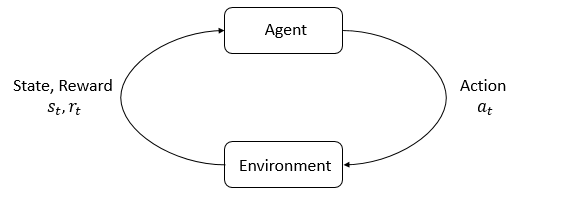 Voir l’image en grand
Suivez la boucle : action, évolution de l’environnement, puis retour de l’état et de la récompense. L’action influence les expériences suivantes. En pratique, l’état peut n’être que partiellement observable ; l’apprentissage vise le retour cumulé.
État, action, récompense et politique
Un processus de décision markovien décrit états, actions, transitions et récompenses. La politique détermine le choix d’action. L’état doit contenir assez d’information pour que la distribution du prochain état et de la récompense dépende de lui et de l’action, plutôt que d’un historique oublié.
Pour un agent documentaire, cela peut inclure question, preuves recueillies, budget restant et contradictions non résolues. Le seul dernier message peut être insuffisant. Une observation partielle demande un historique ou une estimation de l’état caché ; renommer l’observation « état » ne rend pas l’hypothèse markovienne vraie.
Le retour actualisé depuis est :
L’actualisation diminue le poids du futur et rend cette somme finie pour des récompenses bornées. Un épisode fini peut aussi utiliser un objectif non actualisé. représente le retour espéré sous une politique ; fixe en plus la première action. Ce n’est pas simplement la récompense suivante.
Un bénéfice différé
Construisons deux états non terminaux. À start, quit rapporte 1 et termine l’épisode. inspect rapporte 0 et mène à ready, où finish rapporte 3 avant de terminer. Avec :
Maximiser la récompense immédiate ferait quitter, alors qu’inspecter offre un meilleur retour. Si inspecter coûte 2 unités, son retour devient et quitter devient optimal pour cet objectif. Récompenses et coûts définissent le problème ; l’algorithme ne choisit pas le sens de la réussite.
Q-learning propage le résultat
Le Q-learning tabulaire rapproche une estimation de la récompense observée augmentée de la meilleure continuation estimée :
La continuation vaut zéro après une transition terminale. Cet exemple à bibliothèque standard visite toutes les actions dans un ordre fixe. Il montre la propagation de valeur, sans stratégie d’exploration ni benchmark neuronal.
from math import isclose

q = {("start", "quit"): 0.0, ("start", "inspect"): 0.0,
     ("ready", "finish"): 0.0}
gamma, alpha = 0.9, 0.5
transitions = [
    ("start", "quit", 1.0, None),
    ("ready", "finish", 3.0, None),
    ("start", "inspect", 0.0, "ready"),
]
for _ in range(60):
    for state, action, reward, next_state in transitions:
        future = max((v for (s, a), v in q.items() if s == next_state), default=0.0)
        old = q[state, action]
        q[state, action] = old + alpha * (reward + gamma * future - old)
assert isclose(q["start", "inspect"], 2.7, abs_tol=1e-10)
assert q["start", "inspect"] > q["start", "quit"]
print({key: round(value, 3) for key, value in q.items()})
La récompense de finish est d’abord découverte, puis sa valeur remonte vers inspect. Pour de grands espaces d’états, un réseau peut approximer les valeurs ; le comportement de cette petite table ne garantit pas la convergence générale d’une approximation non linéaire.
L’exploration détermine les données obtenues
Un agent qui quitte toujours n’observe jamais le bénéfice de l’inspection. Explorer permet de dépasser sa première estimation. Une règle epsilon-greedy choisit parfois une action aléatoire plutôt que la plus grande valeur estimée ; des environnements complexes demandent des stratégies plus élaborées.
L’exploration coûte réellement lorsque les actions modifient des systèmes externes. Simulation et rejeu permettent de s’entraîner sans imposer des essais arbitraires aux utilisateurs. Même en simulation, vérifier la pertinence des transitions et récompenses : une politique peut exploiter un bug du simulateur.
Le renforcement hors ligne utilise des transitions déjà enregistrées. Leur couverture devient essentielle : des journaux dominés par quit disent peu sur inspect. Une valeur élevée attribuée à une action inconnue peut être une extrapolation. Le clonage comportemental prédit plutôt les actions enregistrées par apprentissage supervisé, sans optimiser directement le retour à long terme.
La récompense définit un objectif opérationnel
Récompenser chaque citation peut produire une multitude de citations médiocres. Récompenser seulement la rapidité peut pousser à finir avant vérification. Ces exemples montrent comment un indicateur peut diverger du besoin. Définir réussite, qualité des preuves et coûts, puis inspecter le comportement autant que la courbe de récompense.
Un signal tardif complique l’attribution : un échec final peut venir de la première recherche, d’une hypothèse intermédiaire ou de la réponse. Des récompenses intermédiaires facilitent l’apprentissage, mais changent aussi les incitations. Conserver une mesure indépendante de réussite finale, au-delà de la somme des signaux pratiques d’entraînement.
Frontières des épisodes et évaluation
L’interface Gymnasium distingue terminated et truncated. Un état réellement terminal n’a pas de continuation ; une simple limite de temps externe peut interrompre une tâche encore active, dont il faut parfois estimer la valeur future. Le traitement dépend de la présence de l’horizon dans la tâche elle-même ou seulement dans le dispositif de collecte.
Évaluer sur des conditions initiales ou tâches réservées et présenter la variation entre exécutions, pas seulement la meilleure trajectoire. Compter interactions et échecs autant que calcul d’entraînement. Comparer à une politique fixe : si toujours choisir inspect suffit dans cet exemple, apprendre une politique n’apporte aucun avantage de déploiement sur cette règle.
Pour récompenses et préférences des modèles de langage, voir le préentraînement et post-entraînement. Pour la boucle d’exécution transportant observations et actions, indépendamment de l’origine de la politique, voir les boucles d’agents.